Le schéma n'est pas un levier de citation, c'est une infrastructure d'entité

Le schéma est l'un des sujets qui fait le plus débat dans la communauté SEO et GEO. Les questions qui concernent son impact sur les citations et les mentions sont nombreuses et beaucoup affirment que ce levier n'a aucun impact direct confirmé.
Dans notre analyse des facteurs de citation de Cyrus Shepard, nous avions justement placé le schéma aux côtés du llms.txt avec une pondération assez faible par rapport à de nombreux autres critères.
Les études de cas se sont également multipliées sur ce sujet et la principale vient d'Ahrefs et plus précisément de Louise Linehan et Xibeijia Guan, qui ont réalisé un test sur 1 885 pages comparées à 4 000 pages témoins.
Les résultats sont assez parlants, une hausse de 2,4 % sur AI Mode et de 2,2 % sur ChatGPT, une progression résiduelle que l'on n'attribue pas au schéma directement. Une baisse constatée, côté AI Overviews, qui représente un recul faible mais tout de même significatif. La conclusion portée par ces chiffres est que les schémas n'impactent pas le taux de citation sur les moteurs IA.
La première étude qu'Ahrefs avait pourtant menée sur le schéma révélait que sur 6 millions de pages 53% portaient du JSON LD représentant 3 fois plus que les pages non citées. Cette corrélation ne prouve rien pour autant sur l'impact du JSON car un site optimisé avec du schéma l'est probablement aussi pour d'autres facteurs.
La réponse à cette question ne se situe pas où on la cherche en premier, elle est davantage dans le travail sur l'entité qui est effectué en amont de la réponse générée par l'IA, ce qui alimente entre autres la mémoire des modèles.
Il faut voir cela comme un code de référence, semblable à ceux que nous utilisons sur les produits afin de les identifier. Ce processus ne cherche pas à booster les ventes directement, il reste cependant un point de repère essentiel pour distinguer une entité et ce qu'elle est.
Ce que l'étude a mesuré et ce qu'elle n'a pas considéré
Avant d'approfondir sur le sujet, nous allons revenir sur l'étude d'Ahrefs et les aspects sur lesquels elle doit être remise en question.
Sur le principe, l'étude est correcte, mais trois limites en ressortent :
- Les pages testées recevaient déjà des citations avant même l'intégration de données structurées (au moins 100 citations sur les AI Overviews en février 2025). L'étude ne dit donc pas ce qu'il en est des pages non découvertes ou jamais citées.
- 30 jours est une période trop restreinte pour une prise en compte efficace des balises schéma dans un graphe de connaissances. Nous avions vu dans un article précédent que c'est un des processus les plus longs et les plus difficiles à maîtriser.
- Cette étude mélange plusieurs types de schémas qui n'ont pas le même rôle. Le balisage Organization présente une entité alors que le balisage Article décrit un contenu.
Un point de nuance important à retenir est que le JSON LD n'est pas lu par les modèles au moment de la récupération. Ahrefs renvoie directement à l'expérience de searchVIU qui montre lors d'une lecture en direct que seul le HTML visible est pris en compte.
Les trois moments où le schéma entre en jeu
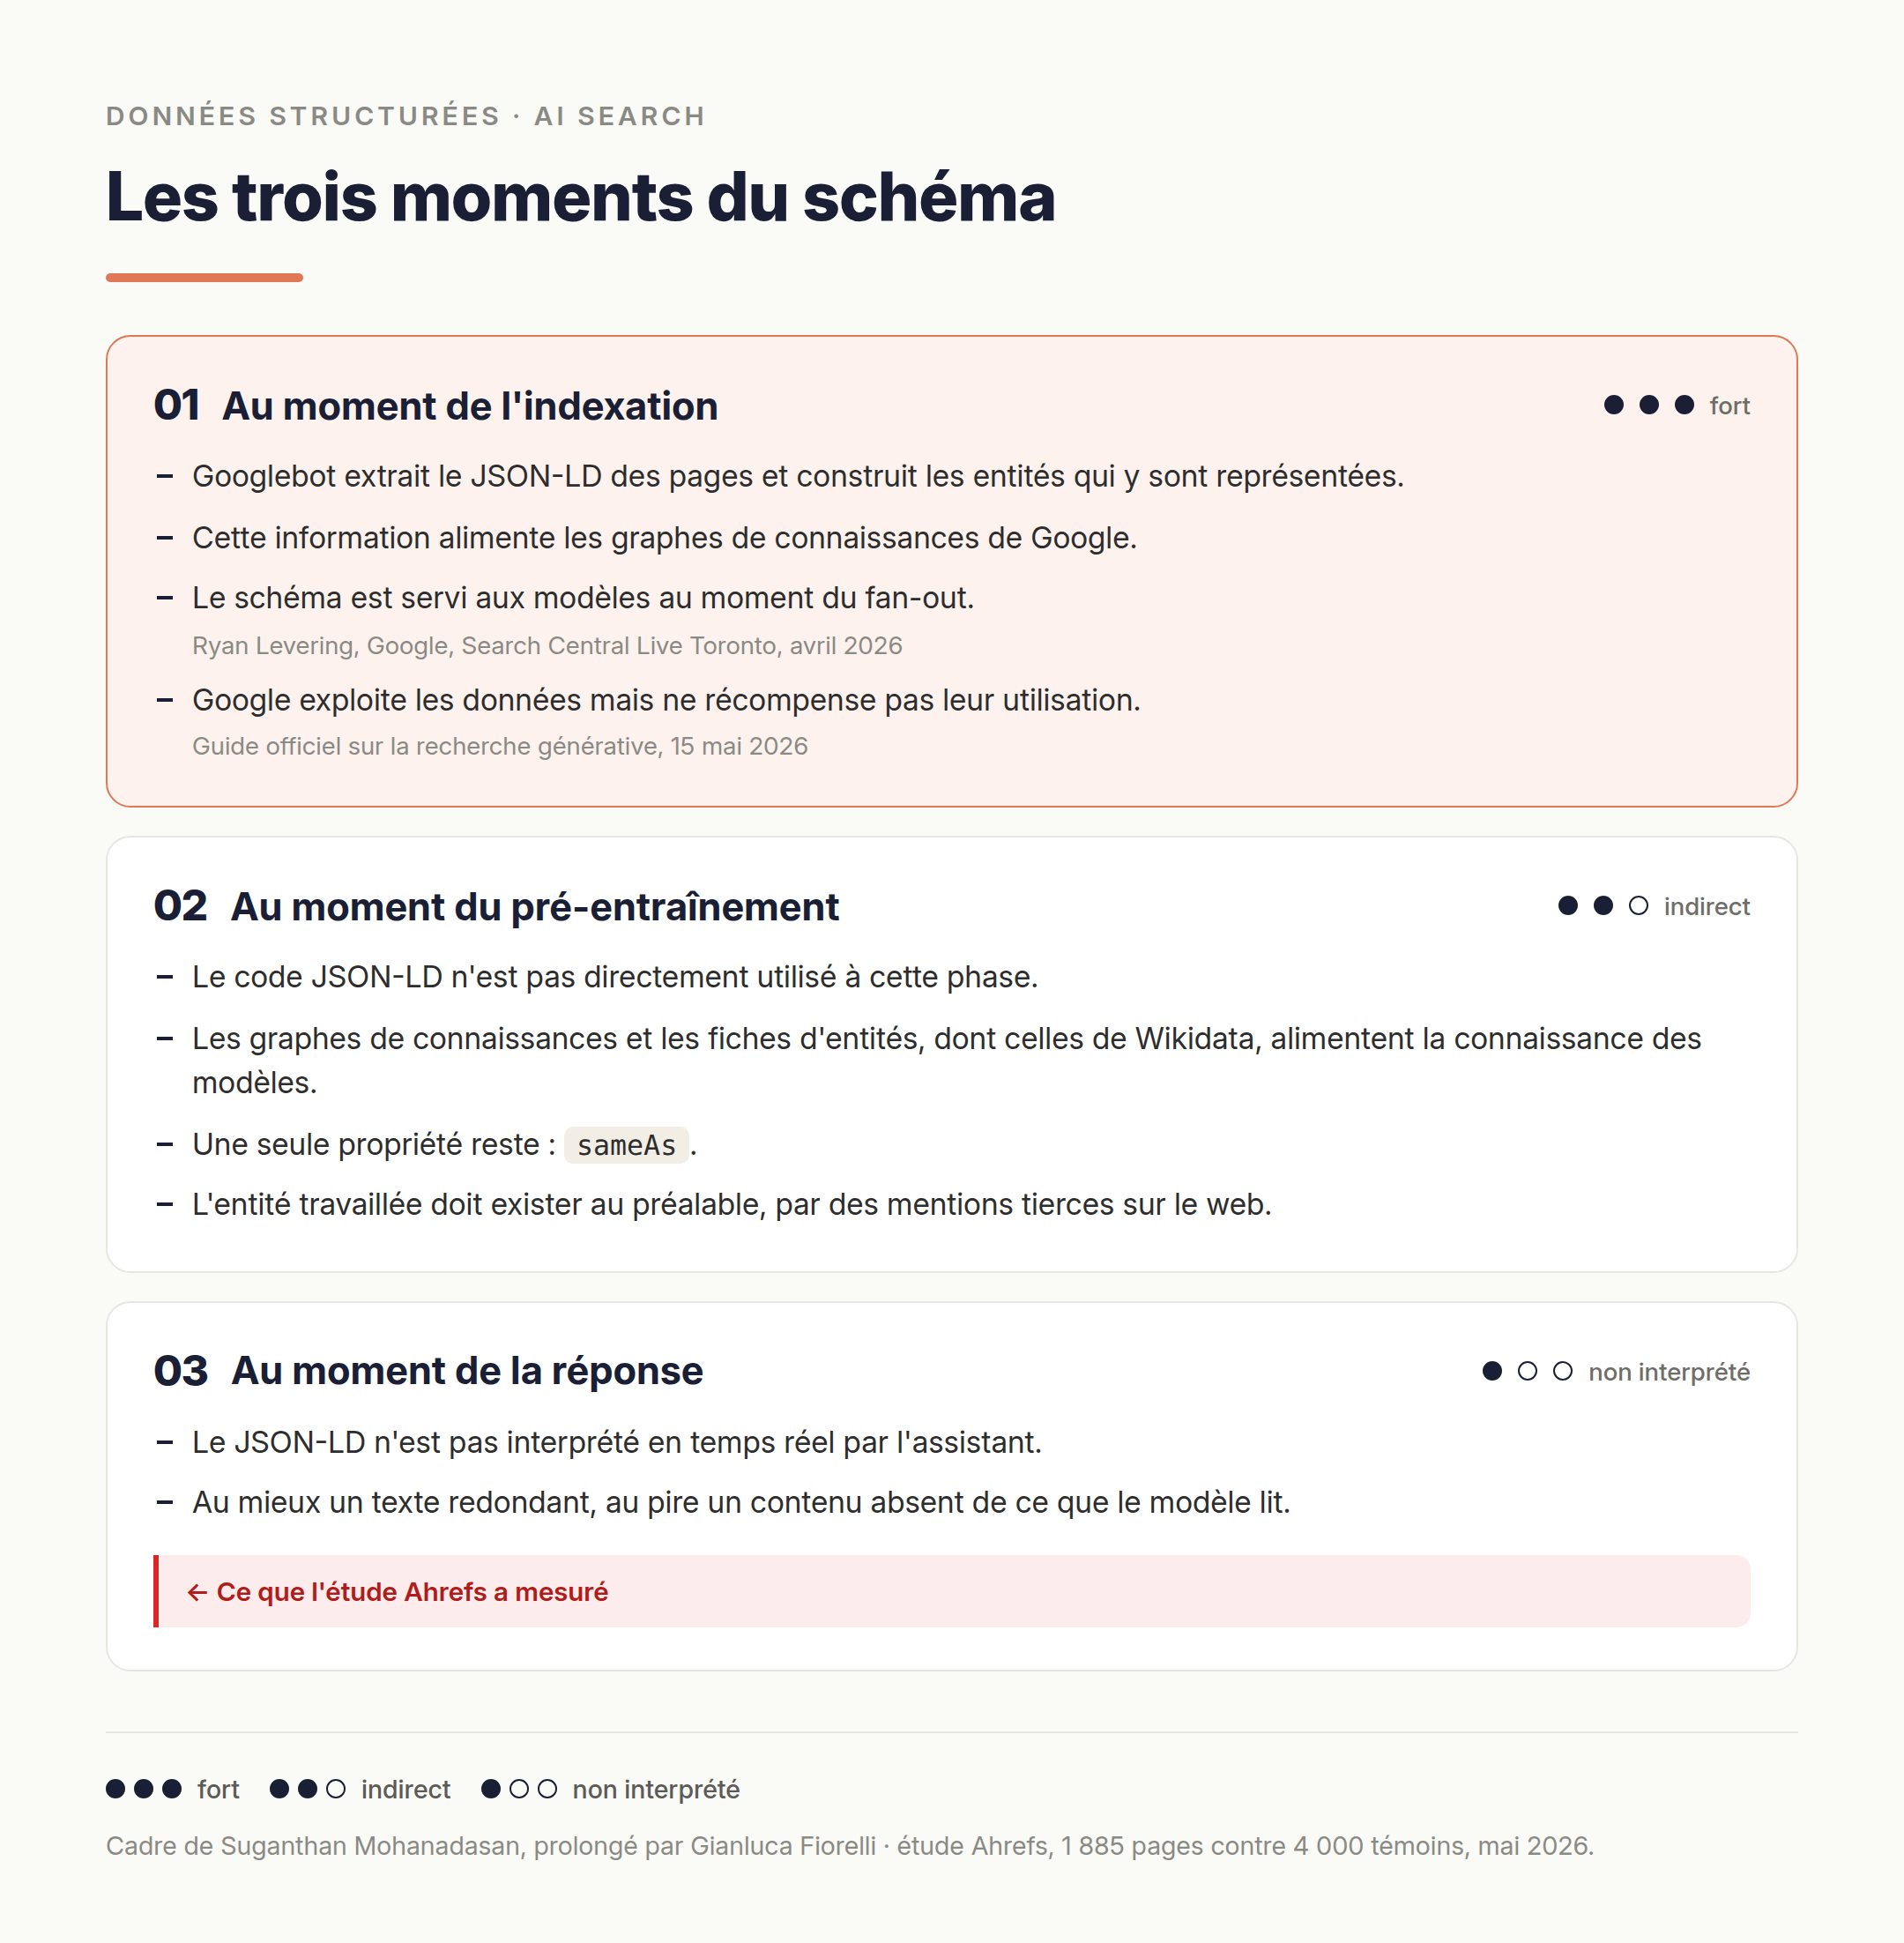
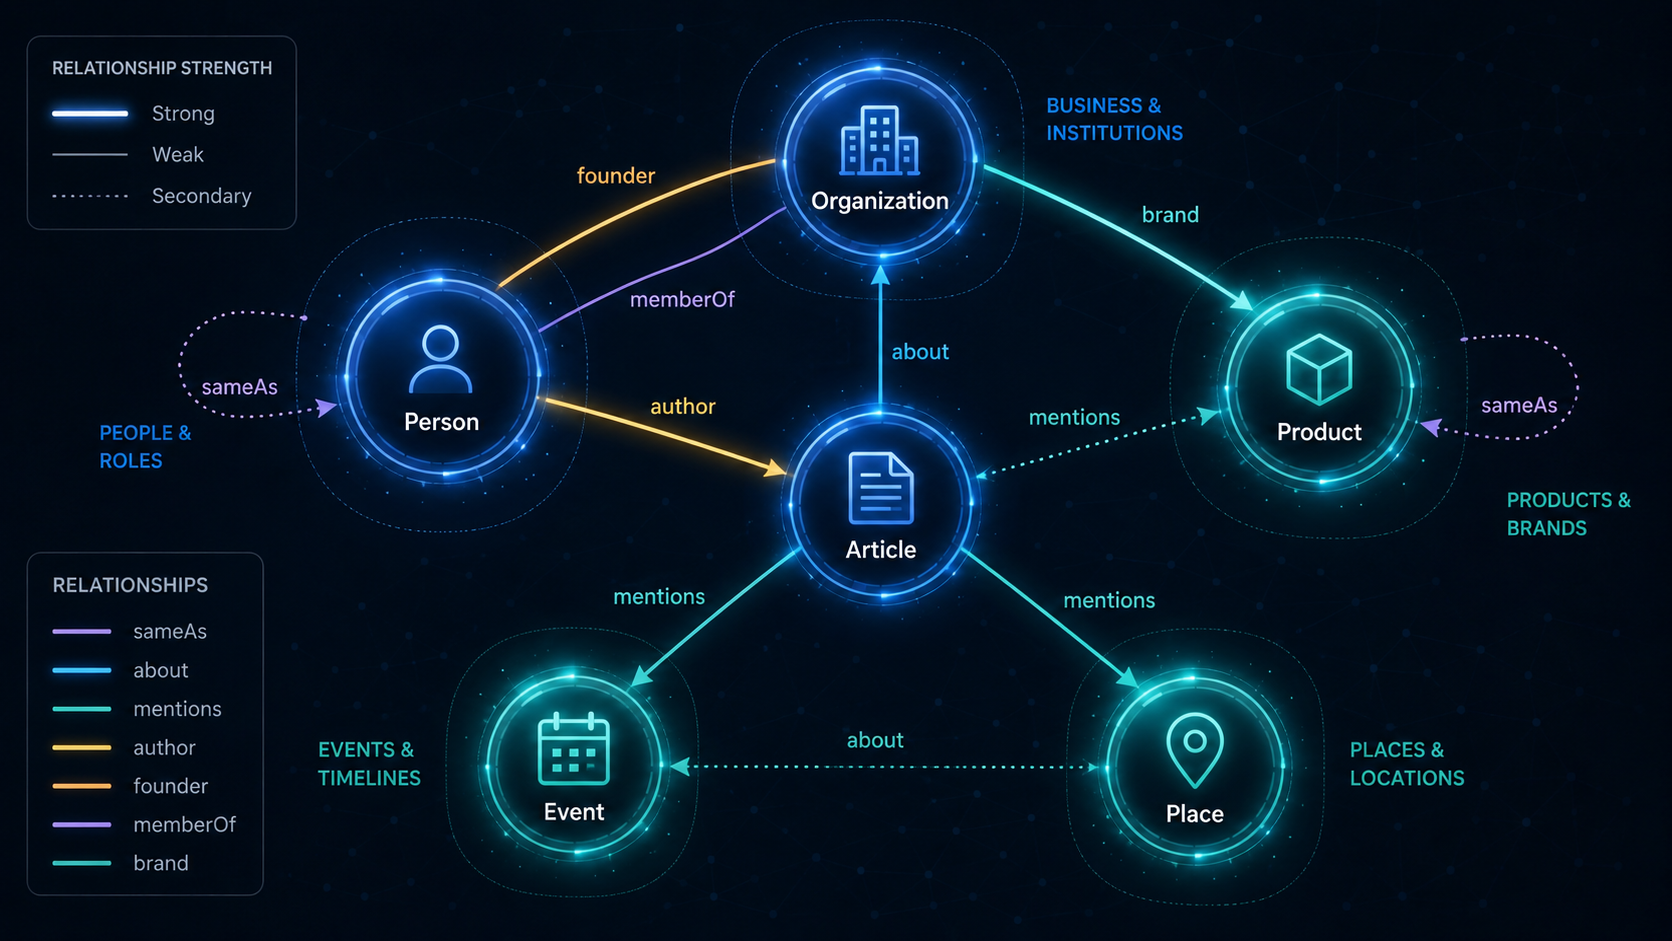
Suganthan Mohanadasan a proposé un cadre qui permet de confirmer cette idée et Gianluca Fiorelli en a proposé ensuite un prolongement. On parle ici de 3 moments où le schéma entre en jeu.
En voici un schéma visuel de représentation :
1 - Au moment de l'indexation
Le premier moment est essentiel à comprendre dans son mécanisme. Il commence par Googlebot qui extrait le JSON-LD des pages et construit les entités qui y sont représentées. Cette information sert ensuite à alimenter les graphes de connaissances que l'on retrouve sur Google. Chaque balisage schéma, quel que soit son type, joue ici un rôle plus ou moins important selon la nature de l'entité.
Fabrice Canel, chez Microsoft, a affirmé lors du SMX Munich, en mars 2025, que le balisage aide les modèles à comprendre le contenu. Le graphe de connaissances exploite ces balisages pour confirmer certaines informations, et celles qui sont ambiguës peuvent ainsi disparaître du graphe.
Jason Barnard a approfondie cet axe d'analyse avec le capteur de Kalicube (outil permettant de suivre le knowledge graph de Google depuis 2015). Il confirme le schéma comme un des moyens pour lever une ambiguïté à propos d'une entité mais elle n'est évidemment pas la seule.
Tout cela ne se limite pas au graphe de connaissances. Ryan Levering, ingénieur chez Google et chargé des données structurées a affirmé en Avril 2026 lors du Search Central Live de Toronto que le schéma est servi aux modèles au moment où les requêtes sont décomposées en fan out. Cette affirmation n'a cependant pas été retranscrit par Google dans sa documentation officielle.
Une mise à jour du guide officiel de Google sur la recherche générative affirme par le suite le balisage schéma n'est pas requis et que son rôle reste pour l'éligibilité des résultats enrichis. En résumé, Google exploite les données mais ne récompense pas leur utilisation.
Pour tout ce qui concerne les autres modèles, aucune confirmation ne démontre qu'ils peuvent accéder à ces données.
2 - Au moment du pré-entraînement
Le code JSON-LD n'est pas directement utilisé à la phase de pré-entraînement des modèles. C'est l'ensemble des graphes de connaissances et des fiches d'entités, dont celles de Wikidata, qui alimente cette connaissance des modèles. Plus une entité est forte, plus elle est représentée.
Tout ce qu'un modèle sait de votre marque et qu'il a stocké dans sa mémoire dépend de la force de celle-ci en tant qu'entité. Le balisage schéma a indirectement alimenté cette entité, et c'est dans ce sens qu'il joue un rôle sur la visibilité d'une marque.
Si l'on prend les 2 chaînes de préparation (C4 et Fineweb), tout ce qui contient une accolade ou du script est retiré.
page HTML ──► Common Crawl ──► filtrage (C4, FineWeb) ──► corpus ──► modèle
  │ JSON-LD                        ✕ page écartée ou scripts retirés
  └─ sameAs ──► Wikidata ──► Knowledge Graph ──► Wikipédia, Wikidata ──► corpus ──► modèle
                         (entité déjà ancrée seulement)
Une seule donnée peut rester, c'est la propriété sameAs qui alimente Wikidata avec les entités désignées.
Bien entendu, on nuance on précisant bien que les chaînes d'OpenAI, d'Anthropic et de Google ne sont pas publiques où C4 et Fineweb ne sont que des proxys et jamais des preuves. Rien ne permet de mesurer la mémoire du modèle.
La connaissance des modèles est essentiellement représentée par les graphes de connaissances et les fiches d'entités. Plus une entité est forte et plus elle y est représentée.
Cette analyse nous donne une dimension temporelle de tout ce processus. Le balisage alimente le graphe au fil de l'indexation puis sur le modèle avec l'entrainement qui passe par tous les contenus qui parlent de votre marque.
En conséquence, il faut travailler les schémas dont la propriété sameAs qui aliment Wikidata et Wikipedia. L'entité travaillée doit exister au préalable et cela par des mentions tierces sur le web. Le schéma ne peut agir seul. C'est la condition de son utilité à cette étape.
3 - Au moment de la réponse
C'est l'étape qui apporte une nuance à l'étude d'Ahrefs. En effet, le JSON LD n'est pas interpréter en temps réel par le moteur.
fetch HTML ──► extraction du texte ──► le modèle lit du texte
                    │
                    ├─ scripts retirés   ──► JSON-LD absent            searchVIU · Otterly, test 3
                    └─ scripts conservés ──► JSON-LD lu en caractères  DUCKYEA
       aucun étage ne l'interprète comme une structure
3 tests dont 2 protocoles tente de placer une information uniquement dans le schéma sans la placer dans le texte visibile. Tous les résultats convergent pour dire que l'information n'est pas lue.
Le premier point est que le JSON est conditionné par une écriture qui doit être valide sans quoi aucun parseur ne peut l'extraire. L'absence de parseur qui permet de passer le JSON LD en donnée structurée est précisement ce qui caractérise les modèles.
Au moment de la réponse, le balisage schéma sera donc au mieux un texte redondant et au pire un contenu absent de la page. Une information ne doit donc jamais vivre uniquement dans le balisage. Ce que le balisage apporte comme information doit aussi se retrouver dans la page.
Ce qui fait vraiment citer une page
On a vu que le balisage n'a aucun impact au moment de la récupération. Je ne reviens pas sur ce processus de récupération que je présente en détail dans mon article L'AI Search, deux mécanismes.
Deux éléments ressortent à cette étape : les citations se font généralement dans le corps du texte, et les titres comme les métadonnées influencent la récupération.
Un passage citation ready comme je le montre dans ce schéma ci-dessous montre que le passage doit respecter plusieurs conditions :
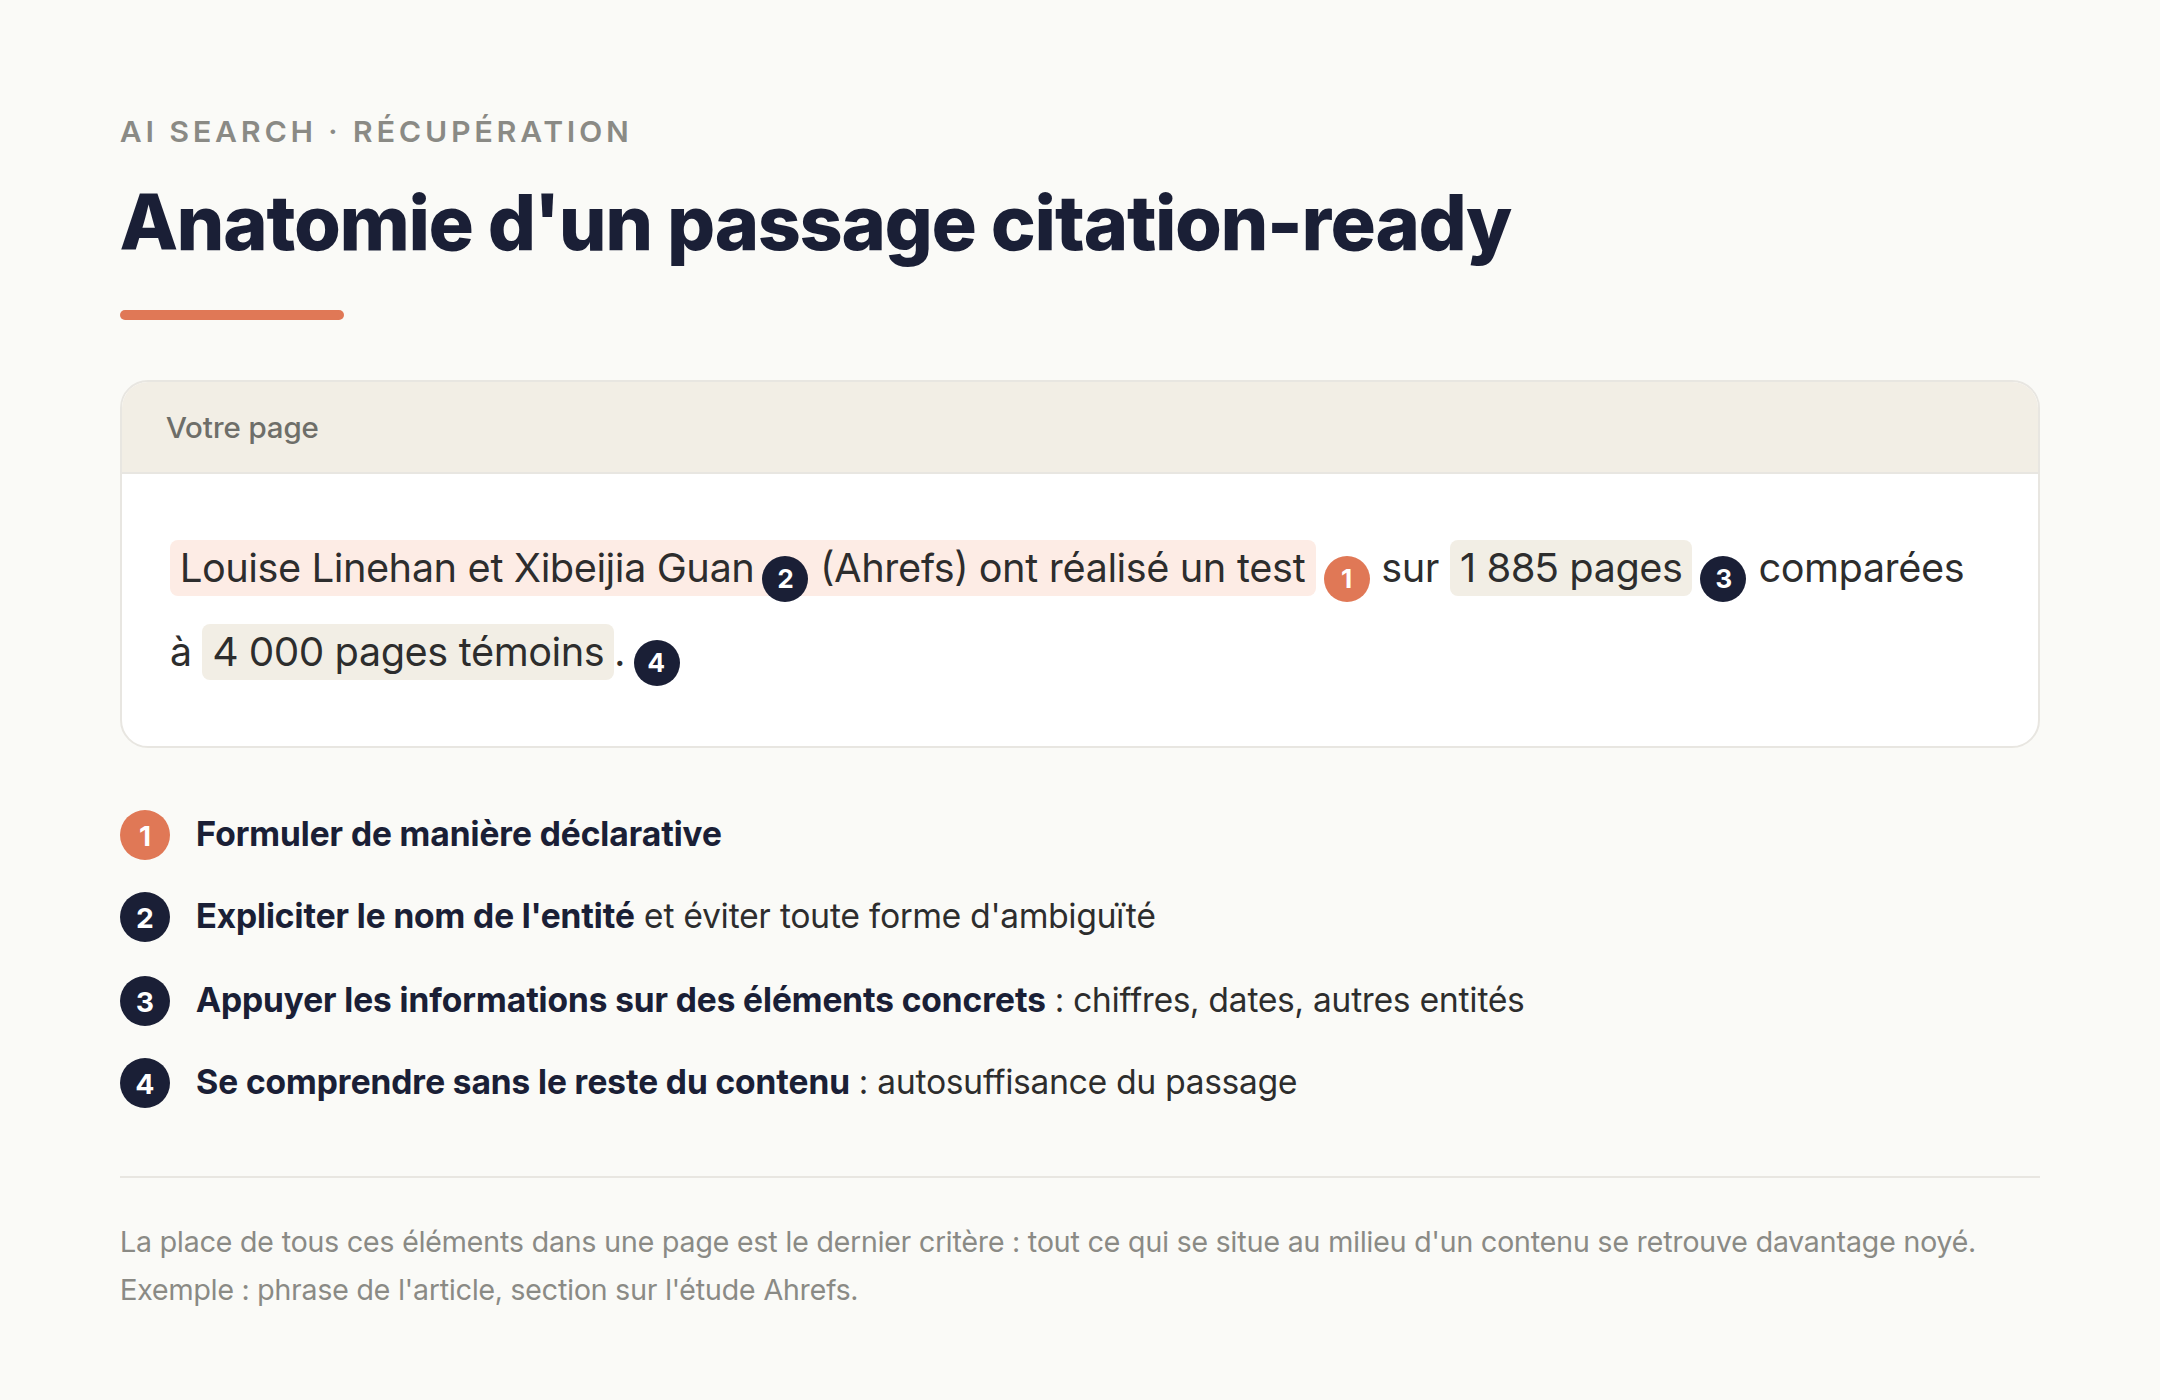
- Expliciter le nom de l'entité et éviter toute forme d'ambiguïté
- Formuler de manière déclarative
- Appuyer les informations sur des éléments concrets (chiffres, dates, autres entités)
Enfin, la place de tous ces éléments dans une page est le dernier critère essentiel. Tout ce qui se situe au milieu d'un contenu se retrouve davantage noyé dans le reste des informations.
Toutes ces techniques qui enrichissent les entités du graphe de connaissance ont un point commun : le contenu, et non les données structurées.
Des données structurées au langage structuré
On comprend de ce travail fait au niveau de la récupération, et entre autres sur l'optimisation des passages, que le renforcement des entités ne dépend pas uniquement du balisage de données structurées.
Ajouter une structure au langage afin que les entités y soient explicitement reconnaissable par le texte et non uniquement par le balisage. Un contenu qui nomme explicitement ses entités et alimente ce qu'elles représentent peut se faire sans aucune balise.
Une phrase peut jouer le rôle du balisage sous quatre conditions :
- Elle nomme explicitement ses entités sans l'usage de pronoms
- Elle désigne les relations entre ces entités
- Elle préserve les conditions qui les limitent
- Elle se comprend sans le reste du contenu (autosuffisance du passage)
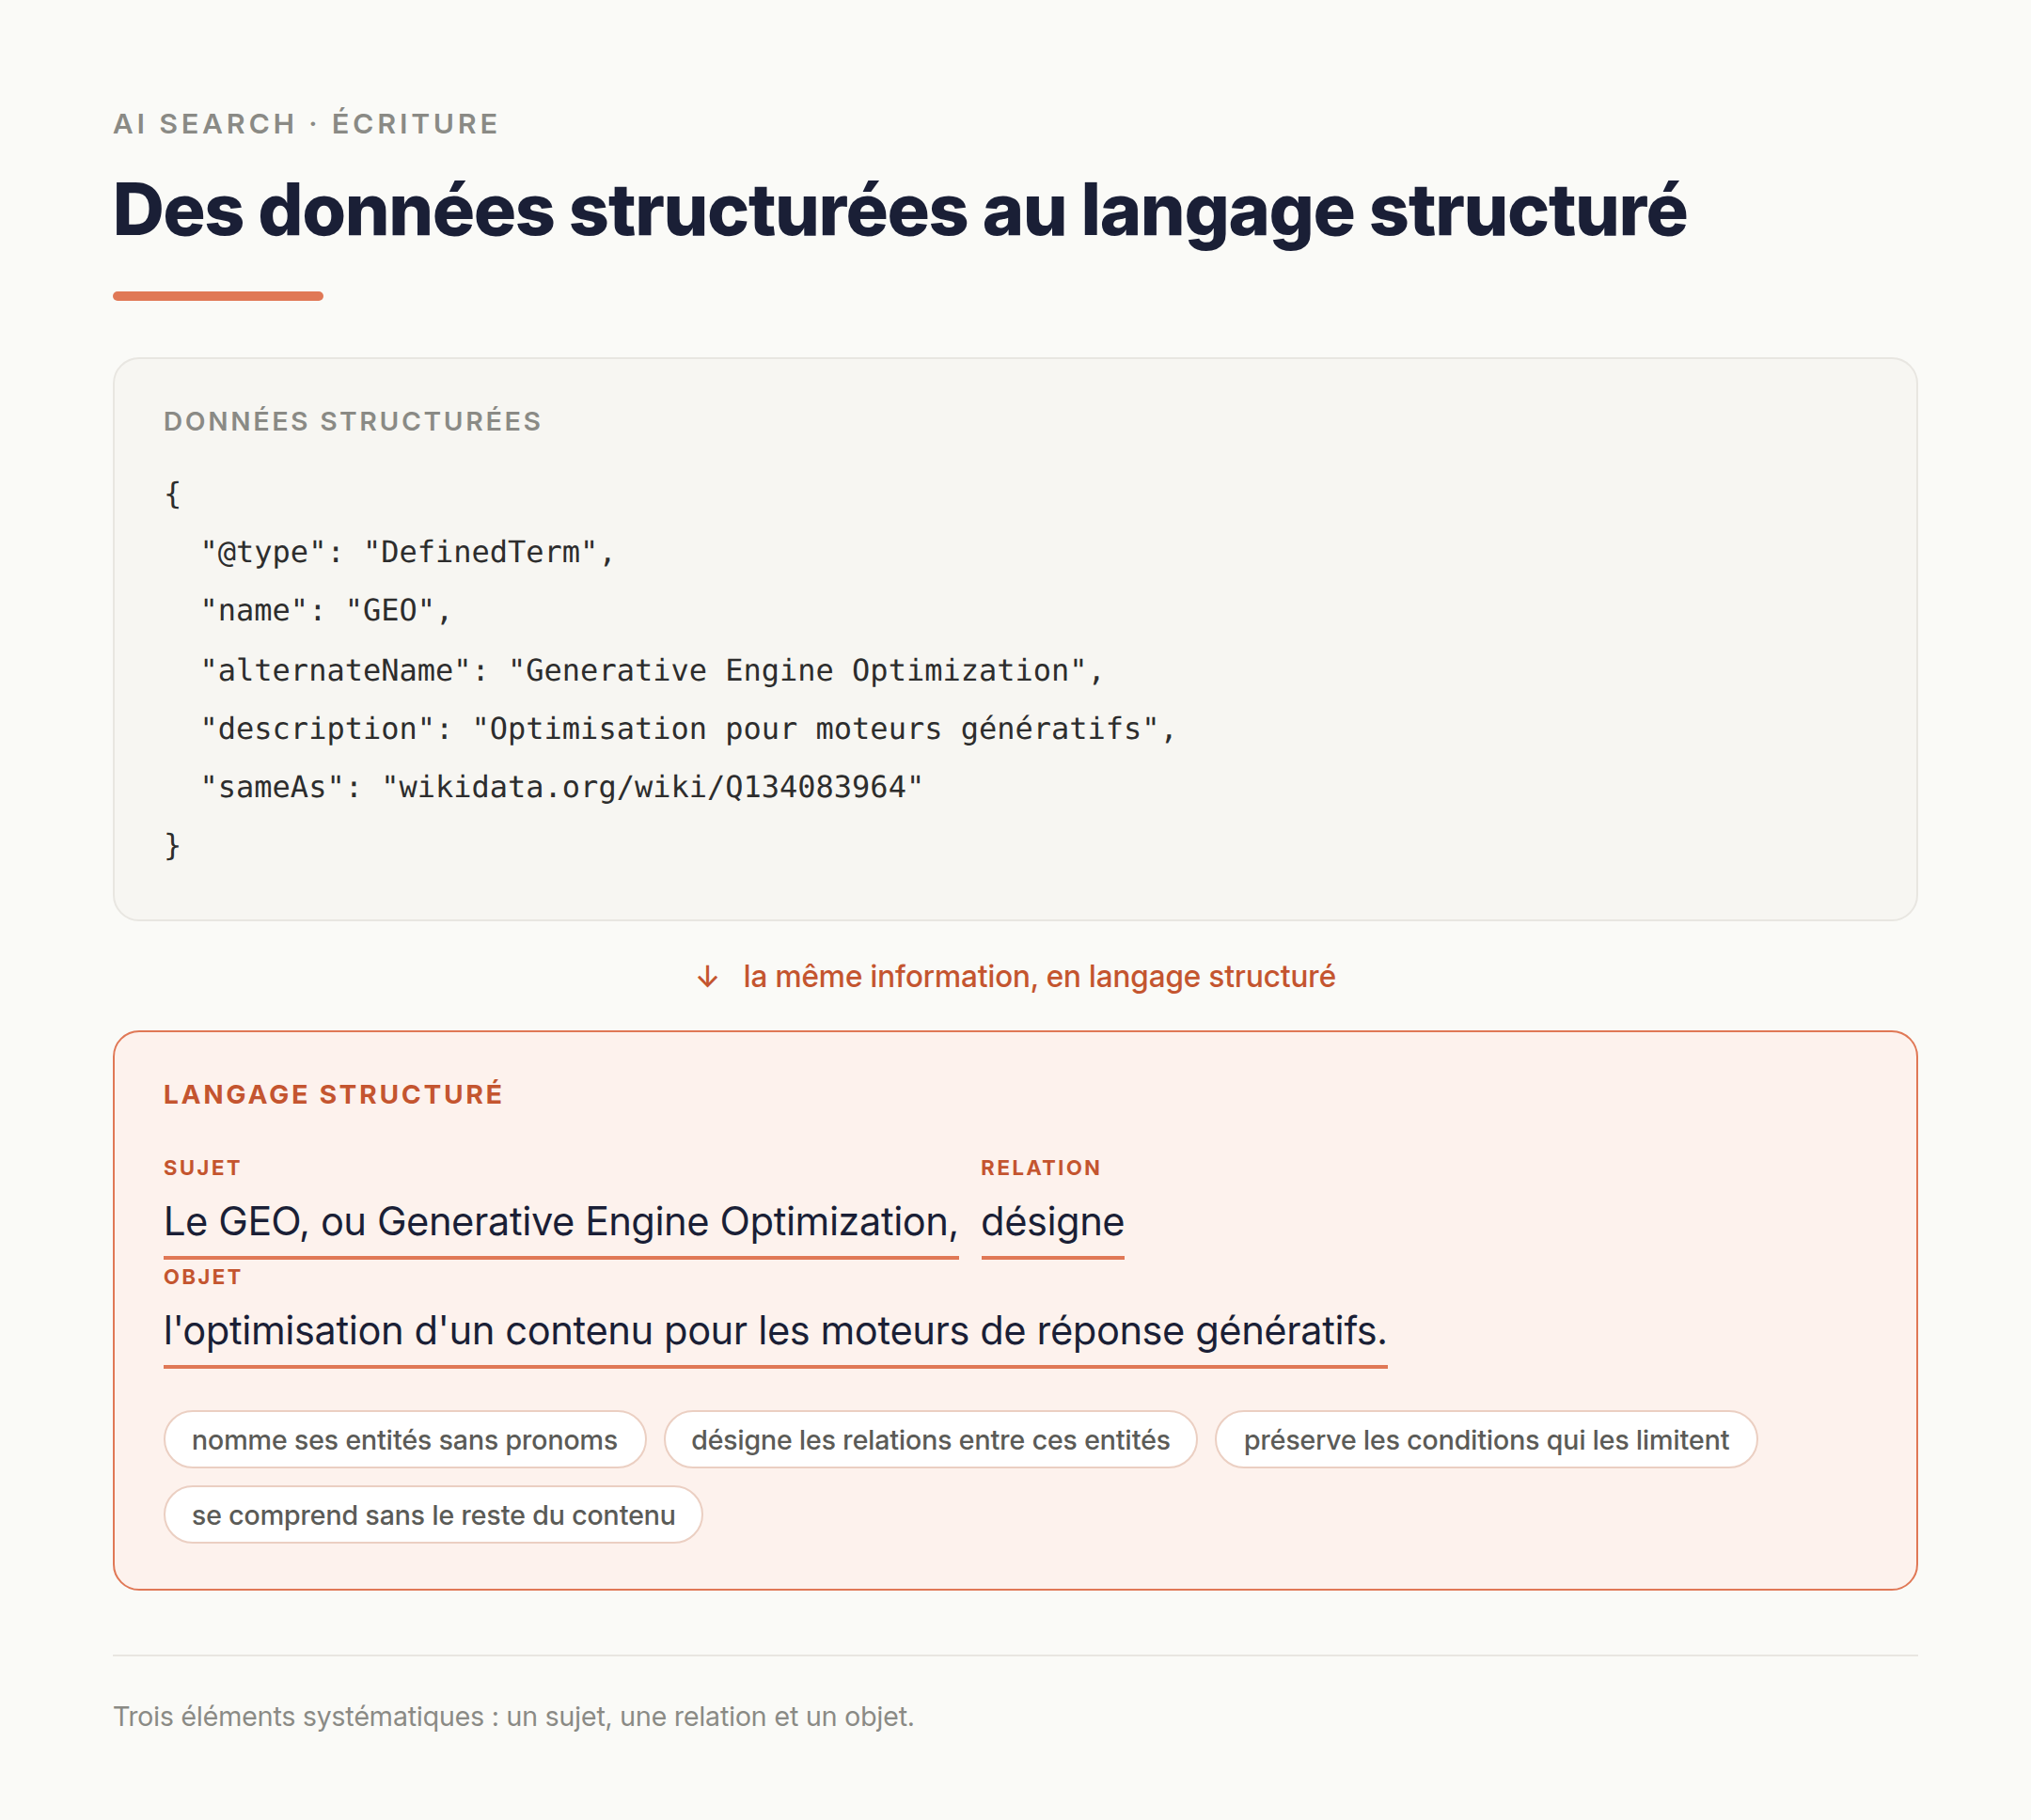
En résumé, on a trois éléments systématiques, à savoir un sujet, une relation et un objet.
Cette logique du langage structuré pourrait être une réponse à ce qui compte réellement au-delà du balisage et des graphes de connaissances construits par Google.
Cette logique implique donc surtout une méthode d'écriture qui est faite pour les IA qui cherchent des passages courts, des entités reconnaissables et des points d'ancrage qui peuvent alimenter leur connaissance.
Tout ce travail peut être fait sans le balisage.
La précision du langage compte plus que la structure du balisage
Écrire et optimiser pour un modèle de langage ne doit pas consister uniquement en une simplification. Le contenu doit rester dense et spécifique.
Ce qui fonctionne pour la machine est ce qui fonctionne aussi pour l'humain, à savoir une phrase qui conserve tout son sens même sortie de son contexte. Une phrase que l'on peut extraire et réutiliser sans le reste.
Ce point d'analyse nous rapproche d'une conclusion sur ce débat du rôle du balisage schéma sur la citation en AI Search. Chaque entité nommée dans un texte alimente les machines qui lisent du texte.
L'optimisation par le balisage qui révèle ses limites en AI Search reprend du sens dans cette approche qui s'oriente davantage sur le format que les LLM savent réellement lire, à savoir le contenu.
Que faire du balisage JSON-LD ?
Nous venons de voir l'approche par le langage structuré mais cela ne retire pas pour autant le rôle du balisage qui reste un support pris en compte par Google.
Je vous propose plusieurs usages à avoir sur le balisage pour bien comprendre comment l'optimiser.
- Proposer des identifiants stables (
@id) qui servent de point de référence - Relier les entités entre elles par des champs spécifiques (
sameAs,aboutoumention) - L'information doit aussi être disponible dans le contenu, le balisage confirme le contenu
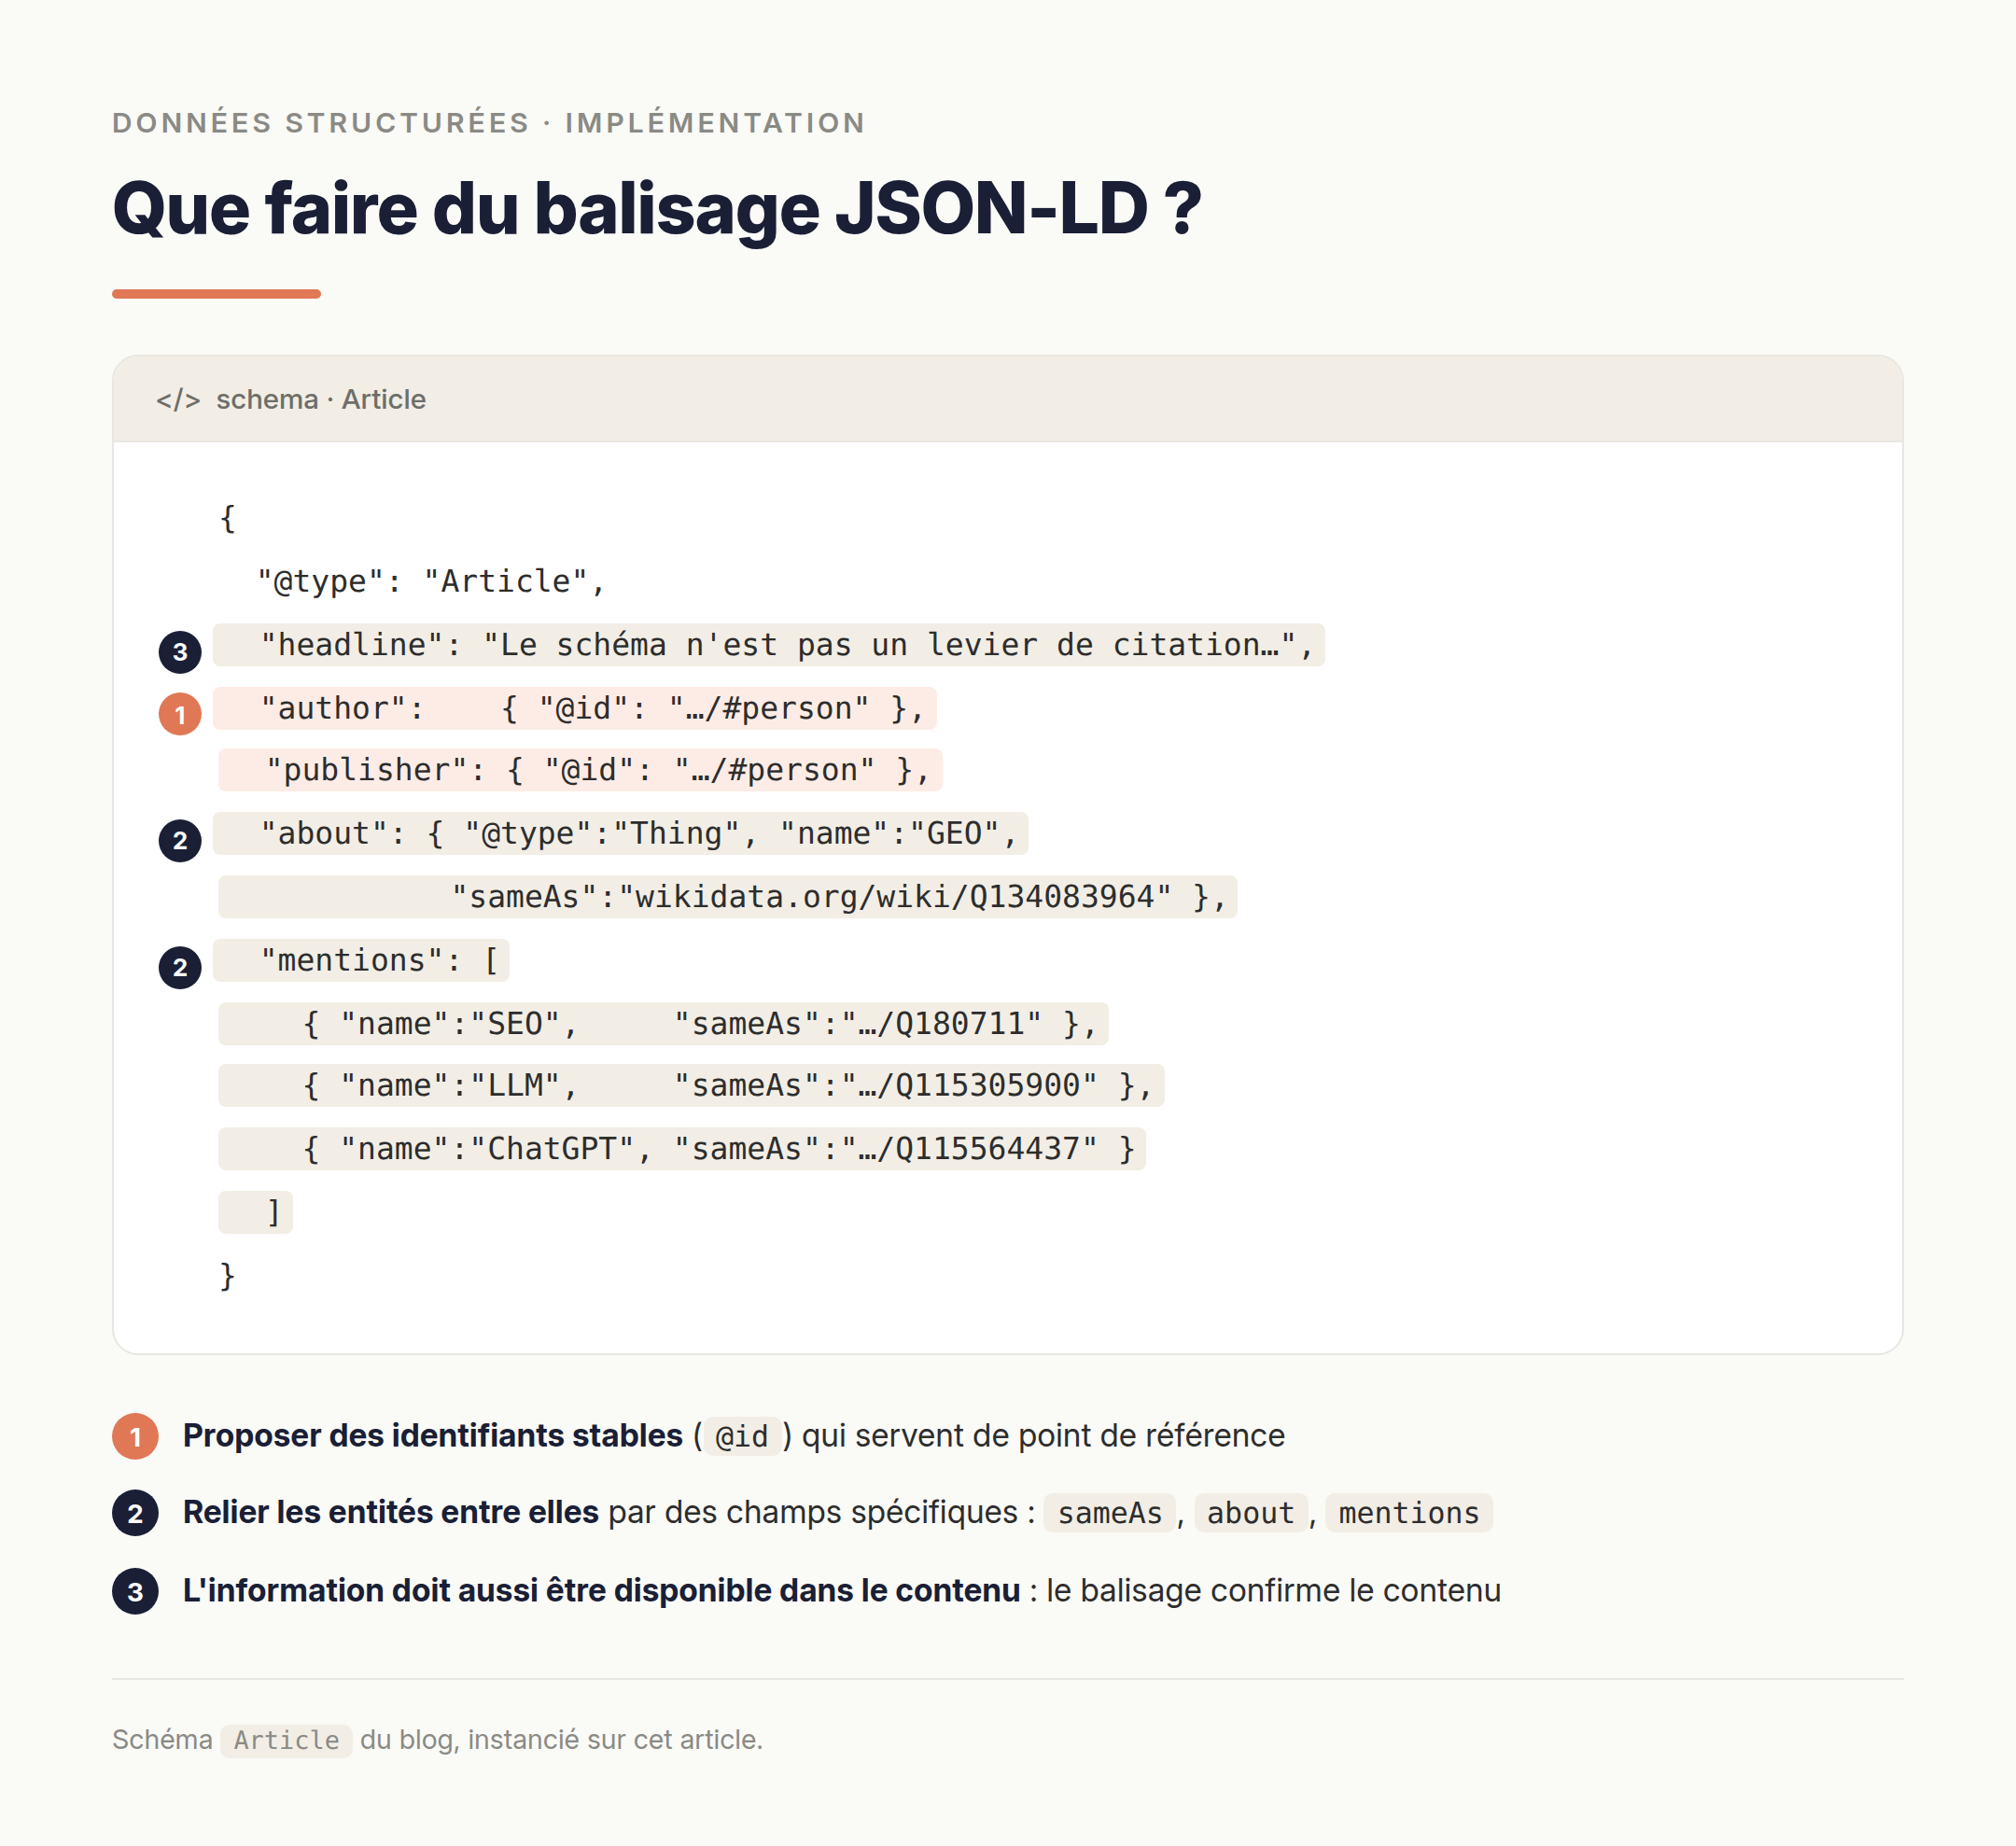
Ce qu'il est important de retenir, c'est que le balisage ne doit être utilisé que pour confirmer ce que la page dit déjà. Une information ne doit jamais être exclusive au schéma, au risque que celle-ci soit manquée.
L'effort du balisage se justifie aussi selon la force de l'entité travaillée. Une marque de forte renommée et connue dans tout un pays n'a pas besoin du schéma pour mieux alimenter le graphe. Les ressources du web apporteront davantage.
Une marque jeune ou un auteur peu référencé a en revanche besoin de maximiser les signaux d'identification et de se montrer comme entité. C'est là que le balisage peut appuyer un manque où le contenu seul sera plus limité.
Le cas du commerce où le balisage joue un rôle clé
Le e-commerce est très certainement la règle d'exception sur le rôle du schéma et tout particulièrement quand les agents comparent et achètent pour le compte d'un utilisateur.
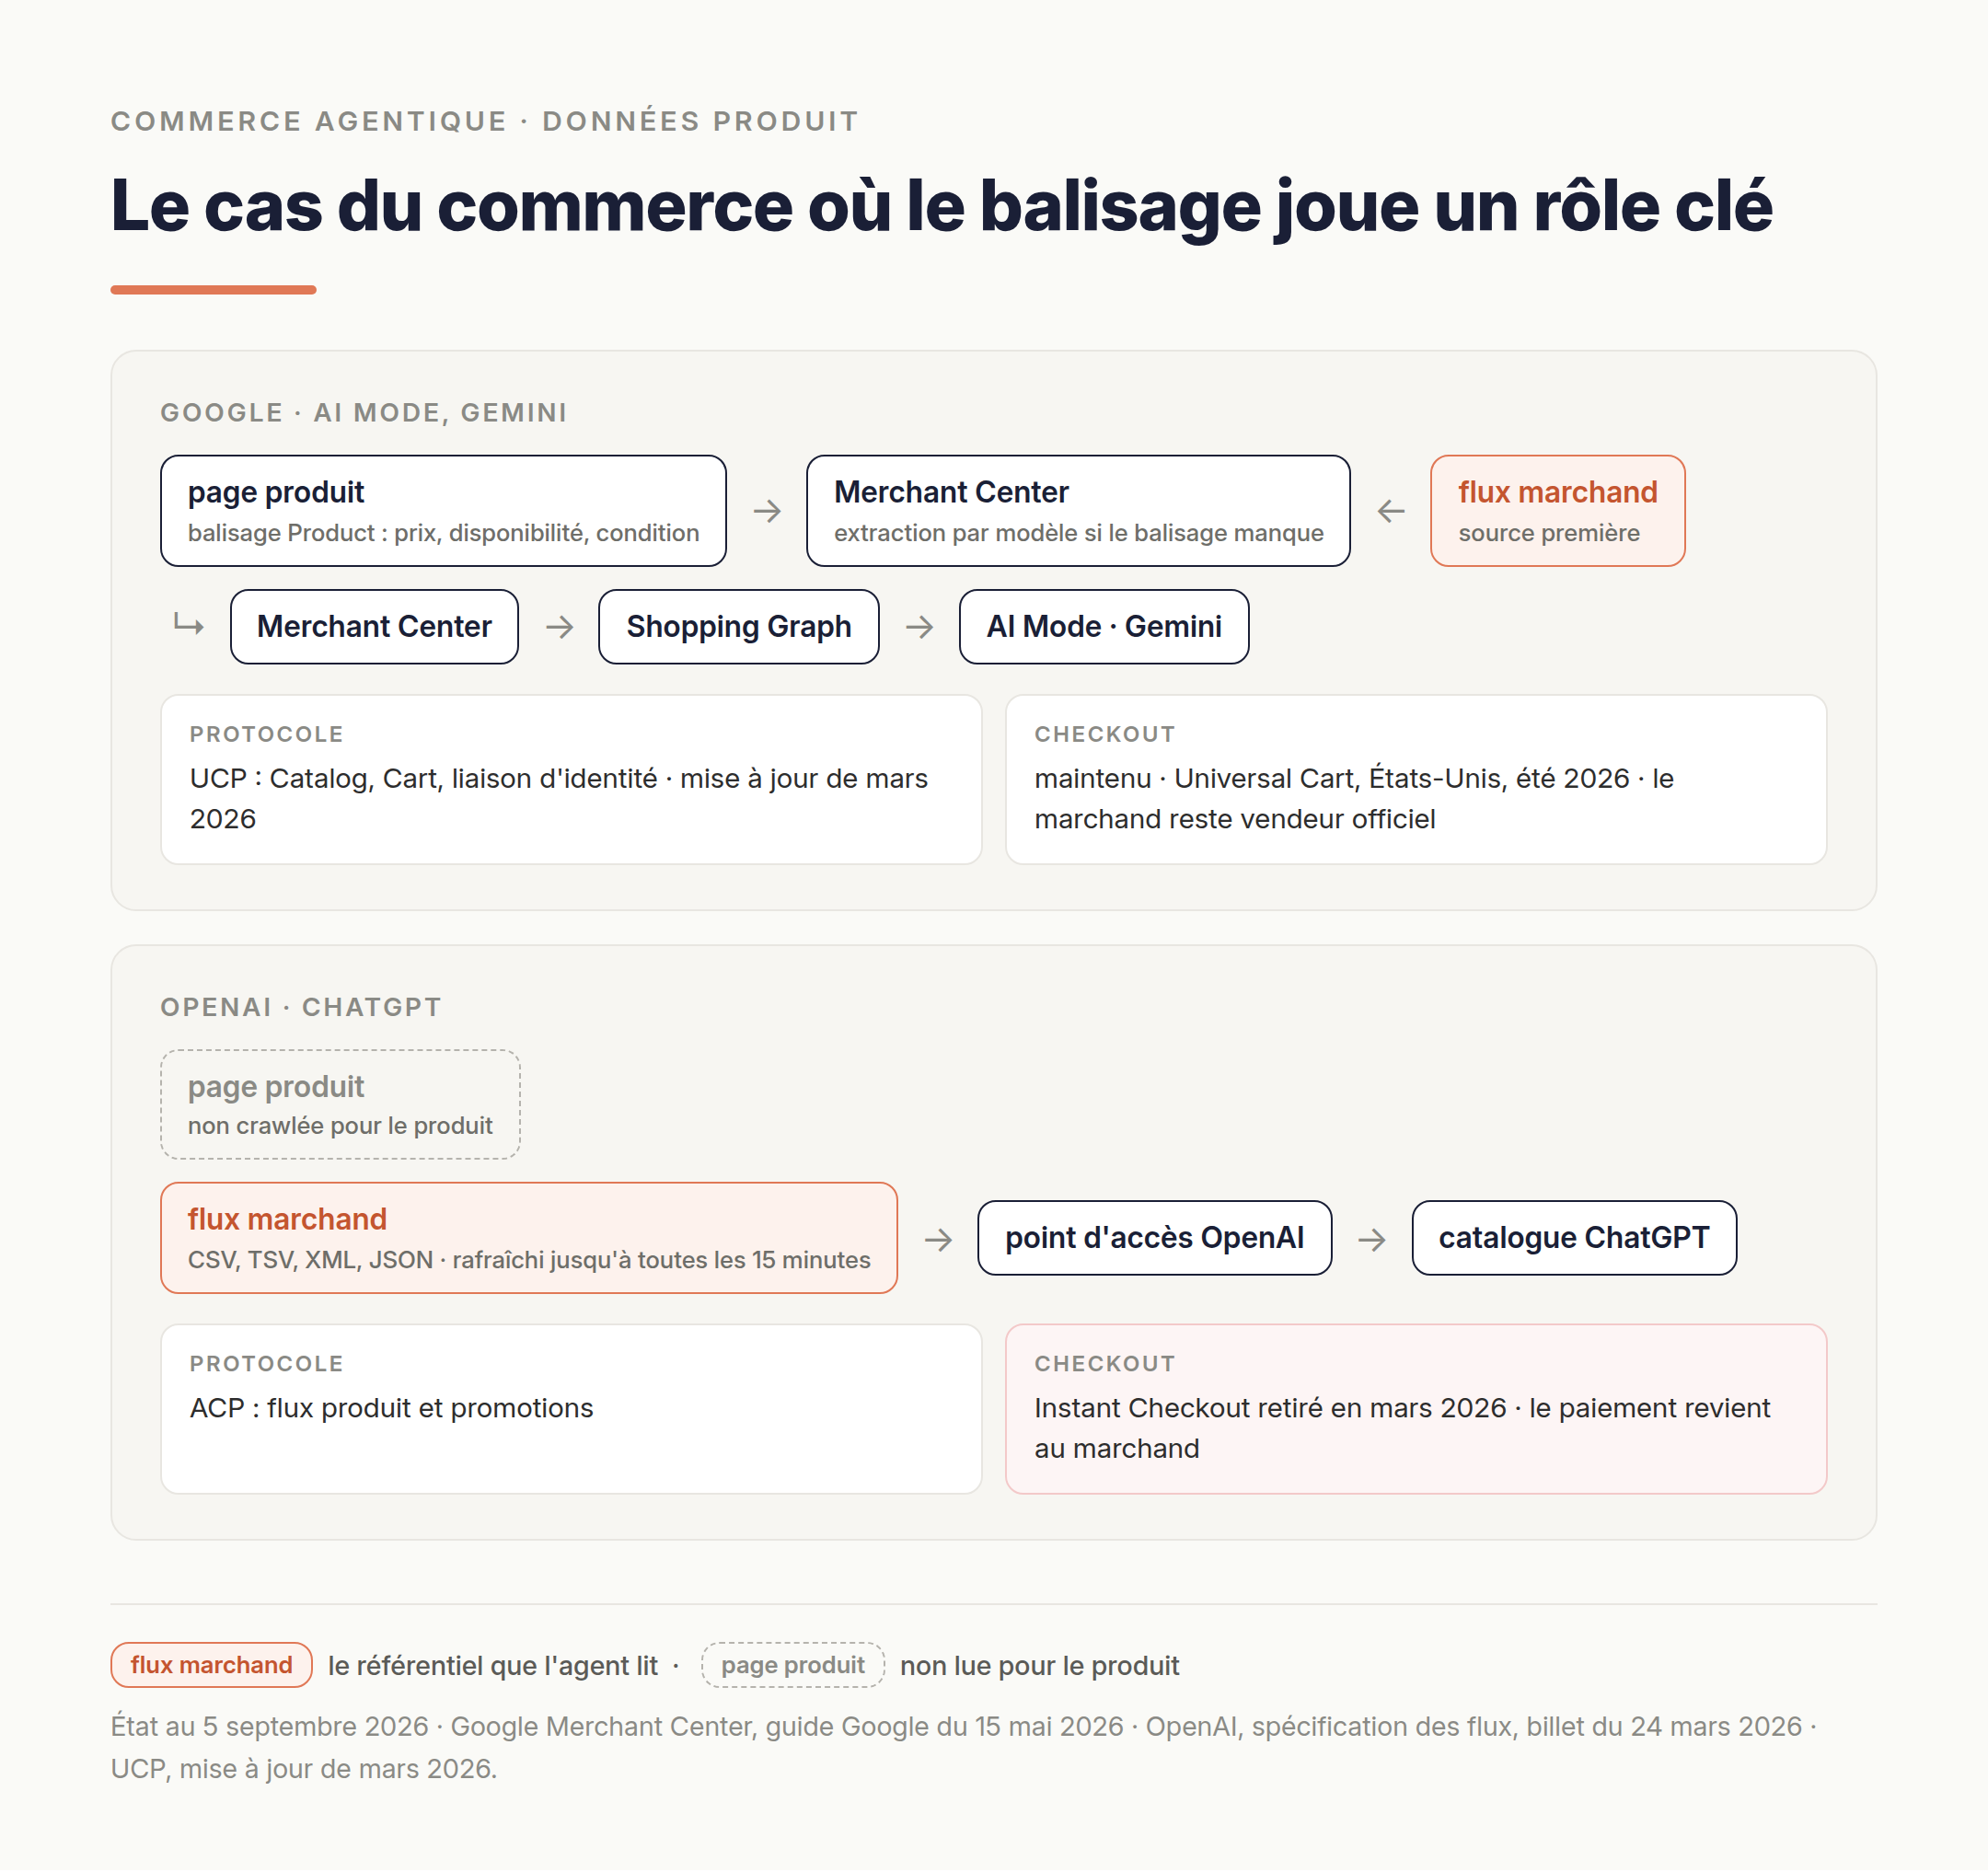
Dans le cas du commerce agentique, le lecteur n'est plus l'humain mais la machine, c'est de ce fait que la lecture ne se fait plus en premier par le contenu servi sur la page. Ce processus commence par l'extraction du contenu sur vos pages puis ensuite du schéma pour faire remonter le catalogue produit. La donnée structurée y est nécessaire car c'est par ce biais que le parseur remonte la donnée jusqu'à Merchant Center ou OpenAI.
On parle ici de toutes les informations que lagent doit prendre en compte pour sélectionner, comparer et enfin acheter. On nuance que l'instant check out n'est pas disponible sur l'ensemble des plateformes et notamment sur Open AI.
En commerce, le schéma est donc un référentiel qui décide de l'existence d'un produit dans le catalogue de l'agent. Une erreur d'information sur le schéma entraine une contradiction avec le flux provoquant une invalidité du produit dans le catalogue. Merchant Center exige une correspondance exacte entre ce qu'annonce le flux et ce que le schéma remonte sur les produits.
Le schéma n'est pas remis en question
Les différents débats sur le schéma avaient donc bien raison de remettre en question son rôle comme facteur de citation. Ce qu'ils ne disaient pas, en revanche, c'est que le schéma n'est pas un critère à prendre indépendamment du reste.
Il représente surtout un appui à ce que le contenu propose déjà. Optimiser ce balisage mieux que le contenu lui-même est une erreur de priorisation.
Le schéma est un complément d'information qui aide à enrichir une donnée normalement déjà disponible dans le contenu. Il aide également les marques de faible notoriété cherchant à se faire connaître.
Le schéma est donc un complément, globalement peu coûteux en développement, qui peut permettre de renforcer la compréhension d'une entité si le contenu ne l'a pas bien fait.
À noter également le cas du commerce agentique qui fait règle d'exception sur cette pratique et qui amplifie son rôle. Le rôle du schéma est donc aussi une question qui dépend des leviers qu'on actionne.
Sources :
 Louise Linehan
 Michael

 Gianluca Fiorelli
 Suganthan Mohanadasan