Du pipeline à la boucle : comment les moteurs IA sont devenus agentiques
Dans mon article sur le décryptage du suivi de visibilité IA et ses limites, nous avions vu que les modèles de langage ne se limitent plus à une récupération simple en un seul passage. Désormais les modèles fonctionnent par planification, exécution et évaluation de leur propre brouillon. Ce qui se passe entre le moment où l'utilisateur pose sa question et le moment où le modèle répond passe par des étapes de validation que nous ne voyons pas directement mais qui influencent la réponse.
Maintenant que l'AI Mode et l'AI Overview sont déployés en France depuis le 22 juillet 2026, c'est le bon moment pour en parler et expliquer comment cette architecture des modèles a changé la façon dont ils répondent. Comment est-on passé de la RAG pipeline (une requête, une récupération et une réponse) à un fonctionnement en boucle.
Nous nous appuierons sur 2 publications de référence pour cette analyse parues chacune en 2026 à quelques mois d'écart. La 1ère sur l'agentic RAG selon Mike King qui documente une analyse du fonctionnement d'un agent qui pilote une récupération par planification et relecture. La seconde vient d'Olaf Kopp et s'intéresse au Graph RAG qui analyse un graphe de connaissances et non juste des fragments de texte isolés.
Nous allons détailler ce fonctionnement et on y analysera également quelques papers de recherche académique, des brevets ainsi que des boucles de raisonnement.
L'objectif est d'améliorer notre compréhension du fonctionnement des modèles afin de mieux comprendre ce qui se passe au moment où une IA cite une marque et aussi pour mettre en perspective les constats et recommandations GEO qui en découlent.
Sommaire
- Pourquoi le RAG en un seul passage a atteint ses limites
- Comment fonctionne la boucle agentique
- Le graphe, terrain du raisonnement
- Quand la boucle rencontre le graphe
- Entités-ponts et sous-graphes
- Mesurer la visibilité reste limitée par la capacité des outils
Pourquoi le RAG en un seul passage a atteint ses limites
Le RAG (Retrieval-Augmented Generation) ou génération augmentée par récupération a fonctionné pendant un moment en ligne droite en un seul passage et plus souvent appelé le "RAG pipeline".
Ce fonctionnement est un enchainement assez simple avec une requête utilisateur qui est convertie en vecteur, les passages les plus pertinents sont servis aux modèles qui rédigent la réponse. Ce fonctionnement se résume en 3 mots : requête, récupération et réponse.
requête ─▶ vecteur ─▶ index ─▶ passages ─▶ LLM
                                            │
                                            ▼
                                        réponse
        (un seul passage · aucun retour)
Mike King avait déjà documenté ce fonctionnement en 2023 sur son article sur la Search Generative Experience qui posait ce modèle de fonctionnement comme l'architecture générative de Google. En 2026, il dresse un bilan et propose une relecture de cette analyse. Une majorité des constats ont été préservés, notamment sur la récupération des passages ou le rôle des graphes de connaissances mais ce qui a changé réside surtout dans la forme du trajet suivi par les modèles qui n'est plus en ligne droite mais désormais en boucle.
Les quatre limites structurelles du RAG pipeline
Commençons par expliquer pourquoi ce fonctionnement est un modèle dépassé aujourd'hui et c'est la complexité des questions auxquelles sont soumis les modèles qui a imposé ce changement d'architecture.
1 - Les questions composées
Une question précise peut désormais exiger plusieurs récupérations simultanées et donc solliciter la récupération de plusieurs concepts. Le RAG pipeline ne remonte pas ce qui lie ces différents concepts entre eux.
Un exemple de question composée : Comment retrouver dans Data studio le suivi de conversions d'Universal Analytics ?
Cette question amène à au moins 4 récupérations distinctes :
- correspondances des métriques entre Universal Analytics et GA4
- configuration des évènements clés dans GA4
- connexion entre GA4 et Datastudio
- limites de l'API de données
Plusieurs récupérations requises en plus différents croisements qu'impose ce type de questions.
A ce problème le fonctionnement en boucle propose une phase de planification qui vient décomposer la requête en sous-requêtes.
2 - Une récupération qui peut échouer
Une récupération peut échouer à sa première tentative ce qui entraine le modèle à l'usage de sa mémoire interne pour répondre par défaut. On sait que la mémoire interne du modèle peut entrainer des réponses incomplètes et limitées à ce que le modèle a appris lors de son entrainement.
Le fonctionnement en boucle répond à ce problème par une étape d'itérations qui consiste à requestionner l'index en cours de raisonnement.
3 - Une récupération sous une seule forme
La récupération peut imposer une méthodologie et des outils qui n'étaient pas sollicités dans le fonctionnement en pipeline.
L'usage d'outils pour traiter la réponse à chaque sous-requête est désormais pris en charge et la phase de planification qui précède détermine l'usage de ces outils.
Le fonctionnement agentique peut donc solliciter des outils tels que des calculateurs pour répondre à des questions qu'une simple récupération ne peut réussir à faire.
4 - L'absence de relecture
Le fonctionnement en pipeline ne procède à aucune relecture de la réponse générée et donc sans aucune vérification de cohérence avec les sources.
Une auto-évaluation caractérise donc le fonctionnement en boucle qui procède à une relecture et critique de son propre brouillon avant même de formuler la réponse.
C'est justement ce système d'auto-évaluation qui forme le principe de boucle qui peut se répéter plusieurs fois jusqu'à ce que la récupération des passages soit intégrale pour formuler la réponse.
La recherche académique pose le même diagnostic
Ce constat dressé par Mike King est appuyé aujourd'hui par celui d'Olaf Kopp dans son analyse du Graph RAG qui décrit ces mêmes limites mais vu depuis un autre angle.
- Le paper de Microsoft From Local to Global démontre que le RAG classique échoue essentiellement sur les questions de synthèse globale qui demandent de comprendre tout un corpus. Dans ce cas précis, la récupération de fragments isolés y atteint ses limites.
- Le paper Graph-R1 appuie sur 2 limites à savoir l'absence d'itération lorsque le modèle engage une phase de récupération et enfin une perte au niveau sémantique avec des relations entre entités qui s'effacent lorsqu'un texte est découpé en fragments indépendants.
Ces différents constats montrent le RAG pipeline comme un système qui traite un ensemble de fragments de textes sans relations entre eux alors que les questions complexes nécessitent de placer des relations entre ces fragments.
Tout le système de récupération fonctionne donc comme une boucle que l'agent parcourt, évalue et relance autant de fois que nécessaire.
Comment fonctionne la boucle agentique ?
Dans ce modèle de fonctionnement, on parle d'un mécanisme "agentique" et la raison est que le système opère lui-même tout le processus sans dépendre d'un fonctionnement prédéfini à l'avance. Avec ce fonctionnement, le moteur est donc en mesure de piloter tout le processus à chaque étape.
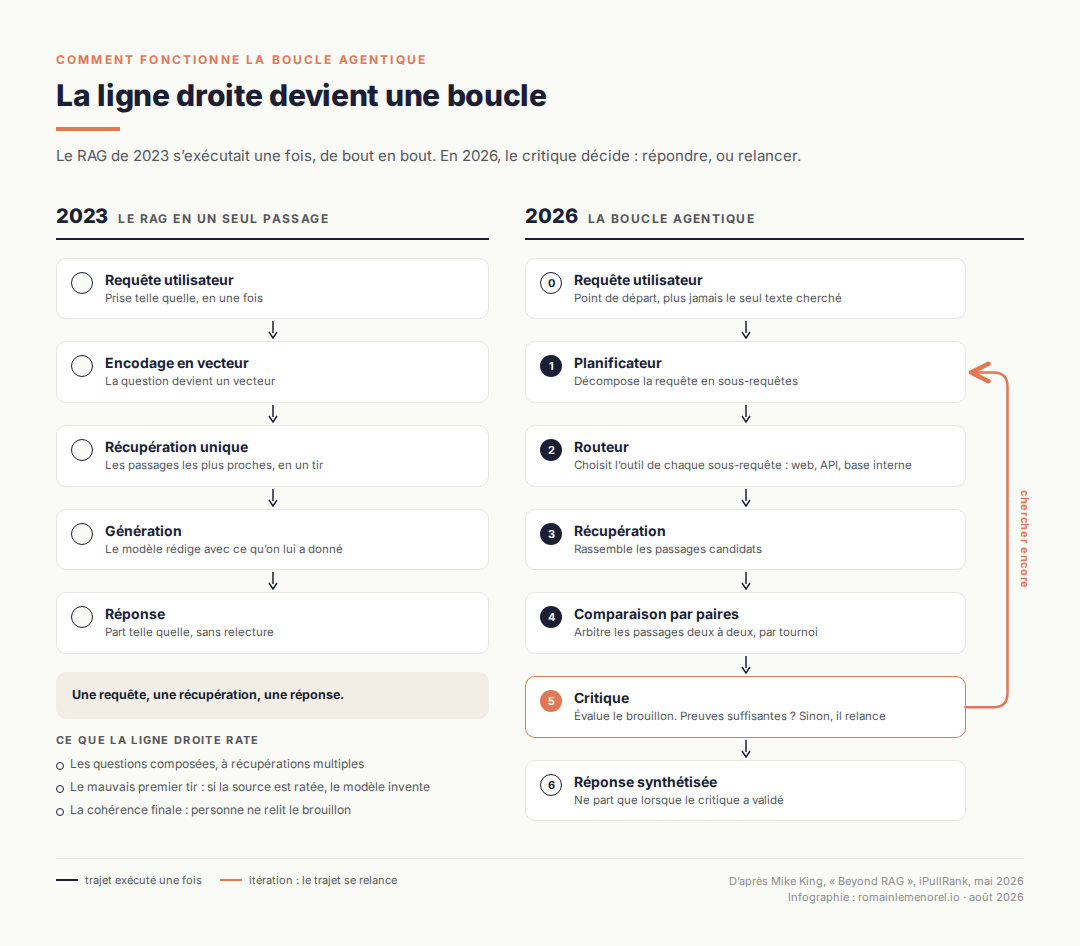
Un fonctionnement qui repose sur 4 principes
4 papers académiques sont à la base de ce modèle de fonctionnement. Il n'est donc pas nouveau et c'est l'assemblage de ces différents modèles qui définit le fonctionnement agentique des modèles.
| Propriété | Paper fondateur | Année |
|---|---|---|
| Planification | ReAct (Yao et al.) | 2022 |
| Usage d'outils | Toolformer (Schick et al.) | 2023 |
| Itération | IRCoT (Trivedi et al.) | 2022 |
| Auto-évaluation | Self-RAG (Asai et al.) | 2023 |
        ┌─────────────────────────┐
        ▼                         │
  PLANIFICATION                   │
        │                         │
  usage d'OUTILS             ITÉRATION
        │                         │
  RÉCUPÉRATION                    │
        │                         │
  AUTO-ÉVALUATION ── manque ──────┘
        │
     suffit
        ▼
     RÉPONSE
Le changement apporté par ces propriétés n'est pas anecdotique. IRCoT permet un gain jusqu'à 21 points sur des questions multi-sauts qui passent d'un document à un autre. Une simple question utilisateur peut générer de 5 à 20 sous-récupérations tandis que le pipeline classique n'en réalisait qu'une seule.
Le schéma qui illustre la boucle agentique prend tout son sens par ce schéma où les 2 étapes clés sont l'auto évaluation et l'itération.
Une pré sélection en 5 phases
Quand un contenu entre dans la boucle, il doit franchir 5 étapes de sélection que nous avions déjà représentées par les gatekeepers sur le schéma ci-dessous.
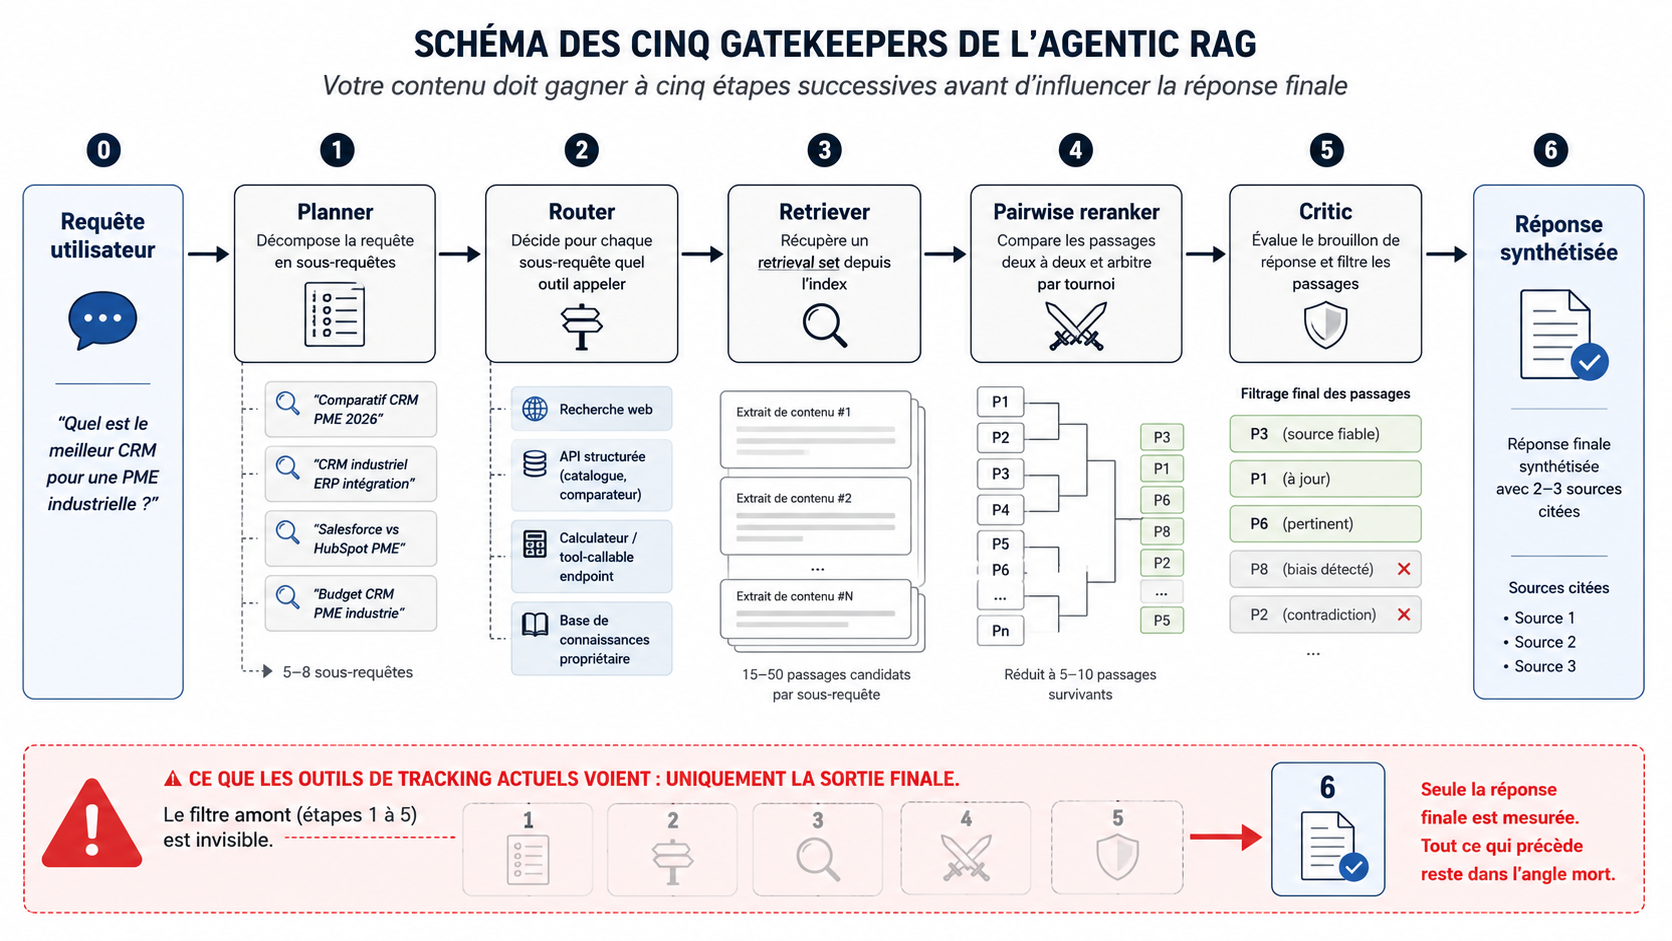
- La planification où la requête est décomposée en sous-requêtes
- Le routeur qui oriente vers l'outil le plus approprié pour répondre
- La récupération des passages candidats
- La comparaison par paires des différents passages
- La critique qui révise le brouillon et évalue la fraicheur, cohérence et fiabilité
A chaque étape de ce processus, une marque peut entrer dans la boucle et disparaitre avant que la réponse soit livrée à l'utilisateur. C'est une des principales limites de visibilité que ce modèle impose et que les outils ne peuvent mesurer.
Cinq brevets de Google posent cette architecture
Il est important de rappeler que cette architecture en boucle ne repose pas sur une théorie de praticiens, chaque étape de la boucle agentique a son propre brevet et en voici la liste :
| Mécanique de la boucle | Brevet | Ce qu'il décrit |
|---|---|---|
| Planificateur | US11663201B2 · WO2024064249A1 | La génération de variantes de requêtes |
| Routeur | US20240362093A1 | Le corpus sur mesure et ses appels d'API |
| Mémoire | US20240289407A1 | La conversation à état, qui persiste d'un tour à l'autre |
| Réflexion | US20250124067A1 | Le classement des passages par paires |
| Synthèse | US11769017B1 | Les résumés génératifs |
Ces brevets sont pour nous des indices de fonctionnement des systèmes de Google qu'il juge stratégiques, ils ne prouvent cependant pas comment ces derniers sont implémentés en phase de production. Toutes les plateformes concurrentes reposent sur un système comparable sans pour autant avoir déposé les mêmes titres.
Au-delà même des brevets, Sundar Pichai décrit publiquement le search sur Google comme un "gestionnaire d'agents" et ce pour les 3 systèmes actuellement les plus utilisés à savoir le Search classique, l'AI Overview et l'AI Mode. Cette architecture agentique tourne donc bien sur les modèles les plus répandus dans l'usage.
Cette architecture agentique se retrouve également chez Amazon sur AWS qui confirme dans sa documentation utiliser une récupération agentique qui décompose une requête complexe en sous-requêtes puis récupère par itération et auto-évaluation. La boucle s'opère jusqu'à trouver la réponse.
Il faut se rappeler enfin que ce mécanisme de boucle n'assure pas à lui tout seul l'ensemble du processus. Le modèle peut également faire appel à cette mémoire interne qu'il a reçue lors de son entrainement. Ce qui vient de la mémoire du modèle reste indépendant de ce processus et il est important de bien les distinguer.
3 observations majeures concernant la boucle
Pour aller au delà des études et brevets, nous allons voir quelques observations faites sur le fonctionnement concret de la boucle.
Le niveau de raisonnement décuple la récupération
Le niveau de raisonnement des modèles que l'utilisateur décide d'utiliser en amont influence fortement la mise en pratique de cette boucle.
Kevin Indig a mené une expérimentation sur 100 prompts posés 2 fois à ChatGPT en mode standard puis en mode raisonnement. Les résultats sont assez nets et le fan-out est multiplié par 4,6. La part de réponses avec citation passe de 50% à 68% dont les 3/4 des domaines cités ont changé.
Ce niveau de raisonnement que l'utilisateur choisit d'utiliser détermine le niveau de recherche du modèle et donc l'influence de la boucle agentique dans le processus de récupération. On avait déjà pointé ce paramètre comme responsable d'une forte variation des réponses d'un modèle à une même question qui pourra voir ses mentions et citations intégralement changer.
A l'inverse un raisonnement très bas ne sollicite plus la récupération et donc la boucle. C'est la mémoire du modèle qui prend le relais permettant une réponse instantanée à l'utilisateur.
La boucle dépend de ce que la récupération parvient à trouver
Même si la boucle assure une vérification et une relecture avancée, elle n'assure pas ce que la recherche web va permettre de trouver. Une contrainte technique peut entièrement affecter cette étape. Une page non indexée par les moteurs pourra être tout autant oubliée avec la boucle.
Dan Petrovic illustre ce constat avec 6 mois de logs relevés par métadonnées d'API qui exposent à la fois les sources retenues et écartées. L'exposition à Reddit varie selon les modèles et influence les résultats. Ce n'est donc pas une préférence pour un domaine qui le rend nécessairement plus cité mais son exposition face au modèle.
La boucle module la profondeur de récupération
En juin 2026, David Konitzny chez Peec test le mode Deep Research de ChatGPT qui exploite un agent pour effectuer des recherches avancées sur demande de l'utilisateur.
A chaque étape du raisonnement, le nombre de résultats baisse drastiquement. pour passer de 10 en phase de découverte à 2 en phase de vérification.
En résumé, plus la boucle se répète, plus la recherche s'étend et s'approfondit. Elle reste cependant limitée à ce à quoi elle est réellement exposée et une information non trouvée par recherche restera inexistante pour le moteur.
Le Graph RAG
En recherche organique, une page désigne un document et le moteur récupère des documents pour répondre aux requêtes des utilisateurs. Le RAG pipeline fonctionnait sur ce principe mais en récupérant des fragments de pages et des vecteurs.
Le Graph RAG selon Olaf Kopp consiste à placer la récupération et le raisonnement autour d'un graphe de connaissance structuré.
Des fragments isolés aux concepts reliés
Un graphe de connaissances associe des entités (entreprise, personne, concept ou produit) par le biais d'arêtes qui désignent la relation entre ces entités.
La récupération par graphe rassemble donc des concepts reliés entre eux.
Je vous propose un exemple d'extraction issu d'une phrase courte :
" Déployé par Google en 2020, GA4 remplace Universal Analytics depuis juillet 2023, Il se connecte nativement à Data Studio "
3 triplets en ressortent :
- GA4 déployé par Google
- GA4 remplace Universal Analytics
- GA4 se connecte à Data studio
Il faut bien comprendre que cette extraction fonctionne uniquement si les entités sont clairement nommées et que leurs relations sont fournies de manière explicite.
L'exemple que je propose désigne parfaitement les entités représentées et leurs liens respectifs. On peut y retrouver un triplet à savoir des entités, des relations et des attributs.
Ce que dit le paper de Microsoft Research
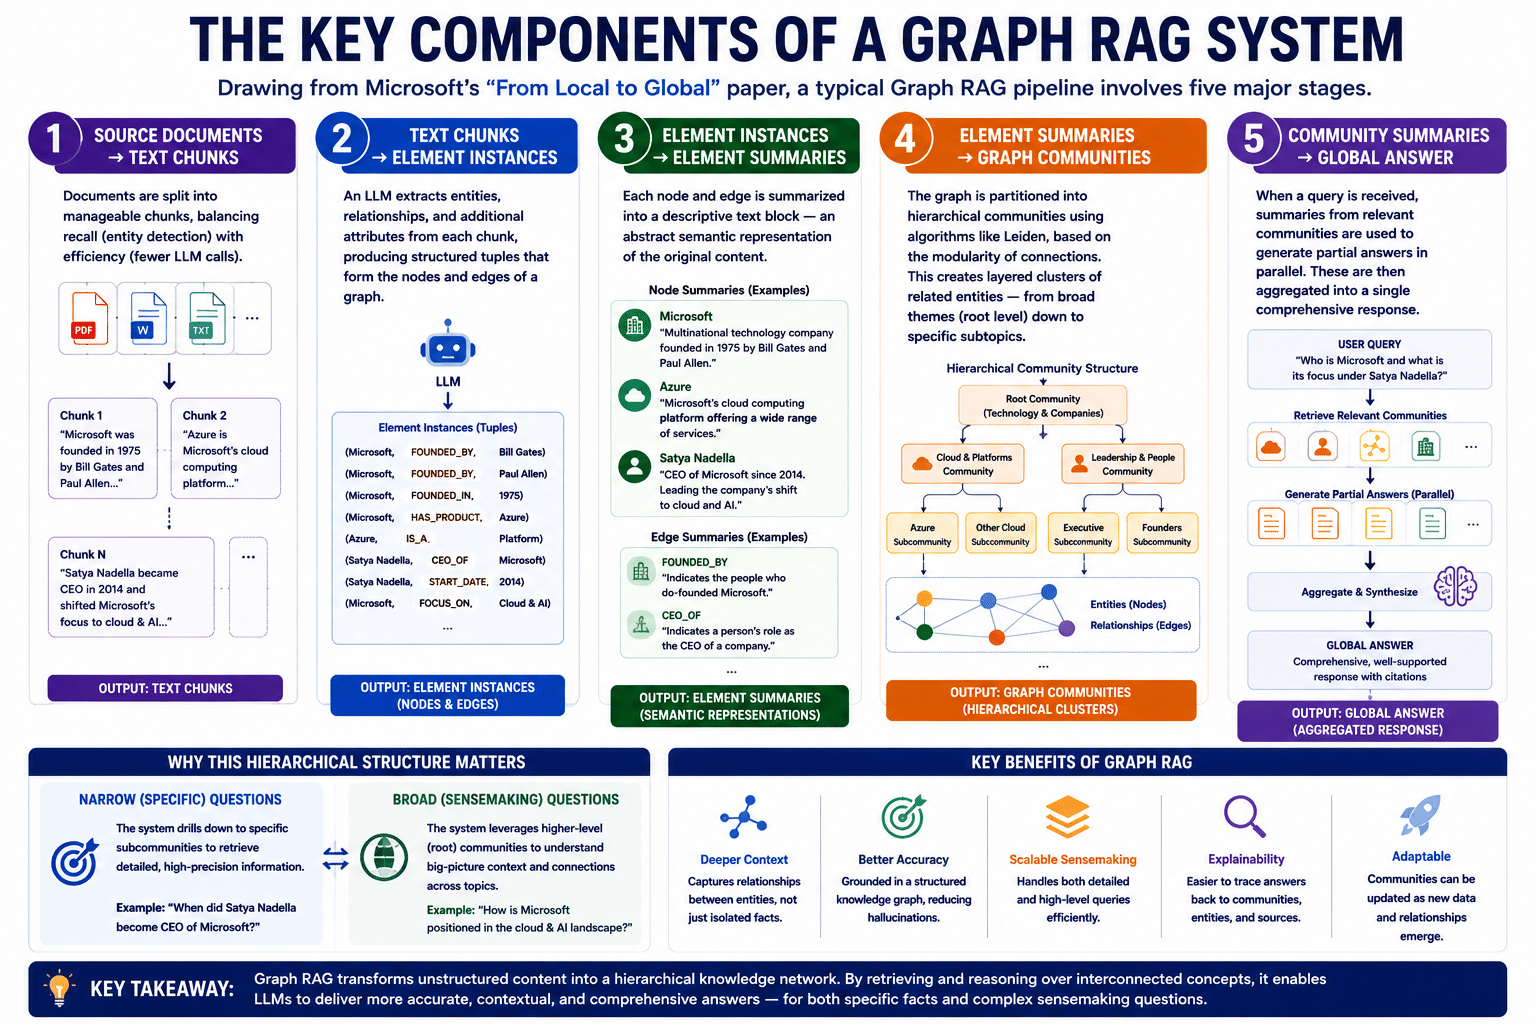
Nous avions évoqué auparavant ce paper de référence venant de Microsoft Research intitulé From Local to Global (Edge et al., 2024).
Ce pipeline mérite une analyse dédiée car il montre ce qu'un moteur peut faire d'un contenu.
- Chaque document source est découpé en fragments
- Chaque fragment extrait apporte entités, relations et attributs formant des triplets comme dans l'exemple plus haut
- Chaque entité et chaque relation se voit attribuer un résumé descriptif permettant de représenter ce que dit le document dans son ensemble.
- Le graphe est ensuite structuré en communautés hiérarchiques par un algorithme de détection (Leiden) des principales thématiques aux sous-sujets spécifiques
- Au moment de la requête, le système récupère les communautés les plus pertinentes de cette hiérarchie et génère des réponses à partir de ces groupes retenus.
DOCUMENTS
   │ découpage
FRAGMENTS
   │ extraction
TRIPLETS  entités · relations · attributs
   │ résumé par nœud et par arête
GRAPHE
   │ partition (Leiden)
COMMUNAUTÉS  racines ▸ fines
   │ résumés PRÉGÉNÉRÉS
INDEX PRÊT ── avant toute question
   │
REQUÊTE ─▶ réponses partielles ─▶ agrégée
Le principe est donc assez simple, selon la question, le système va approfondir sa recherche sur le document. Une question large sollicitera les niveaux supérieurs tandis que les questions précises solliciteront les communautés les plus spécifiques du document.
question pointue  ─▶ communautés fines
question globale  ─▶ communautés racines
Sur des corpus très longs de plus d'un million de tokens, l'évaluation de ce modèle montre qu'il est nettement plus performant que le RAG classique en termes d'exhaustivité et de diversité de réponses.
A noter que ce modèle est aujourd'hui maintenu en projet open source avec toute sa documentation, code et ligne de commande. Il est proposé sur 2 régimes avec la recherche globale et la recherche locale.
Les 4 familles du Graph RAG
Le Graph RAG se catégorise en 4 familles :
- Le graphe qui repose sur des ontologies prédéfinies comme les entités et relations issues d'un catalogue produit ou de données d'entreprise
- Le graphe extrait directement d'un document brut
- Le graphe hybride qui combine graphes pour la structure et vecteurs pour la similarité sémantique.
- Le graphe construit en temps réel lors d'une session utilisateur
A préciser au sujet du graphe hybride, que c'est la combinaison directe entre les représentations vectorielles qui permettent l'identification d'un nœud avec la traversée des graphes qui forment les relations entre ces nœuds.
QUESTION
   │ similarité (vecteurs)
   ▼
porte d'entrée : nœud GA4
   │ traversée (graphe)
   ▼
faits reliés : Google · UA · Data Studio
Google a déjà breveté un reclassement par graphe
Un reclassement de documents par graphe a fait l'objet d'un brevet de Google. Ce reclassement récupère des documents et les convertit en représentations capturant au passage les concepts et relations. Ces derniers sont reclassés avant d'être restitués au modèle au moment de sa réponse.
documents récupérés
   │ conversion en représentations graphe
   ▼
GNN - reclassement
   │     nœuds isolés × écartés
   ▼
LLM rédige
Boucle agentique et Graph RAG
On a jusque-là vu 2 concepts distincts avec d'un côté une boucle qui itère et un graphe qui relie les entités. Je propose de voir maintenant une notion importante qui relie ces 2 concepts.
Le raisonnement multi sauts
Une question multi-sauts est une question qui sollicite plusieurs recherches successives et dont la réponse dépend du résultat de la précédente question.
Je propose de reprendre notre exemple sur GA4 et de détailler les différents sauts au sein de la même question.
L'outil qui remplace Universal Analytics peut-il être visualisé dans Data Studio ?
- 1er saut : Universal Analytics est remplacé par GA4
- 2ème saut : GA4 se connecte à Data studio
Sur cet exemple, le RAG en un seul passage va échouer à 2 reprises car la question dans son intégralité ne propose pas des vecteurs qui s'imbriquent naturellement. Le premier saut révèle un remplacement d'outil et le second une compatibilité technique. Google Analytics 4 n'est pas nommée dans un premier temps et la 2ème question qui le concerne est donc bien dépendante de la première.
Quand la boucle agentique répond par itération, le graphe lui répond grâce à la structure et la traversée de ce graphe peut répondre à la seconde question sans engager une nouvelle recherche.
Je termine sur ce sujet en précisant bien que le raisonnement multi-sauts se distingue bien du principe de fan-out par son format séquentiel où chaque saut dépend du précédent.
Architecture de la recherche en 2026
On compte 3 modes de récupération, le RAG vectoriel, le Graph RAG et enfin la recherche web et la boucle agentique dont nous parlons dans cet article en est justement le pilote.
L'agent analyse l'intention derrière la requête et oriente chaque sous-requête vers le web pour la récupération en temps réel. Le RAG vectoriel lui prend en charge la proximité des intentions quelle que soit leur formulation. Enfin le graph rag suit les relations et les sauts.
               REQUÊTE
                  │
            AGENT (pilote)
          analyse l'intention
       ┌──────────┼──────────┐
       ▼          ▼          ▼
   Web Search   RAG        GraphRAG
   (le frais)   vectoriel  (relations ·
                (le sens)   multi-sauts)
       └──────────┼──────────┘
                  ▼
         suffisant ? ── non ─▶ relance
                  │
                 oui
                  ▼
               RÉPONSE
Je propose ici de voir comment chaque RAG se partage les typologies de contenu et on y voit bien le rôle de chacun. La boucle agentique est clairement celle qui sera le plus souvent utilisée dès que la complexité est de mise et c'est de plus en plus le cas avec les usages qui évoluent aujourd'hui.
| Usage | RAG classique | GraphRAG | Agentic RAG |
|---|---|---|---|
| FAQ simple | 🟢 | 🟡 | 🟡 |
| Documentation | 🟢 | 🟡 | 🟢 |
| Question factuelle | 🟢 | 🟡 | 🟡 |
| Relations entre entités | 🟡 | 🟢🟢 | 🟢 |
| Raisonnement multi-sauts | 🔴 | 🟢🟢 | 🟢🟢 |
| Compréhension d'un corpus entier | 🔴 | 🟢🟢 | 🟢 |
| Recherche web complexe | 🔴 | 🔴 | 🟢🟢 |
| Plusieurs bases de données | 🟡 | 🟡 | 🟢🟢 |
| Web + fichiers + API | 🔴 | 🔴 | 🟢🟢 |
| Deep Research | 🔴 | 🟡 | 🟢🟢 |
| Recherche en temps réel | 🟡 | 🔴 | 🟢🟢 |
Plusieurs papers de recherche s'intéressent à l'assemblage du graphe et de la boucle agentique
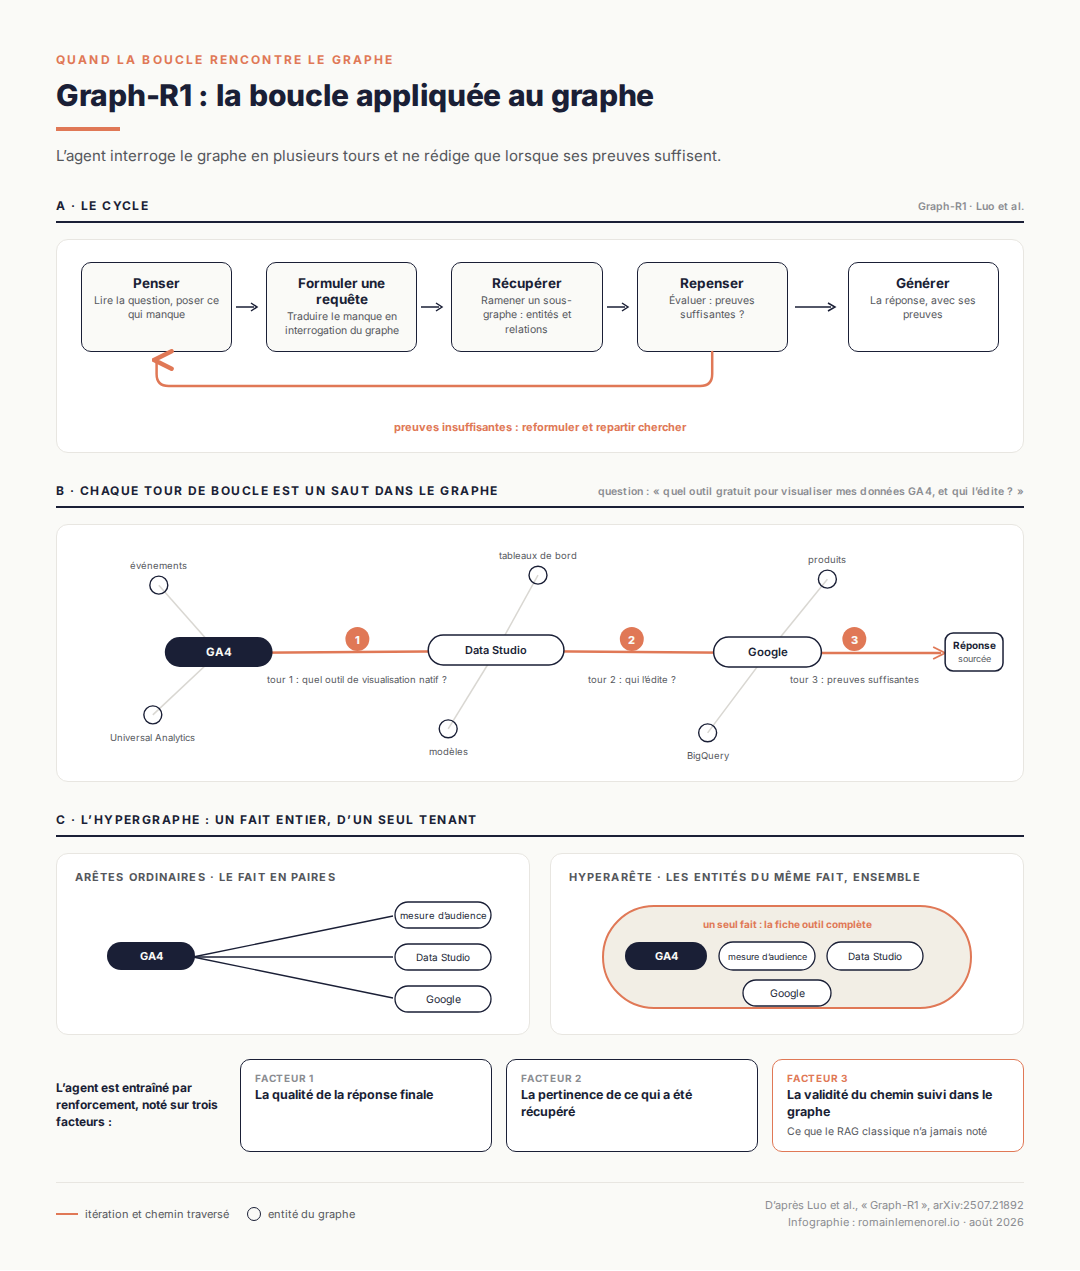
Graph-R1 (Luo et al.)
Analyse la récupération sur une conversation multi-sauts et un hypergraphe qui relie toutes les entités entre elles. Ce modèle surpasse les Graph RAG classiques sur les questions multi-sauts.
 Haoran Luo
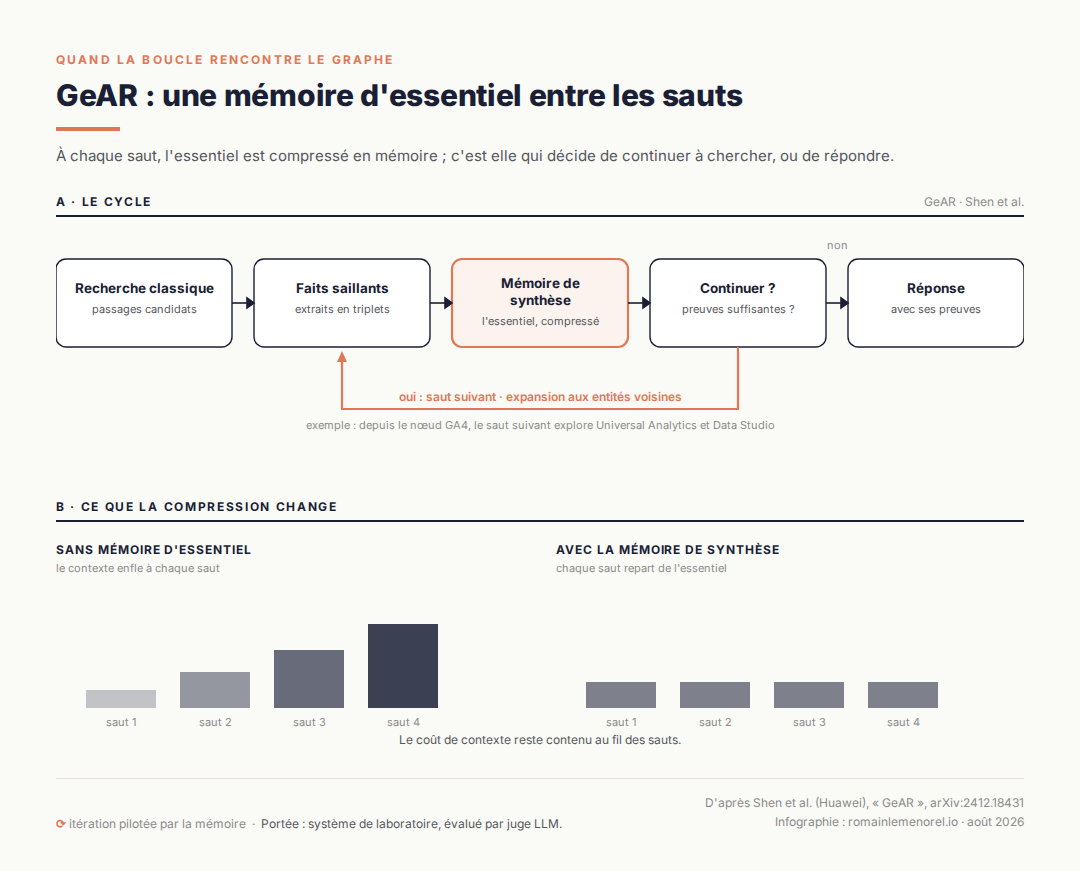
GeAR (Shen et al., Huawei)
Une mémoire compresse chaque information de chaque saut et décide de poursuivre la recherche. Ce modèle se distingue par ses performances sur les questions multi sauts et cela à coût de tokens plus réduit.
 Zhili Shen
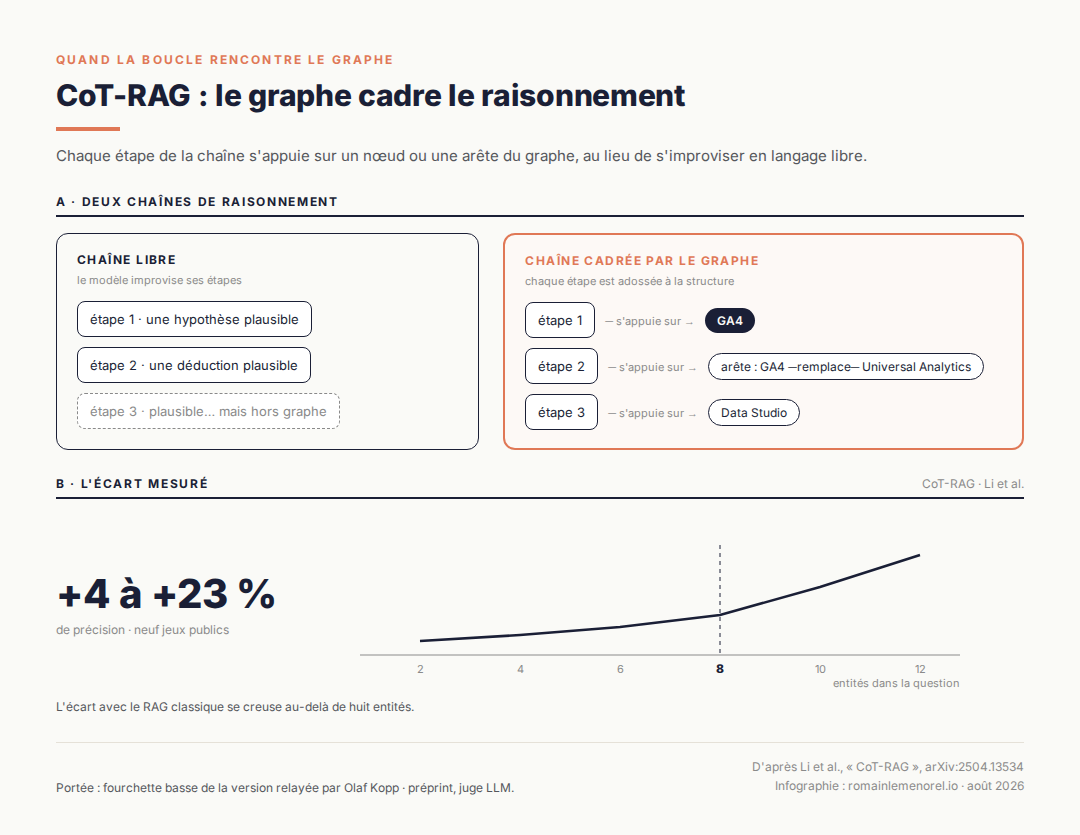
CoT-RAG (Li et al.)
Le graphe guide la chaîne de raisonnement et limite l'improvisation
Ce modèle gagne en précision quand la question sollicite plus de 8 entités.
 Feiyang Li
Entités-ponts et sous-graphes
Quand 2 contenus sont reliés par un concept canonique
2 notions qui servent à relier des concepts entre eux sont utilisées. Si une itération qui porte sur une entité A désigne une autre entité B, les 2 entités peuvent être citées alors que l'utilisateur n'a pas directement cherché ces 2 entités. La seconde est apparue car elle canonique de l'autre. C'est ce que Mike King appelle les entités ponts (bridge entities) et il considère qu'il s'agit d'un des leviers de visibilité IA les moins exploités à ce jour.
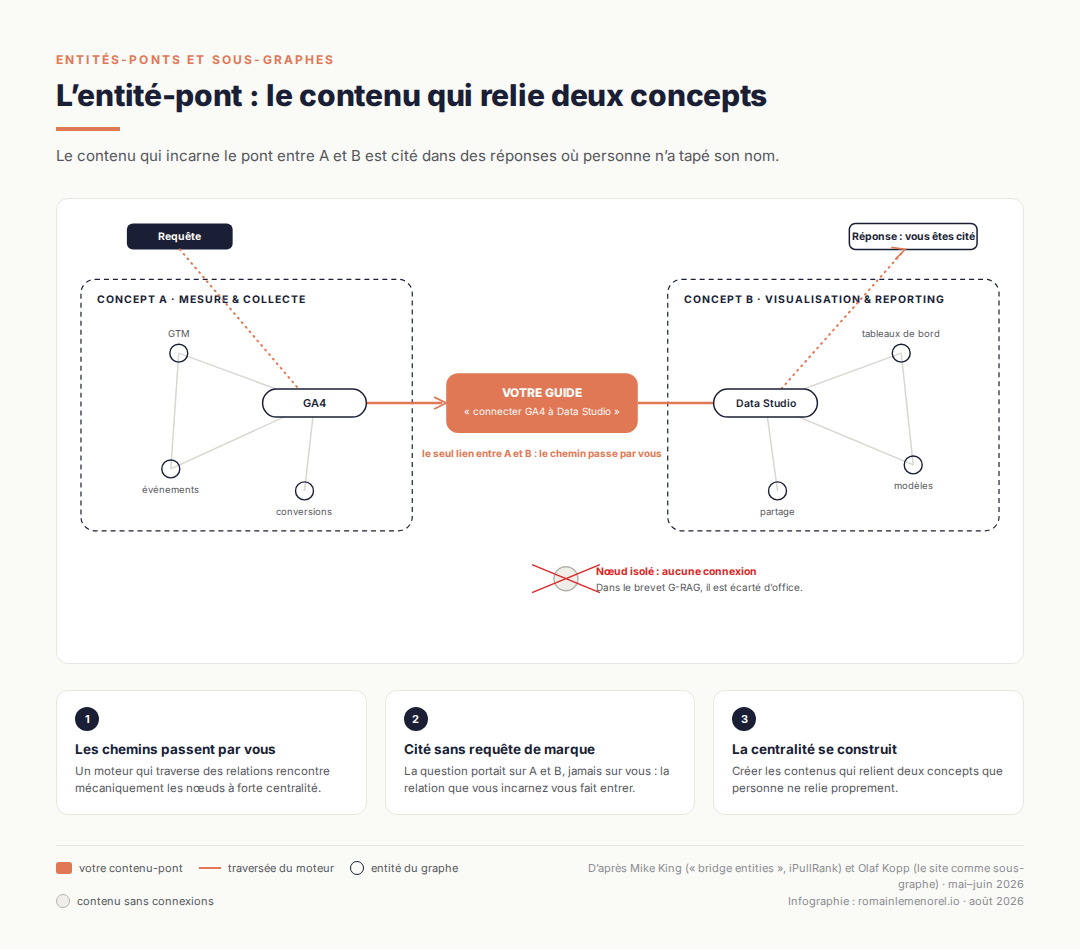
Pour Kopp, il présente ce même concept différemment où un site représente un sous-graphe qui représente lui-même un réseau de connaissances constitué d'arêtes et de nœuds.
Ces 2 formulations désignent un concept assez proche. L'entité pont est un nœud central par lequel les connexions passent. Le sous graphe désigne l'élément central par lequel les relations canoniques passent.
6 bonnes pratiques à retenir de ces 2 concepts
On l'a compris, ce qui nous intéresse dans cette analyse n'est pas la désignation de ces 2 concepts mais ce qu'on peut en faire concrètement lorsque l'on travail d'optimisation pour les moteurs.
6 bonnes pratiques en ressortent et deviennent un axe d'optimisation clé :
- Mettre en avant les relations entre entités par des formulations explicites et claires
- Clairement nommer chaque entité avec le plus de précision pour son identification
- Couvrir efficacement le fan-out sur une même page
- Travailler les ponts qui relient vos pages et les entités qui y sont mentionnées.
- Dater et sourcer les contenus
- Une information structurée et accessible
La mesure de visibilité reste limitée par la capacité des outils
Nous n'allons pas revenir en détails sur la mesure de visibilité IA et ses limites.
La boucle agentique passe par des étapes que les outils du marché ne peuvent analyser
Si une marque entre dans la boucle et en ressort avant la réponse, le suivi n'en saura rien et la conclusion sera la même que lorsqu'une marque est totalement absente.
C'est une limite qui rend l'interprétation des résultats plus difficile car on ne peut évaluer que le résultat final et non ce qui s'est passé entre la question de l'utilisateur et la réponse du modèle.
Reproduire une boucle locale avec la distillation
Pour répondre à cette problématique de suivi, Mike King a proposé une solution consistant à reproduire une boucle agentique au niveau local qu'il a d'ailleurs appelée distillation.
Il y utilise un agent qui suit les enchainements de la boucle que l'on a vu précédemment.
Ce test a été publié sur GitHub avec Gemma 4 comme modèle en local, l'exécution intégrale de la boucle agentique et enfin des résultats de recherche en entrée.
Pour chaque test, il en ressort une exécution complète et entièrement analysable.
Il peut donc voir où la marque entre et sort de la boucle. Le but est bien entendu d'en déduire une meilleure compréhension
J'illustre ci-dessous un exemple de sortie d'analyse :
Requête : « meilleur outil de dashboard
            gratuit pour GA4 »

sous-requêtes (planification)
 Q1 comparatif dashboards GA4 2026 ▶ 12 passages
 Q2 connecter GA4 à Data Studio    ▶  9
 Q3 alternatives à Data Studio     ▶  7

votre page : /blog/guide-data-studio-ga4
 récupération   OK   Q1 rang 4 · Q2 rang 6
 paires         KO   perd 5/7 (Q1) · 3/4 (Q2)
 critique       non atteinte

▶ récupérable · perd au reclassement
Soyons clairs et rappelons que cette méthode sert principalement à mieux comprendre à quelle étape votre marque entre ou sort et d'en déduire des conclusions selon ces données.
Cela peut nuancer un rapport qui annonce que votre marque est absente sur une requête.
En conclusion
L'émergence des systèmes IA impose de mieux comprendre leur fonctionnement afin de mieux comprendre ce qui peut influencer une mention ou citation.
Comprendre la boucle agentique ou le graph rag ne suffit pas à définir une stratégie mais cela confirme ce qui est essentiel et permet d'appuyer un raisonnement dans la structuration de vos contenus.
La logique d'optimisation de vos contenus se dessine et suit des règles qui répondent aux mécanismes des LLM.
Sources :
 Mike King
 Olaf Kopp