Ce que la détectabilité change pour vos stratégies de contenu

En seulement quelques semaines, la détection de contenu généré par IA est passée d'un simple outil à toute une infrastructure de contrôle, mais aussi de transparence.
Nous l'avons vu s'intégrer à une plateforme très réputée de lecture, mais également sur exigence du droit européen et elle est aussi devenue une propriété du texte par défaut chez un fournisseur de modèles.
Cet article vous concerne si vous pratiquez l'écriture de contenu par IA et surtout si votre stratégie d'acquisition repose sur ce levier.
En quelques semaines, la détection de l'IA s'est généralisée
Le 21 juillet 2026, Substack a intégré Pangram dans sa plateforme. Pour ceux qui ne connaissent pas Pangram, il s'agit d'un détecteur de contenu IA.
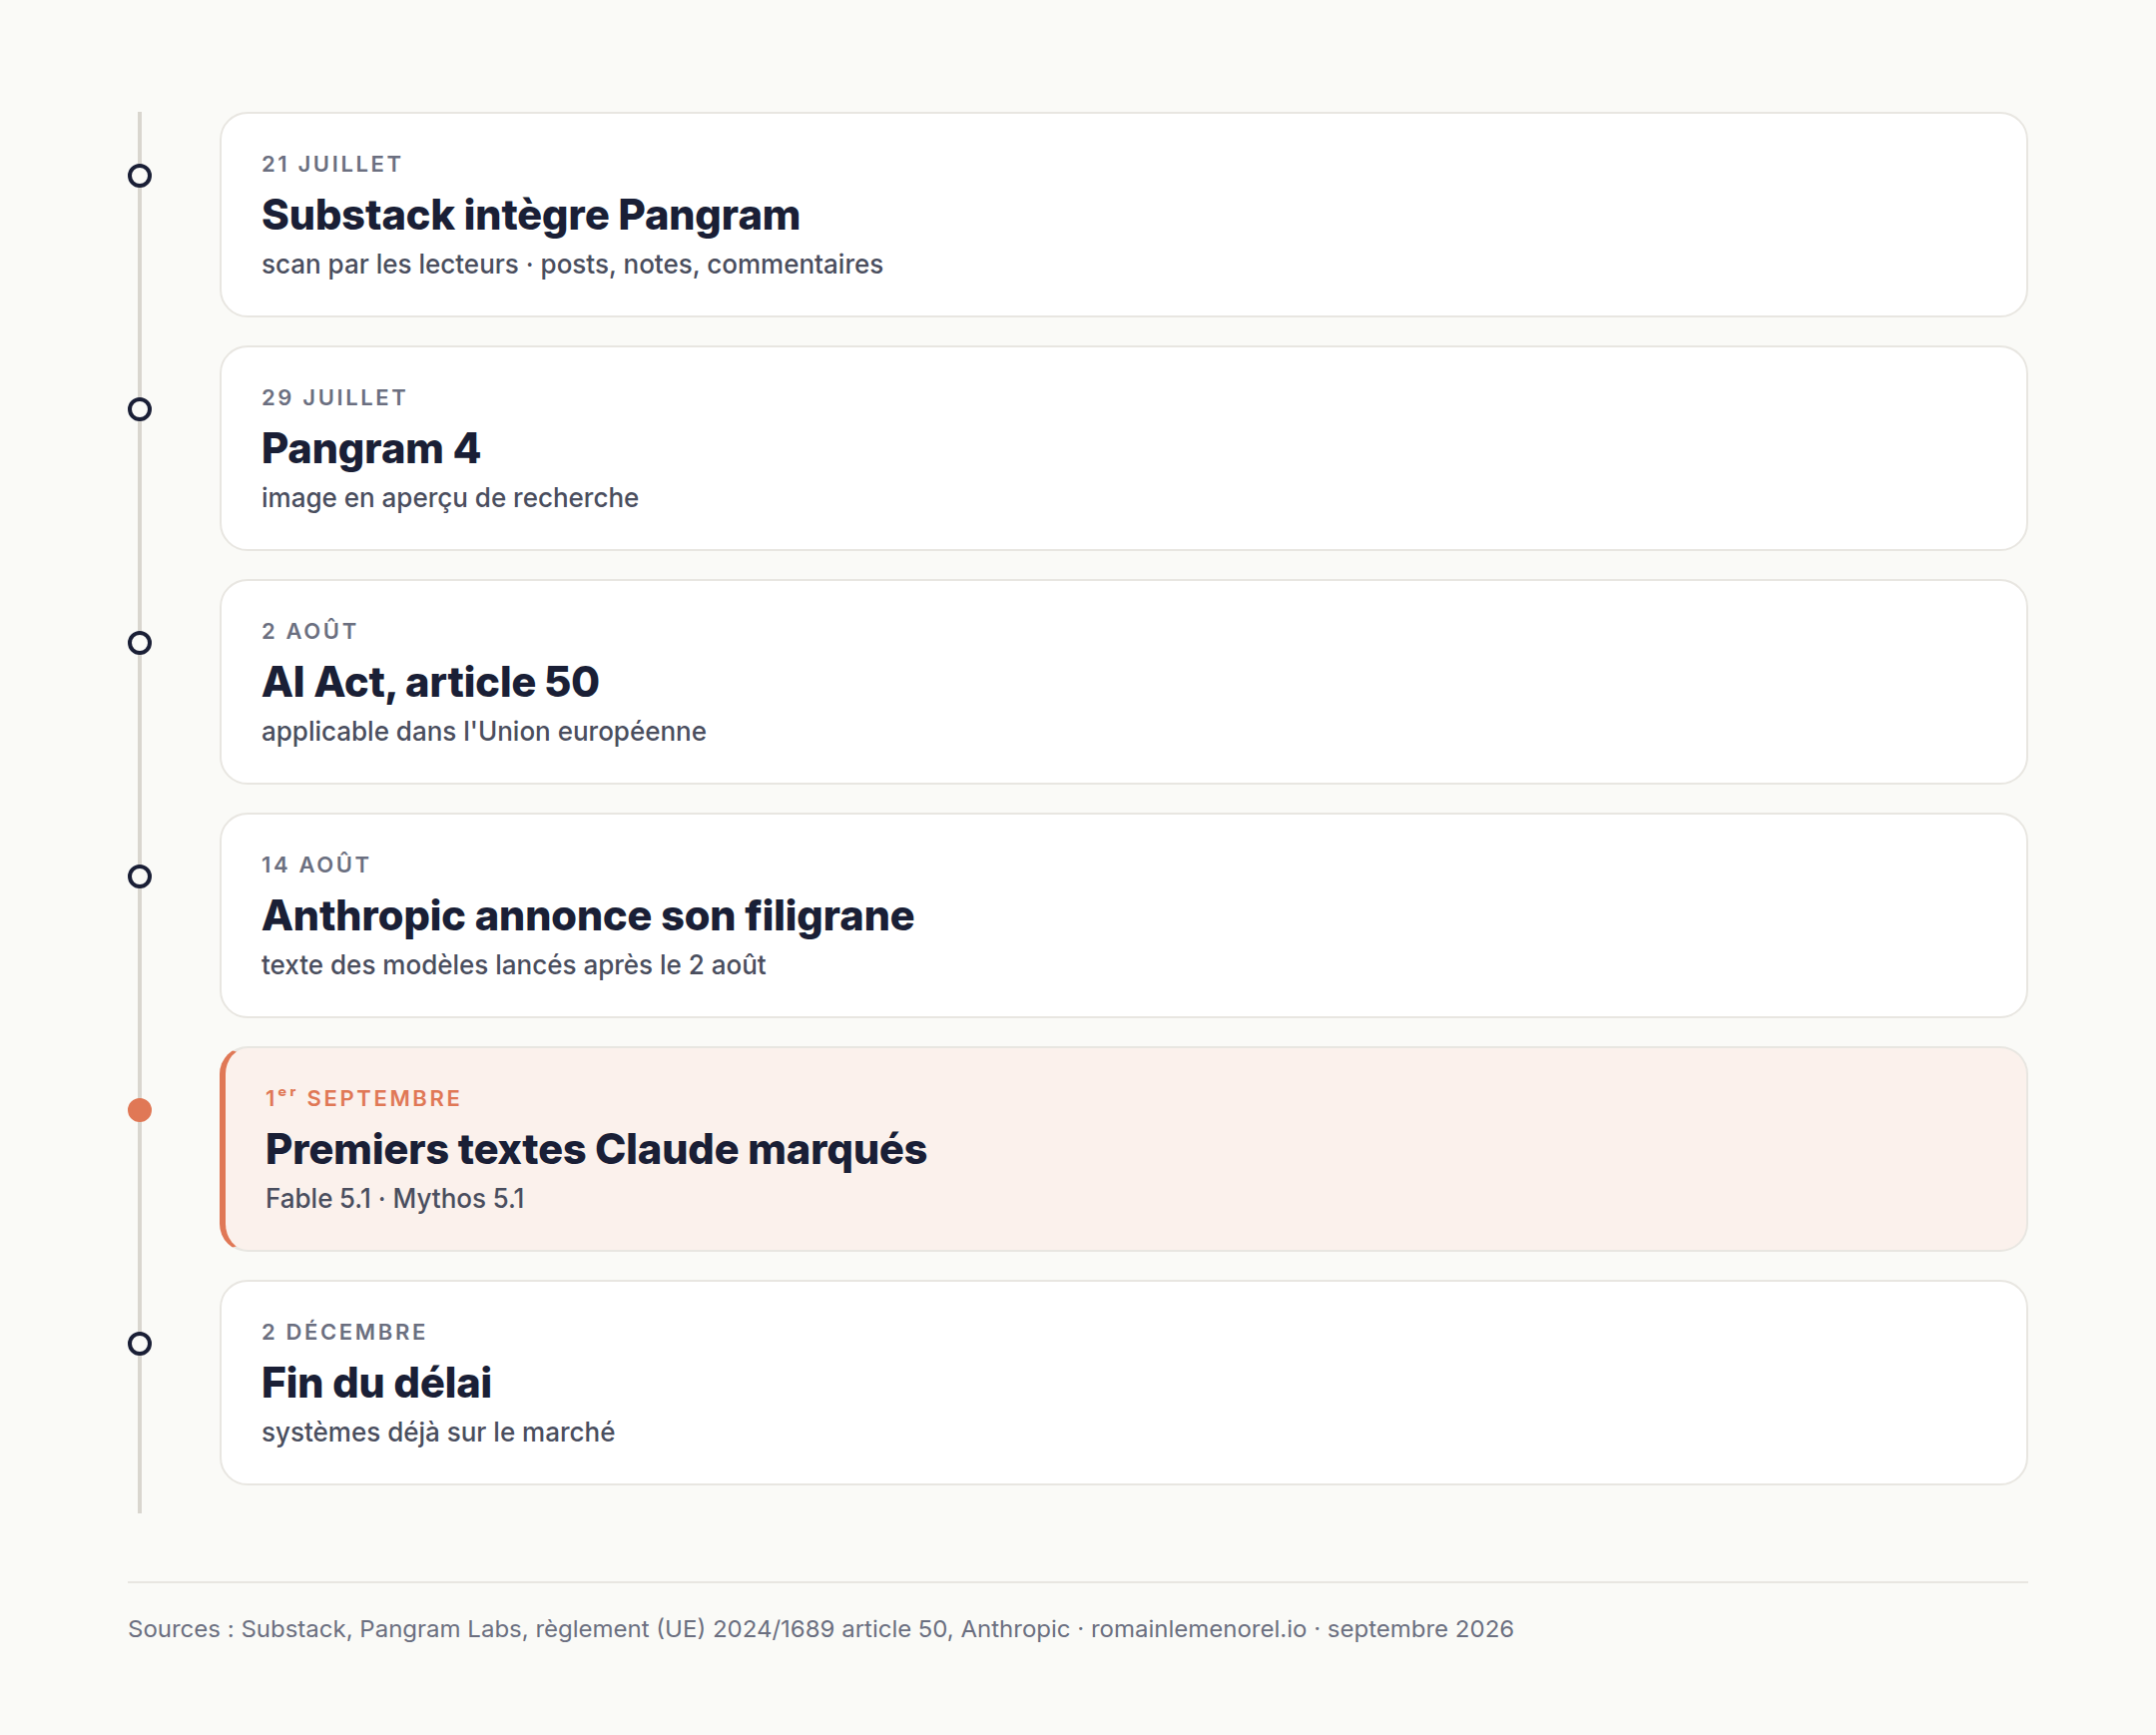
Cette intégration permet désormais à tout utilisateur de scanner un post, une note ou un commentaire sous condition que celui-ci soit publié après le 21 juillet et qu'il fasse plus de 100 mots.
Le résultat donne un pourcentage sur trois étiquettes distinctes : IA, assisté par IA et humain. Chaque lecteur, mais aussi chaque auteur peut utiliser ce test pour mesurer son score respectif et s'assurer du résultat. Si un auteur est assisté par IA lors de sa rédaction, il peut évaluer ainsi son pourcentage d'humain.
Substack propose le scan de détection accompagné d'une note de déclaration dans laquelle l'auteur déclare sa méthode de rédaction. L'auteur fait donc le choix de transparence ou non sur sa méthode, la détection n'est pas imposée.
On se doute cependant qu'un auteur a tout intérêt à la laisser active pour rester transparent sachant que le contenu peut toujours être testé en dehors de la plateforme.
Dès le 2 août, l'Union européenne a imposé une obligation de transparence sur le contenu rédigé par IA par le biais de l'AI Act. Parallèlement, Anthropic a annoncé avoir mis en place, dès le 1ᵉʳ septembre, un filigrane statistique (aussi appelé watermark) qui permet la détection d'un contenu venant de ses modèles de langage. Enfin, Pangram lance la version 4 de son algorithme de détection qui reste l'un des plus performants à ce jour.
Ces différentes actualités qui portent sur la détectabilité du contenu IA soulèvent des questions autour des stratégies de contenu qui reposent sur l'IA. La détection est désormais possible avec des garanties très élevées de certitude. On peut se demander si prochainement, la détection des contenus affectera le classement des pages sur les leviers organiques et même la citation sur les différentes plateformes IA. Pour le moment, rien ne le confirme, mais l'hypothèse reste crédible et les enjeux pour de nombreuses marques sont majeurs.
Ce que Pangram fait vraiment
Je prends Pangram pour deux raisons, la première est que c'est cet algorithme qui m'a sensibilisé sur ce sujet dont nous parlons ici. La seconde raison est qu'il est très bien documenté sur son site afin de mieux comprendre comment il fonctionne et enfin pour comprendre à quel point cette méthode est fiable.
La détection est une identification d'auteur
Il faut bien se le rappeler et c'est la problématique qui se pose ici, l'intelligence artificielle n'est pas humaine, n'a pas de vécu qui caractérise les écrits d'un blog. En revanche un modèle de langage a un entrainement et c'est celui-ci qui définit son style d'écriture et le choix des mots qui ressort à chaque sollicitation.
La détection fonctionne donc en cherchant ces styles d'écriture qui sont propres aux différents modèles de langage. Ce style de langage laisse des traces partout dans un texte et ce principe est inévitable quelles que soient vos consignes ou instructions dans le brief.
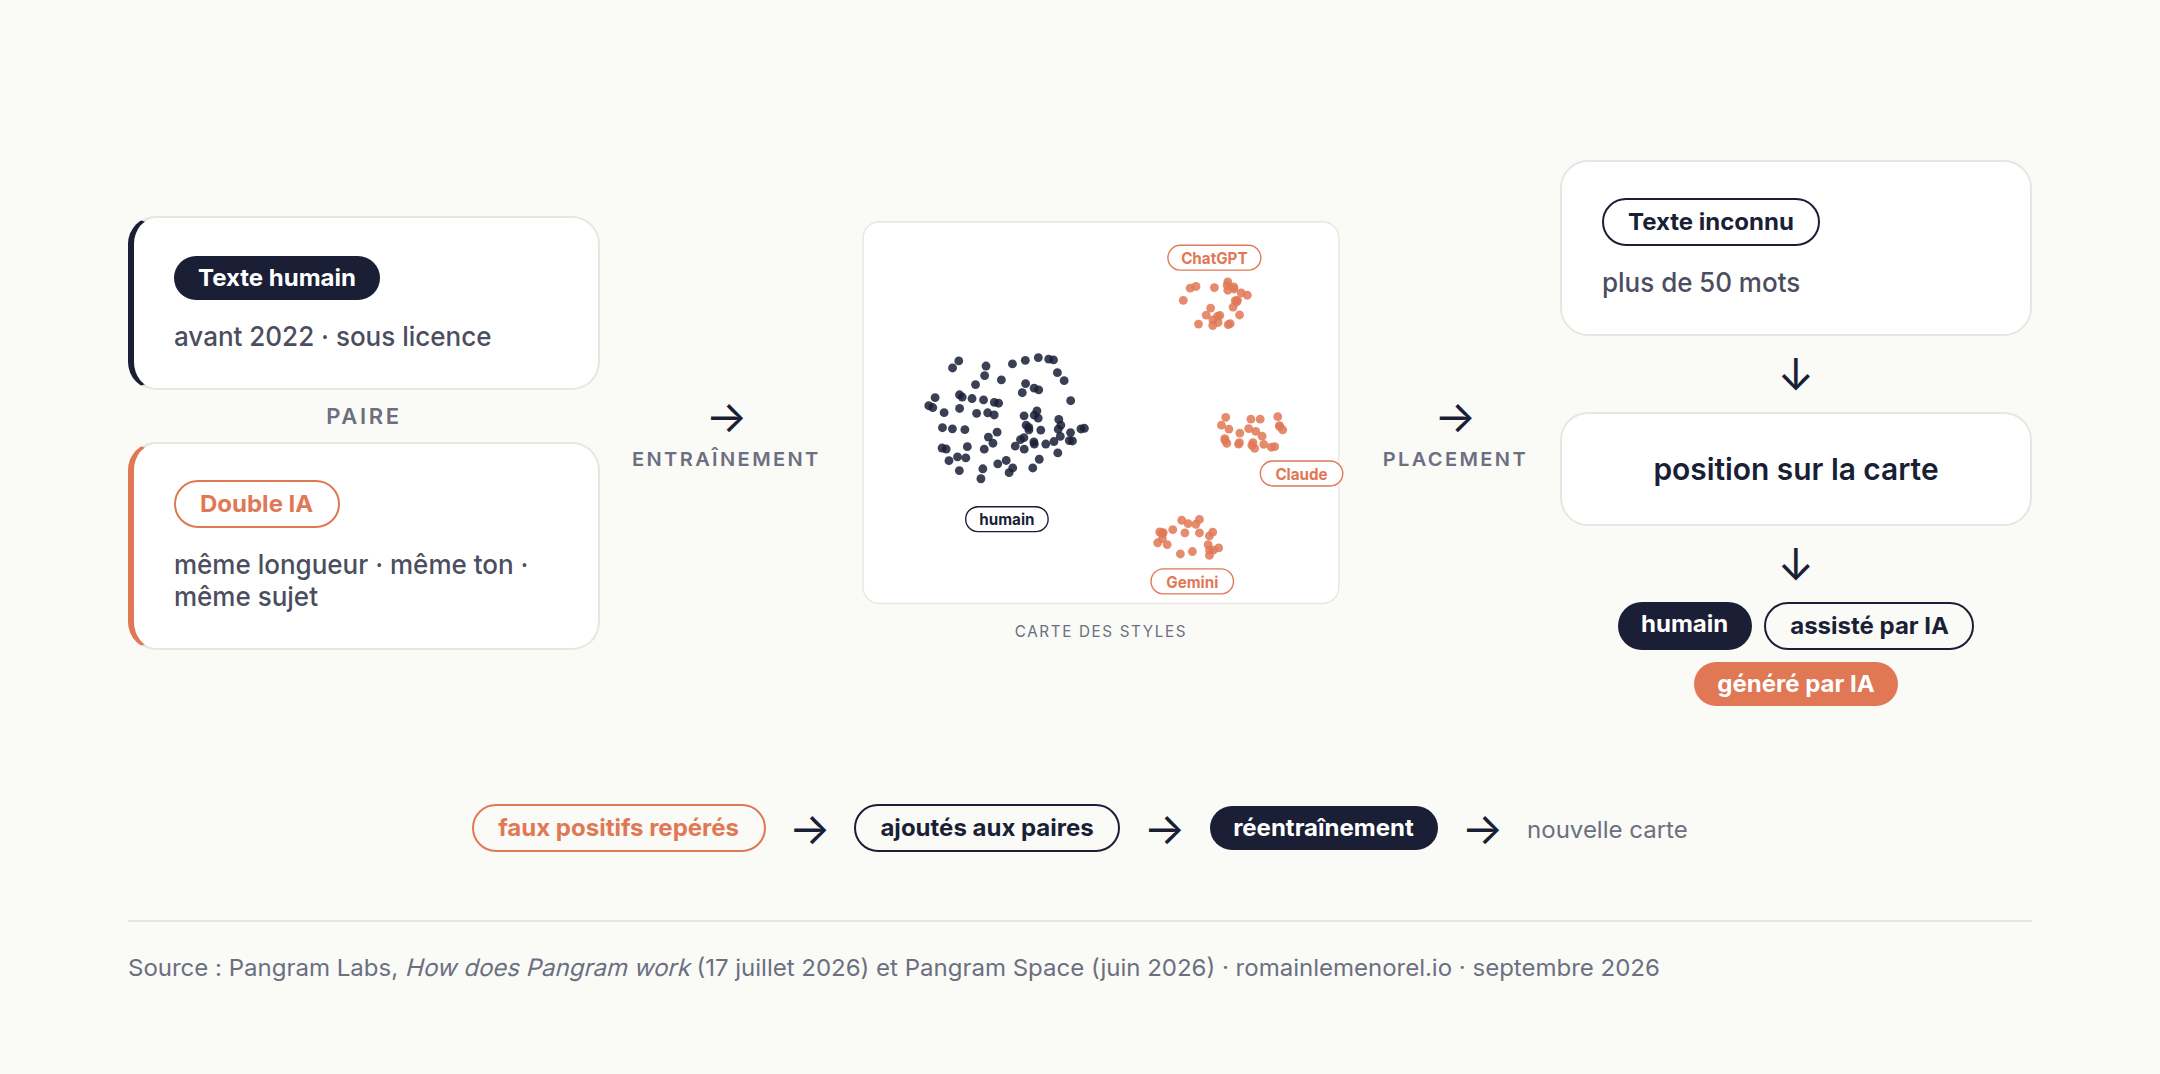
Pour bien expliquer, le classifieur de Pangram définit une carte des styles d'écriture. Et bien entendu ces signaux de styles se comptent par centaines de milliers afin de garantir une reconnaissance fiable d'un modèle IA contre un humain qui peut utiliser des styles pouvant se rapprocher de l'IA.
Deux constats ressortent de cette analyse :
- Le nombre de mots facilite la détection par Pangram qui trouvera et cumulera plus facilement les repères d'un style d'une IA
- Les styles d'écriture des modèles se transmettent ce qui facilite la détection quel que soit le modèle utilisé
Les détecteurs n'ont pas toujours été fiables
En 2023, un détecteur d'IA avait généré une polémique, car il fonctionnait par un système de déduction de mots qu'une IA pourrait utiliser. Des choix trop prévisibles entrainaient des résultats positifs.
La génération de faux positifs a suscité cette polémique et remis en question cette faisabilité de détecter l'IA dans les contenus de manière fiable.
Ce qu'on retrouve aujourd'hui est une tout autre histoire et la fiabilité, on le verra, est nettement supérieure.
La méthode d'apprentissage de Pangram qui le rend si fiable
Pangram fonctionne par le biais d'un entrainement tout comme les LLM mais cet entrainement ne sert pas le même objectif. Pour Pangram, il consiste à analyser des textes par paire en comparant un texte humain et sa variante faite par IA.
Ce procédé répété des milliers de fois entraine Pangram à distinguer le langage d'un modèle de celui d'un humain. L'objet de l'analyse réside uniquement dans la manière d'écrire et non dans son contenu.
Les textes humains qui ont servi de référence ont été produits avant 2022, donc juste avant l'émergence de l'IA sur le web. Ces textes sont également sous licence.
Pangram couple cet apprentissage avec une traque des faux positifs qui permet à Pangram de perfectionner sa détection et limiter les erreurs qui peuvent radicalement remettre en question cet algorithme.
Le schéma ci-dessous résume bien ce cycle d'apprentissage de Pangram :
À chaque version sortie de Pangram, les résultats sont publiés et la version 4 sortie le 29 juillet sert aujourd'hui de référence. Les tests portent d'abord sur les faux positifs et pour cela, plus d'un million de pages écrites par des humains en anglais ont été testées. Le taux de faux positifs était de seulement 0,0041 %, ce qui représente une page sur 24 000. Cette haute performance justifie parfaitement l'implémentation de cette solution sur Substack qui répond à un besoin de transparence tout en minimisant les risques de faux positifs (situation la plus problématique face à ces outils).
Pangram 4 effectue un test par découpage en segments et attribue à chaque segment l'une des trois étiquettes :
- Humain
- Assisté par IA
- Généré par IA
La mesure se fait sur l'ensemble et sur Substack, on ne peut voir l'analyse détaillée des passages marqués comme étant écrits par IA. L'accès à un rapport détaillé nécessite un compte propre sur Pangram.
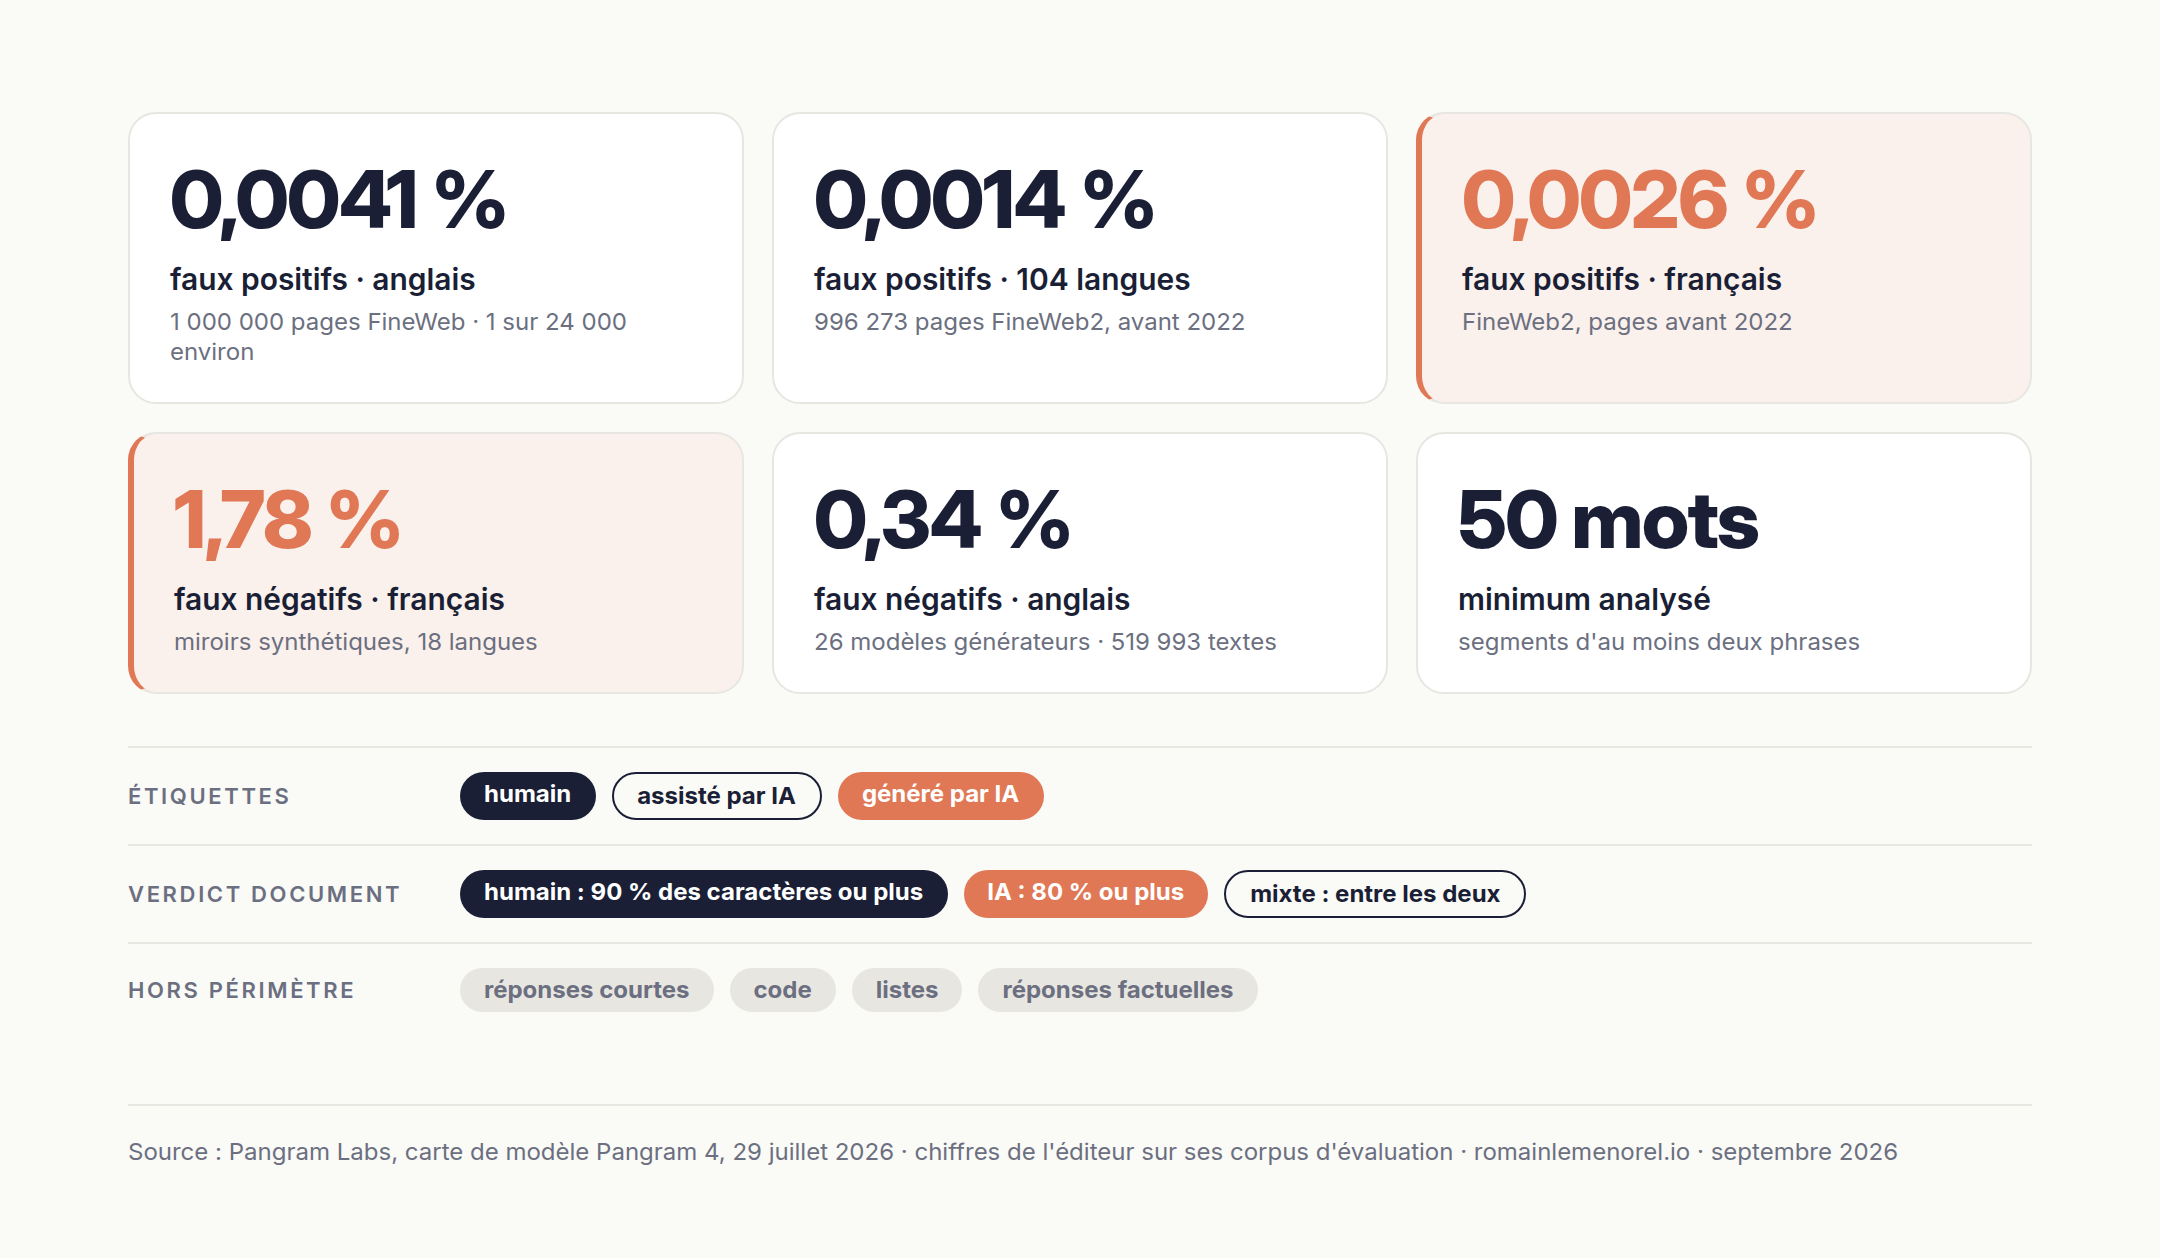
La mesure tient sous certaines conditions, le texte doit faire au moins 50 mots, les tableaux, listes à puces et blocs de code restent non pertinents pour l'analyse et peuvent fausser le résultat.
Malgré ces études, quelques réserves sont encore émises par des utilisateurs notamment sur Substack avec les faux positifs que certains utilisateurs affirment et qui posent un problème évident de crédibilité. La fiabilité de l'algorithme dépend beaucoup du format, de la longueur et de la langue aussi.
La carte complète de la détection
Je propose maintenant de voir les cartes de détection par typologies de contenu.
Les cartes de détection pour le texte
Commençons par les contenus qui sont les plus touchés par ces tests.
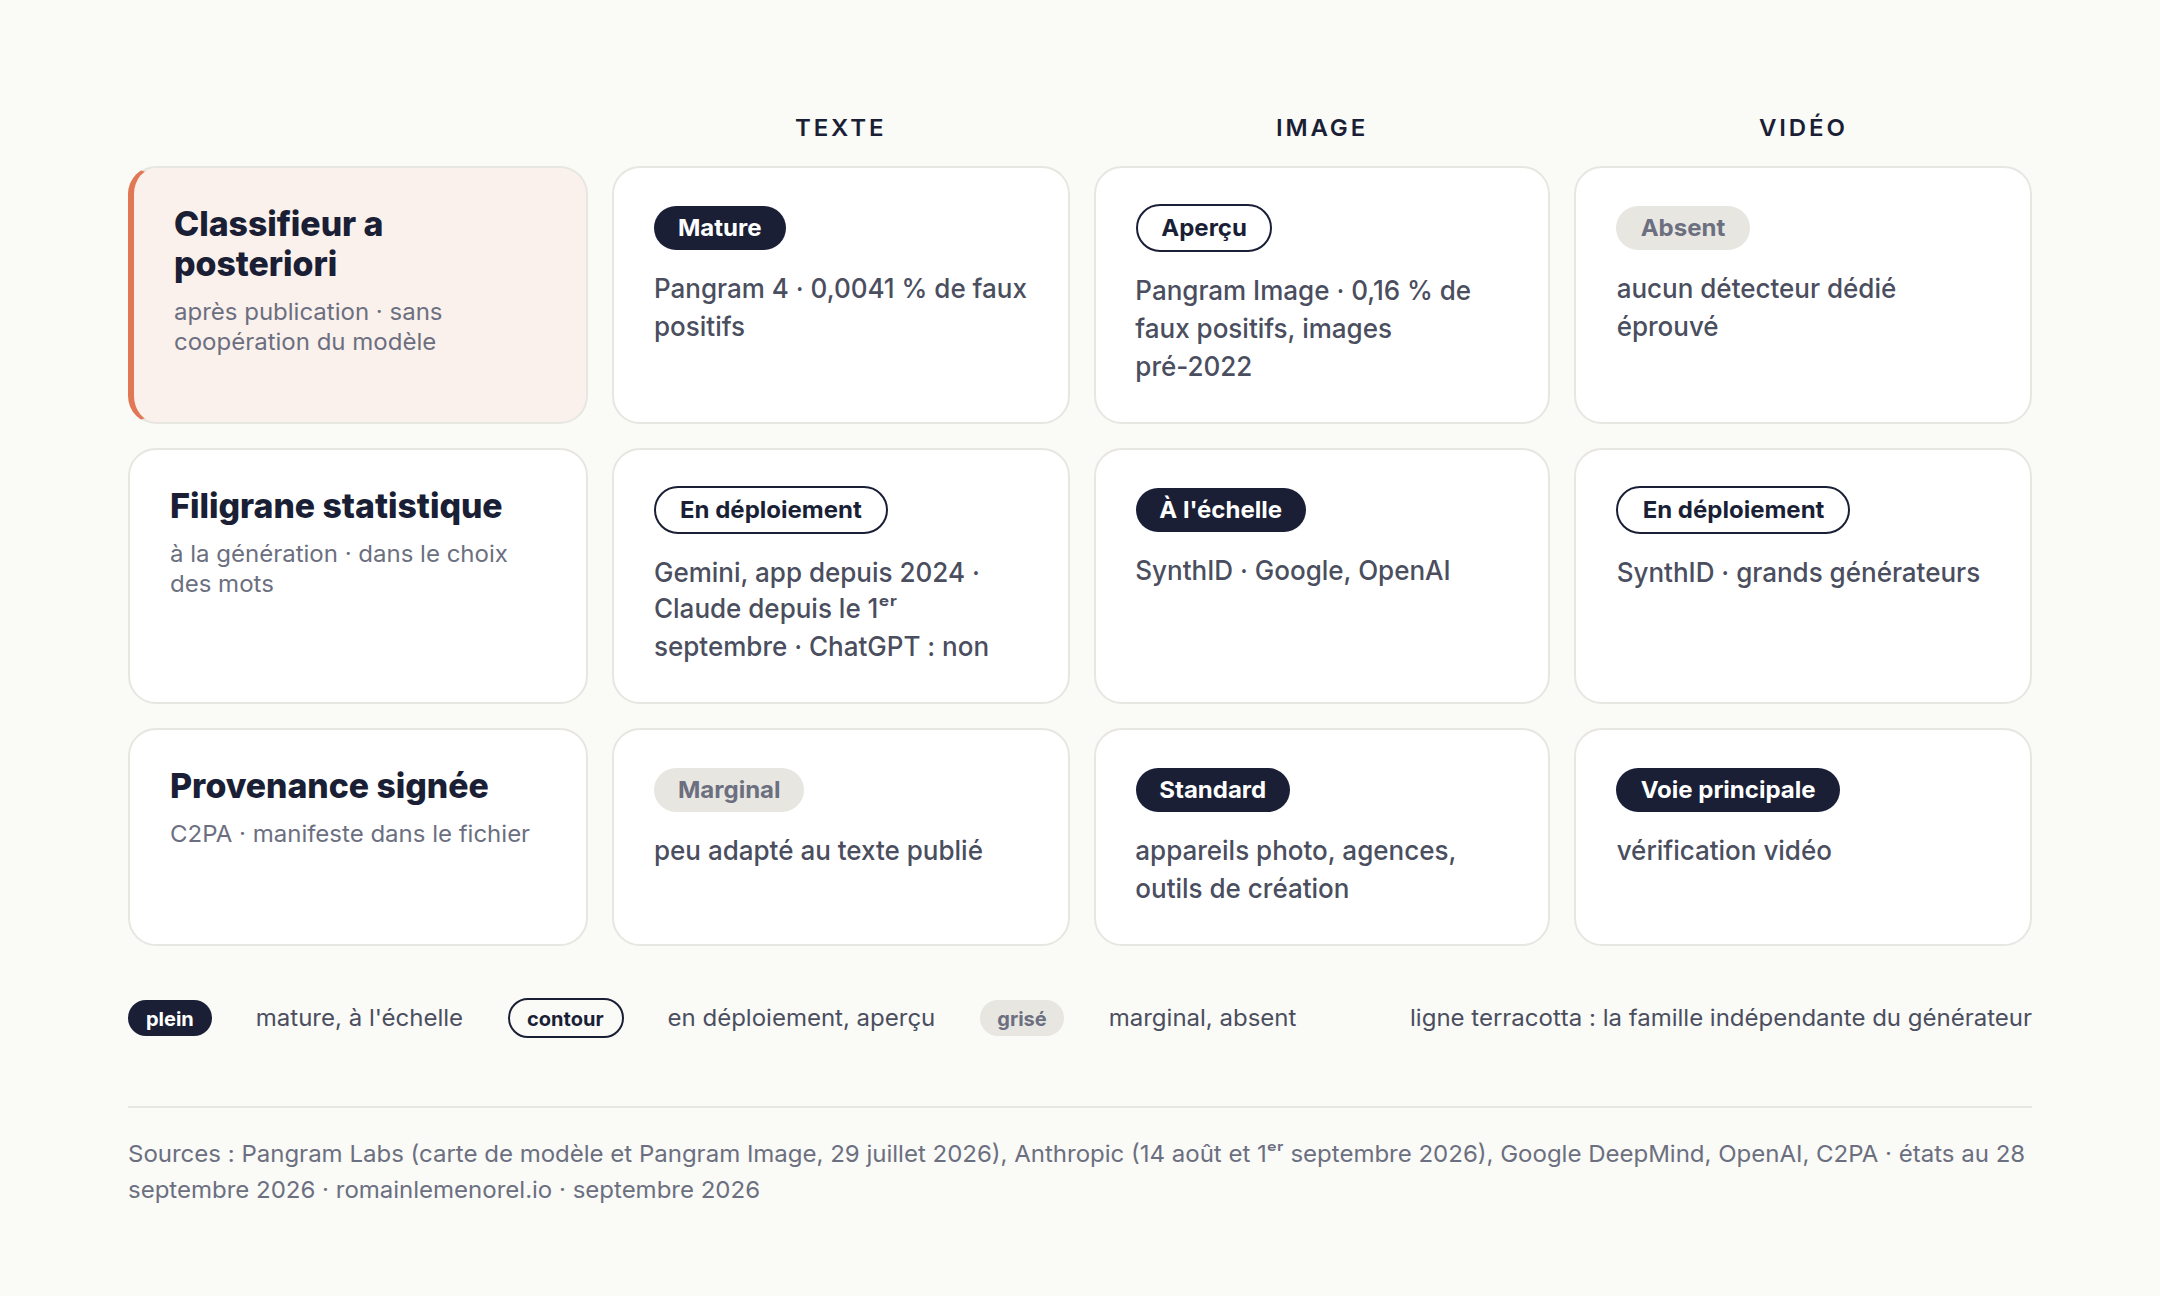
La première famille se fait après la génération et permet une analyse de tout contenu après sa génération par le modèle quelle que soit sa date de création. Celle-ci est 100 % rétroactive.
Il y a ensuite le marquage à la génération que l'on appelle aussi watermarking qui insère un signal statistique lorsque le modèle rédige un contenu. Un bon exemple est SynthID-Text déployé dans Gemini. Ce watermarking résiste aux retouches de texte sauf si celles-ci sont majeures. Anthropic a également déployé un équivalent, dérivé de SynthID-Text à partir du 2 août sur l'ensemble de ses modèles.
La situation est un peu différent côté OpenAI qui dispose d'un filigrane de texte, mais qui n'est pas activé pour des raisons commerciales. Bien que le code de pratique européen soit signé depuis juillet 2026, aucune confirmation encore que les sorties des modèles d'OpenAI soient marquées. L'échéance est fixée au 2 décembre 2026.
C'est d'ailleurs un sujet qui démontre tout l'enjeu qui repose sur ce changement qui s'impose à nous depuis plusieurs semaines.
Qu'en est-il des images et vidéos ?
Les images et les vidéos sont également l'objet de productions par IA provoquant beaucoup de contenu trompeur ou généré sans effort ni compétence.
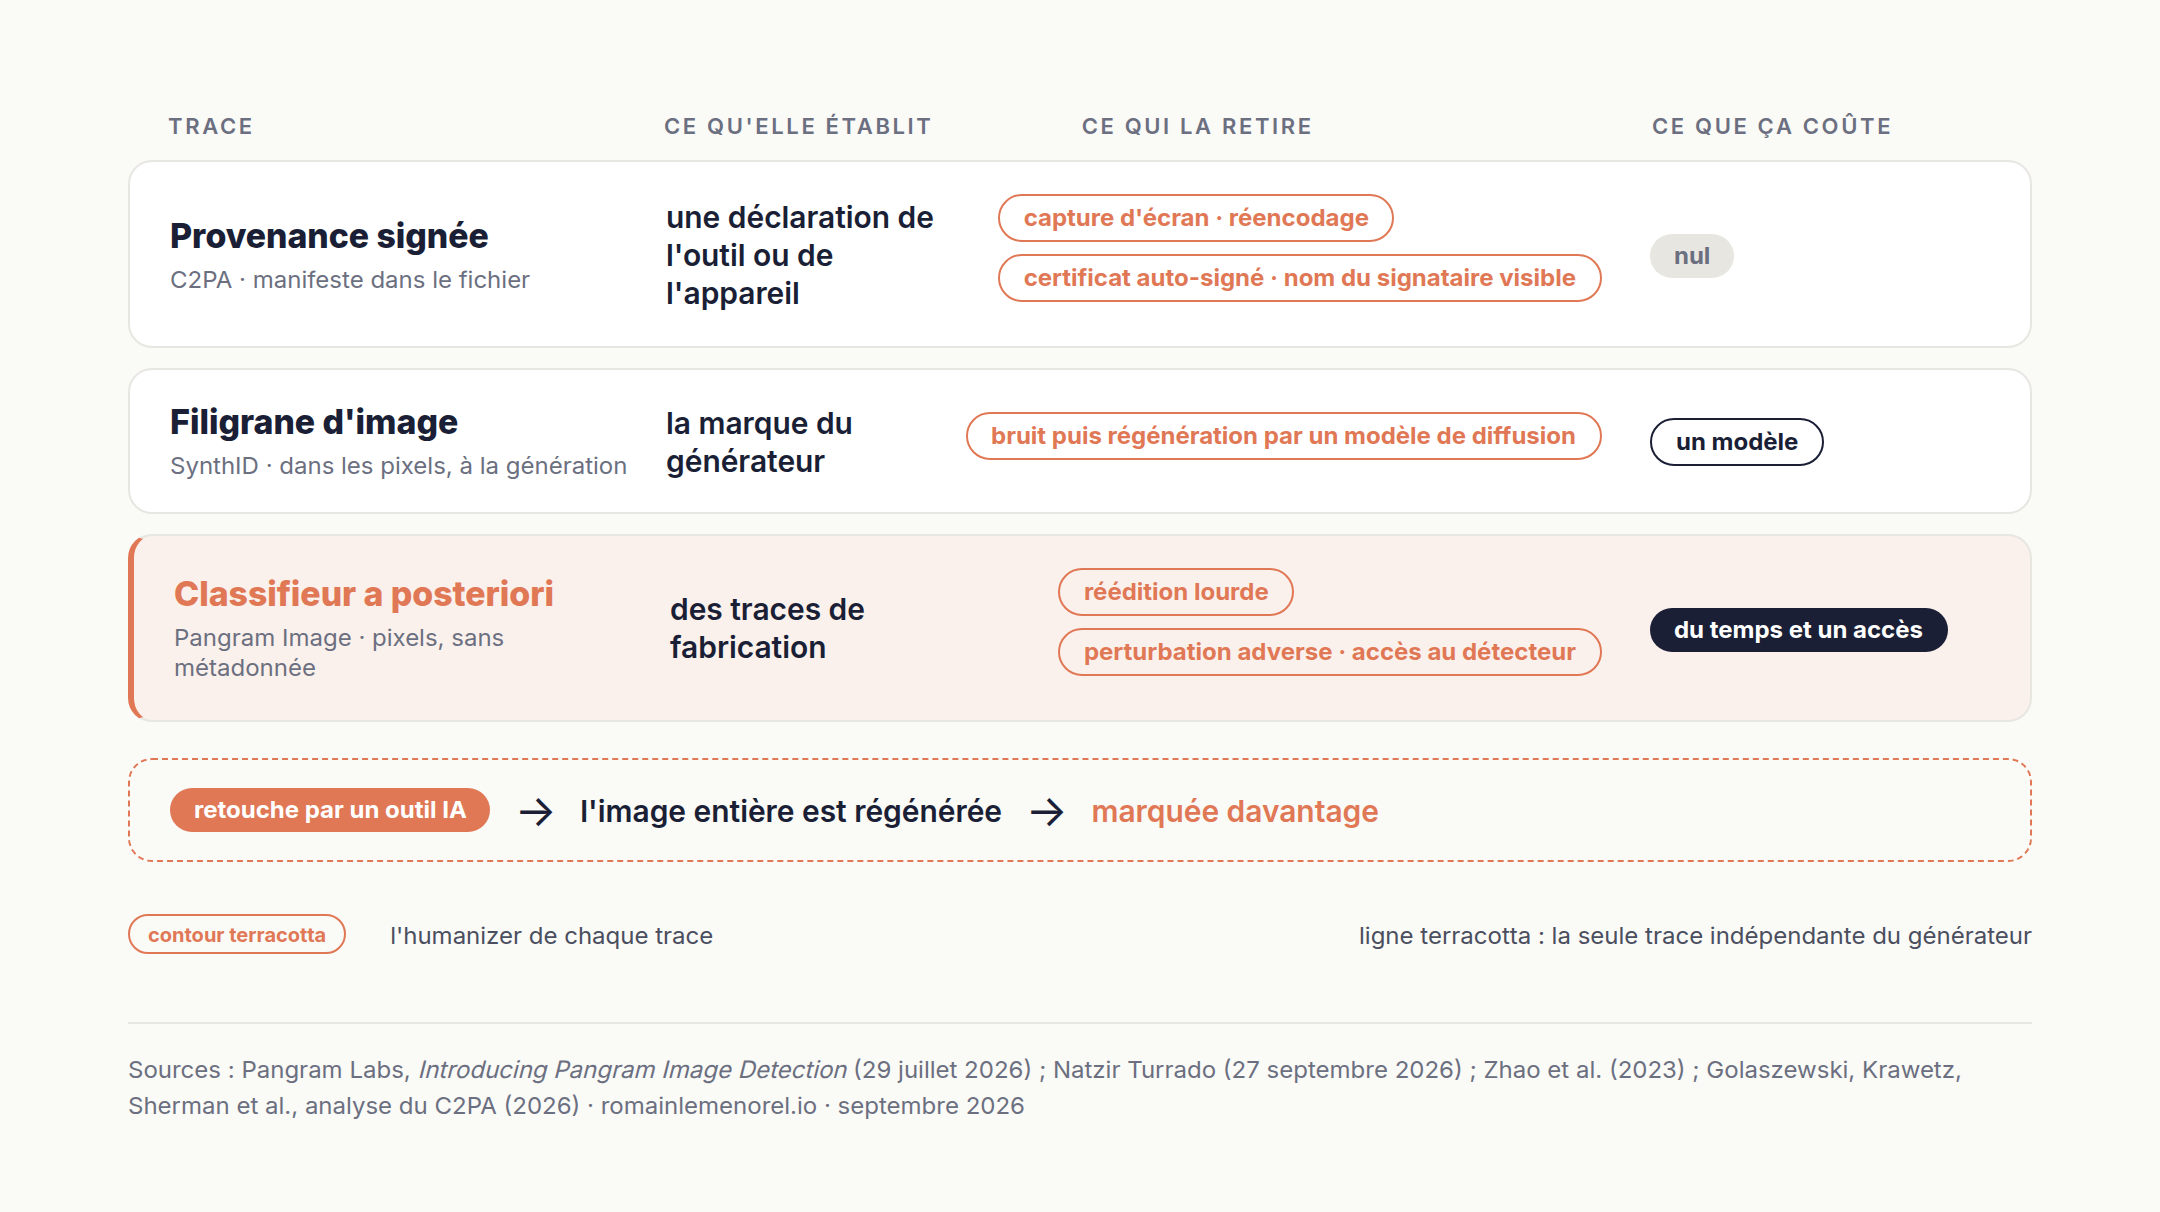
La détection passe ici par une provenance signée par le biais du standard C2PA qui intègre au fichier une manifeste cryptographique qui précise qui a produit le fichier et avec quel outil. C'est un peu comme une signature vivant dans les métadonnées pouvant disparaitre après un réencodage du fichier ou même une capture d'écran.
Google et OpenAI mettent en place leur propre marquage. Mais le plus récent est celui de Pangram qui a ouvert sa propre solution en aperçu de recherche depuis le 29 juillet et complète son offre initialement dédiée au contenu texte. Le résultat est probant, 0,16 % de faux positifs sur un corpus d'images antérieures à 2022.
Concernant Pangram, on peut se demander comment il fonctionne avec les images et la méthode est finalement assez proche de celle utilisée pour les textes. Il se base essentiellement sur la lecture des pixels qui représentent le style. Chaque élément identifiable et propre aux images générés par IA lui permet d'apprendre ces différents styles de production.
Pour la vidéo, la détection a posteriori n'existe pas encore, mais on peut imaginer qu'elle arrivera sachant que la vidéo est le format généré par IA qui pollue massivement des réseaux sociaux comme X ou YouTube avec souvent des contenus trompeurs.
Humaniser une image est possible, mais restera plus difficile face à un classifieur a posteriori tel que Pangram. Une réédition lourde sera requise sans l'usage d'une autre IA qui pourrait marquer davantage le fichier.
Ce qui permet de prouver qu'un contenu est fait par IA
Nous avons vu les différents outils et moyens pour détecter des contenus générés par IA. Que l'on parle du détecteur tel que Pangram, du filigrane comme celui de Claude ou encore de la signature C2PA, aucun de ces moyens ne dit qui a écrit le texte.
Nous allons voir comment ces différentes méthodes approchent la détection de l'IA.
La détection par le style rédactionnel
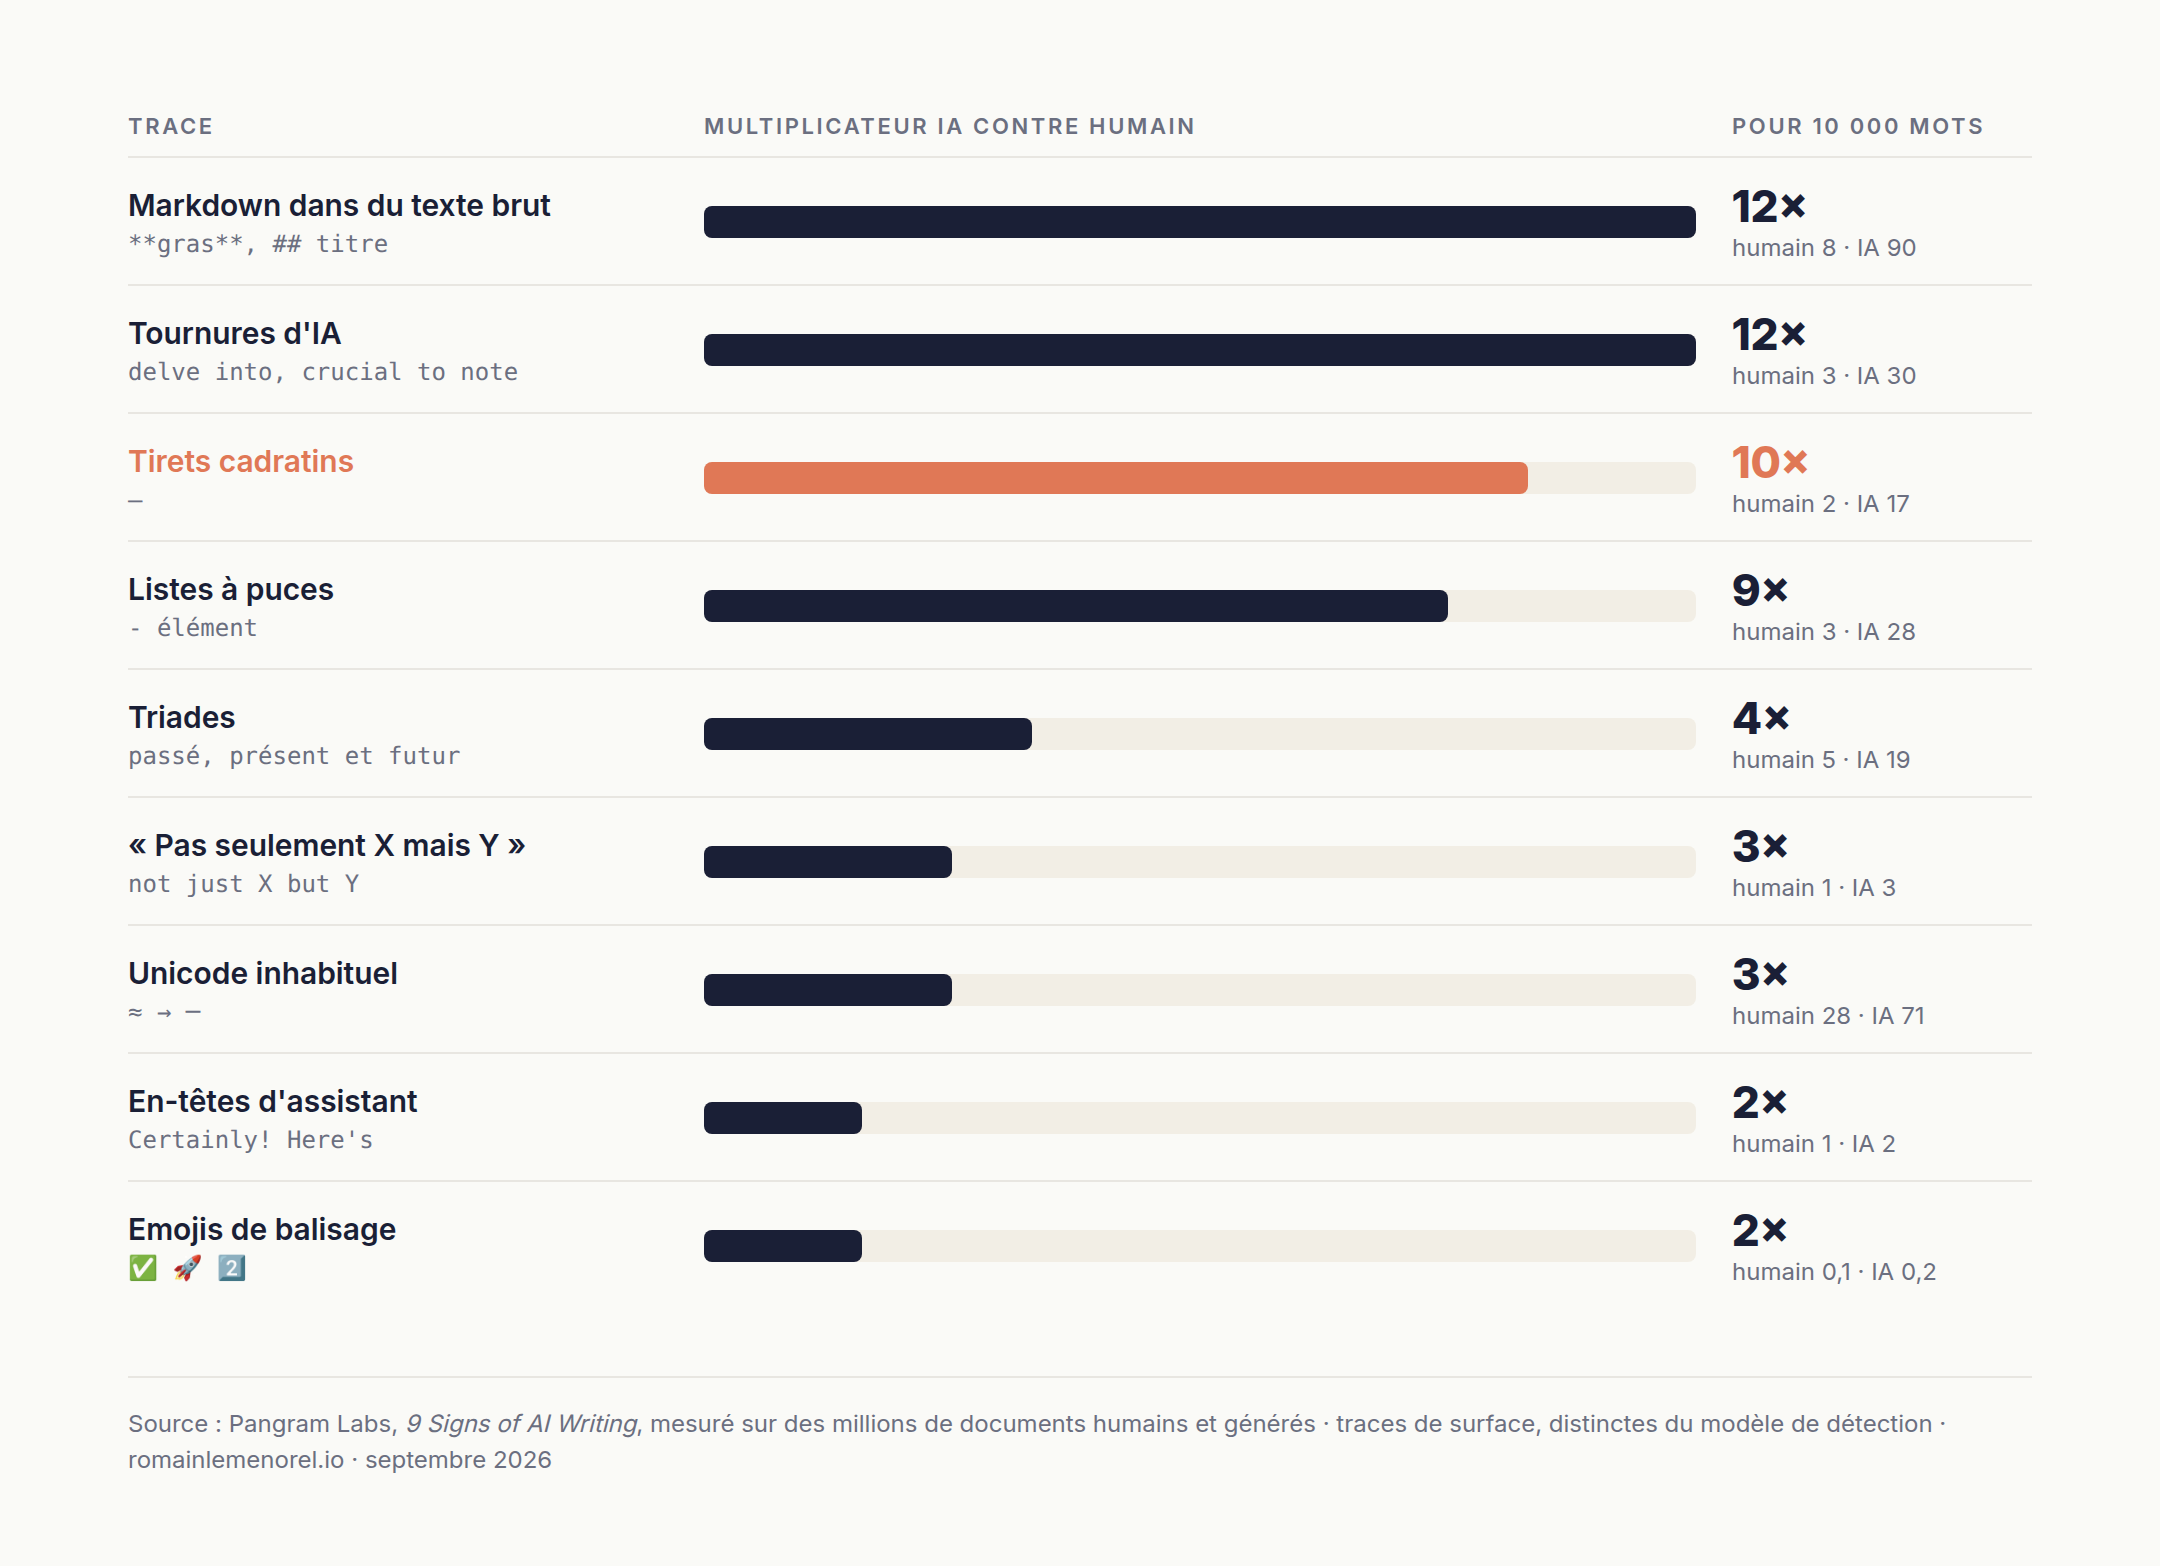
Le style rédactionnel est le biais par lequel Pangram détecte le contenu généré par IA. Il place le texte analysé sur sa carte et mesure son appartenance à un groupe d'auteurs qu'il connait. Ce rapprochement qu'il peut effectuer avec le style lui permet de faire cette détection, quelle que soit la présence d'un filigrane ou d'une signature.
C'est cette spécificité qui le rend particulièrement difficile à tromper et donc très fiable. Sa maitrise parfaite du style rédactionnel des IA qui est très spécifique lui assure ce taux de réussite dans la détection.
Ces critères de styles sont très nombreux et pratiquement impossibles à tromper. Je vous en propose quelques-uns que vous avez certainement déjà pu détecter à l'œil nu de manière évidente. Il faut savoir que forcer l'IA à interdire ces éléments stylistiques ne suffira pas à tromper la détection.
La détection par le filigrane
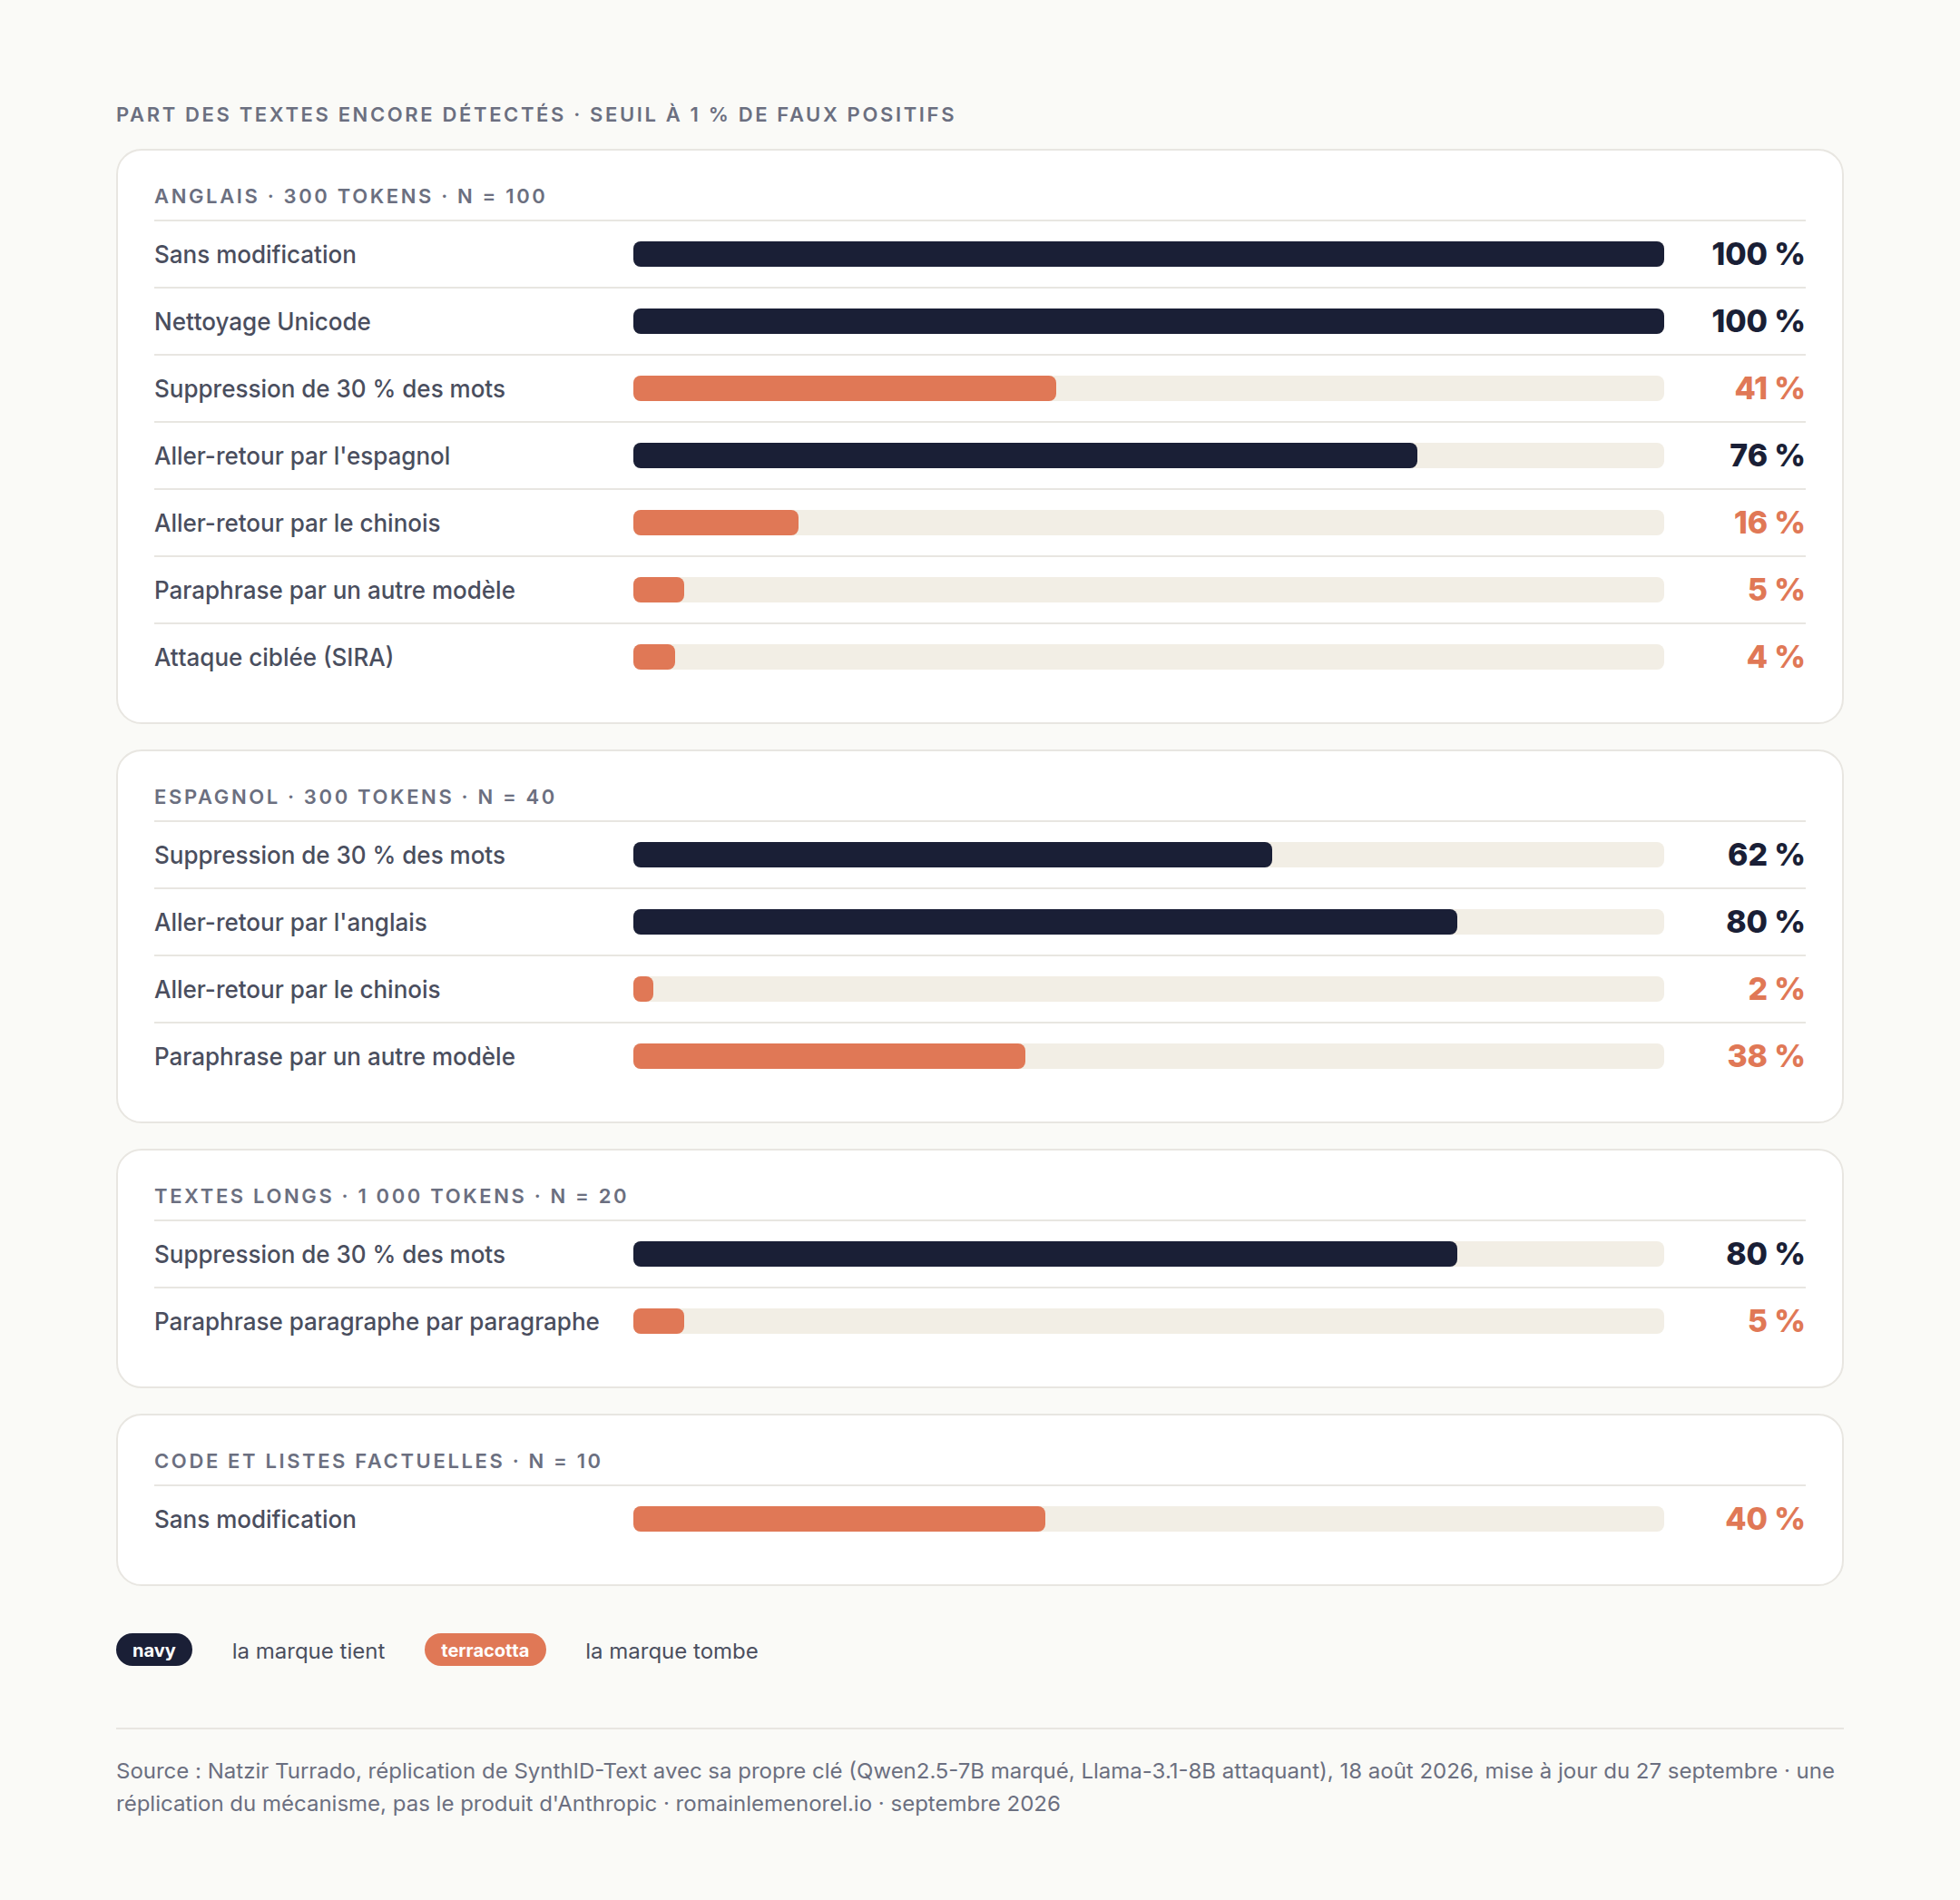
Le filigrane statistique n'est pas un élément ajouté au texte, il ajoute une condition au choix des mots qui détermine la présence de ce filigrane dans le texte.
Le filigrane retire le hasard du choix des mots par le biais d'une clé secrète qui détermine le choix des mots qui suivront les précédents. Ce filigrane est invisible pour une lecture humaine, mais les outils détenteurs de cette clé peuvent confirmer sa présence.
Cette méthode révèle donc une limite que la précédente n'avait pas. Si le choix des mots n'est pas déterminant (comme un code source de page ou un tableau), alors la production par IA n'est plus détectable. C'est la limite principale de cette méthode qui vaut pour les textes rédigés de plusieurs lignes.
Une autre limite est quand la production mêle l'écriture humaine à celle de l'IA dans le cas d'une repasse ou de correction. La présence du filigrane sera partielle, voire inexistante selon la façon dont l'IA a contribué à la rédaction.
La détection par le filigrane n'est pas ouverte au grand public, elle est réservée aux organisations que le règlement désigne. On ne parle donc pas d'une étiquette publique que portent les contenus. On sait par contre que cette détection reste réelle et incontestable pour tout auteur qui serait passé par une production par IA.
Une paraphrase bien faite d'un texte contenant un filigrane peut suffire à retirer ce dernier, il faut cependant que cette paraphrase vienne bien d'un auteur humain et non d'une autre IA.
La détection par la provenance et la signature
Une signature C2PA est la méthode la moins fiable pour prouver la provenance d'un contenu. Elle fonctionne par déclaration sur un fichier, quel que soit son type, qui reçoit une signature par certificat.
Aucune déclaration portée par cette signature ne peut être prouvée, car cette signature peut être détournée par un simple formatage ou réencodage.
Claude utilise cette signature pour tous les documents qu'il produit et le filigrane reste réservé au contenu texte.
Qu'est-ce qu'il advient des humanizers ?
Les humanizers désignent une technique consistant à contourner cette détection pour les algorithmes et l'œil humain qui sait reconnaitre un contenu IA.
Ils fonctionnent en réécrivant un texte initialement généré par IA pour le rendre humain.
Même si ces outils ont réussi à tromper de bons détecteurs d'IA, concernant Pangram, c'est une tout autre histoire et le tromper est très difficile. Il ne s'agit pas d'une option viable de secours et cette technique révèle aussi que l'utilisateur cherche à tromper le testeur ce qui constitue un signe de tromperie d'autant plus négatif.
Les humanizers peuvent fonctionner contre le filigrane si une paraphrase est réalisée avec un modèle qui n'en dépose pas.
Comment le contenu IA a-t-il pu se généraliser ?
Rédiger son contenu demande du temps et de l'effort et requiert un bon niveau de langage en public. L'IA s'est révélée être la solution à ce problème permettant un gain de temps considérable que l'on peut allouer à autre chose. C'est un gain de performance, même dans votre travail.
Écrire un contenu avec de l'IA ne coûte aujourd'hui presque plus rien et l'effort reste uniquement au niveau du cadrage et de la vérification. La production de contenu par IA fait un clin d'œil à l'époque du bourrage de mots clés et des fermes de liens. La différence ici réside dans les délais de production qui peuvent être extrêmement courts.
L'outil de production est également responsable de cette tendance, car le système de délégation devient rapidement un réflexe d'usage. Sauf que les productions génériques sortent des contenus qui se ressemblent et apportent peu de sens à chaque mot avec des traces que les nouveaux détecteurs peuvent désormais mesurer.
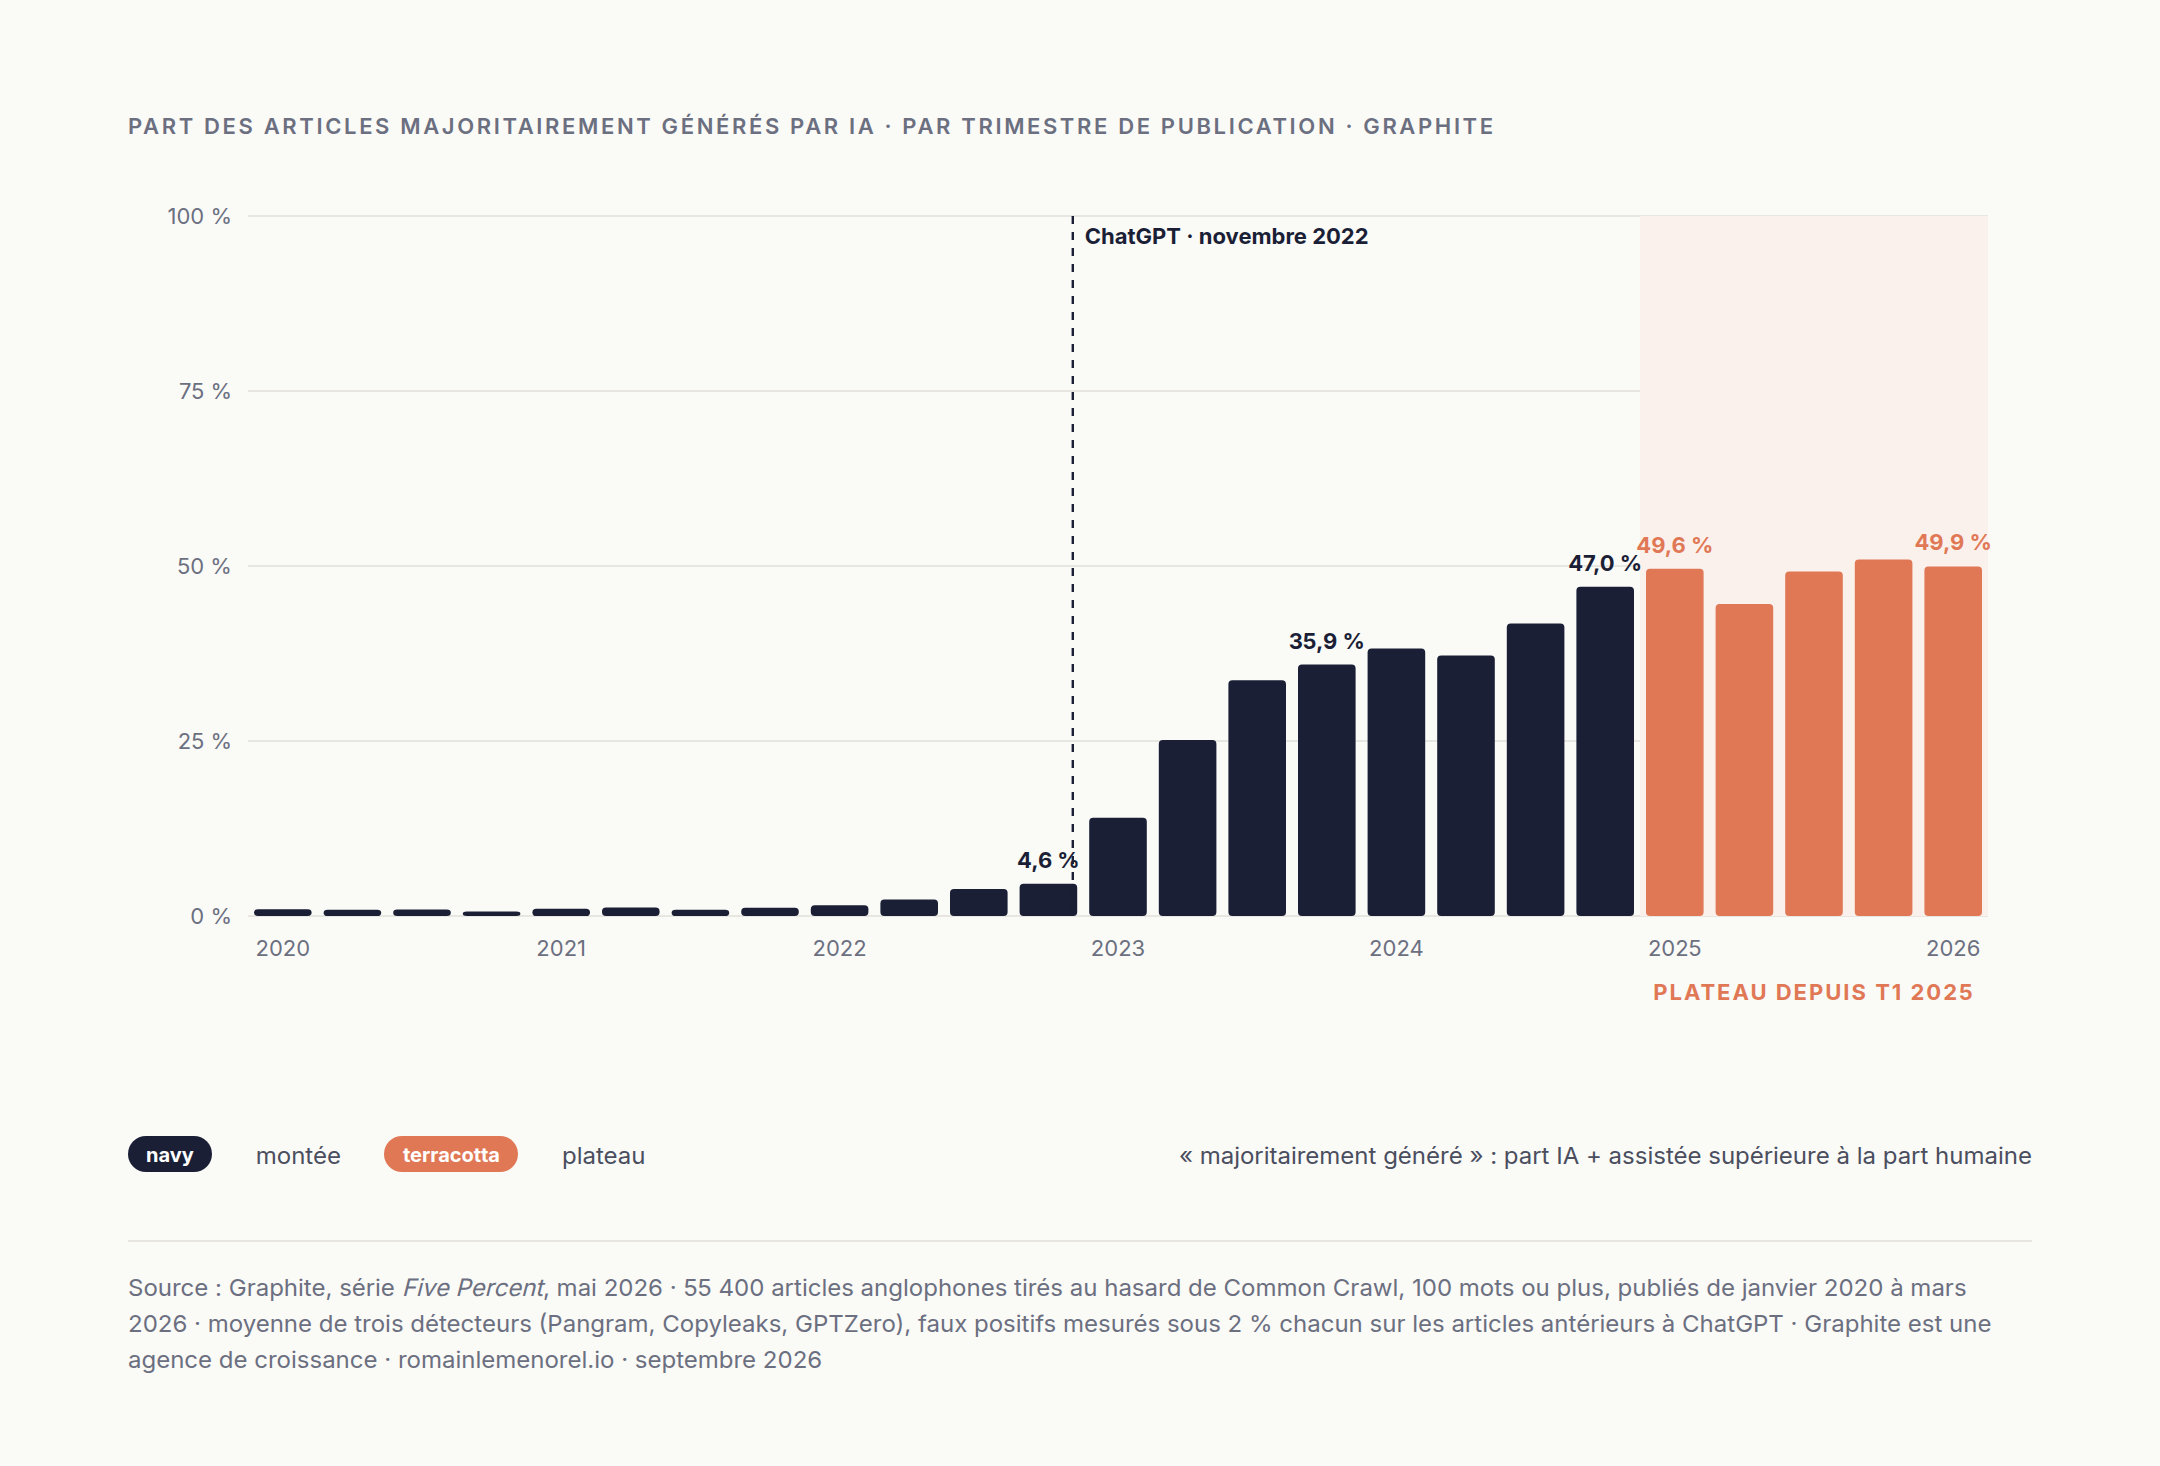
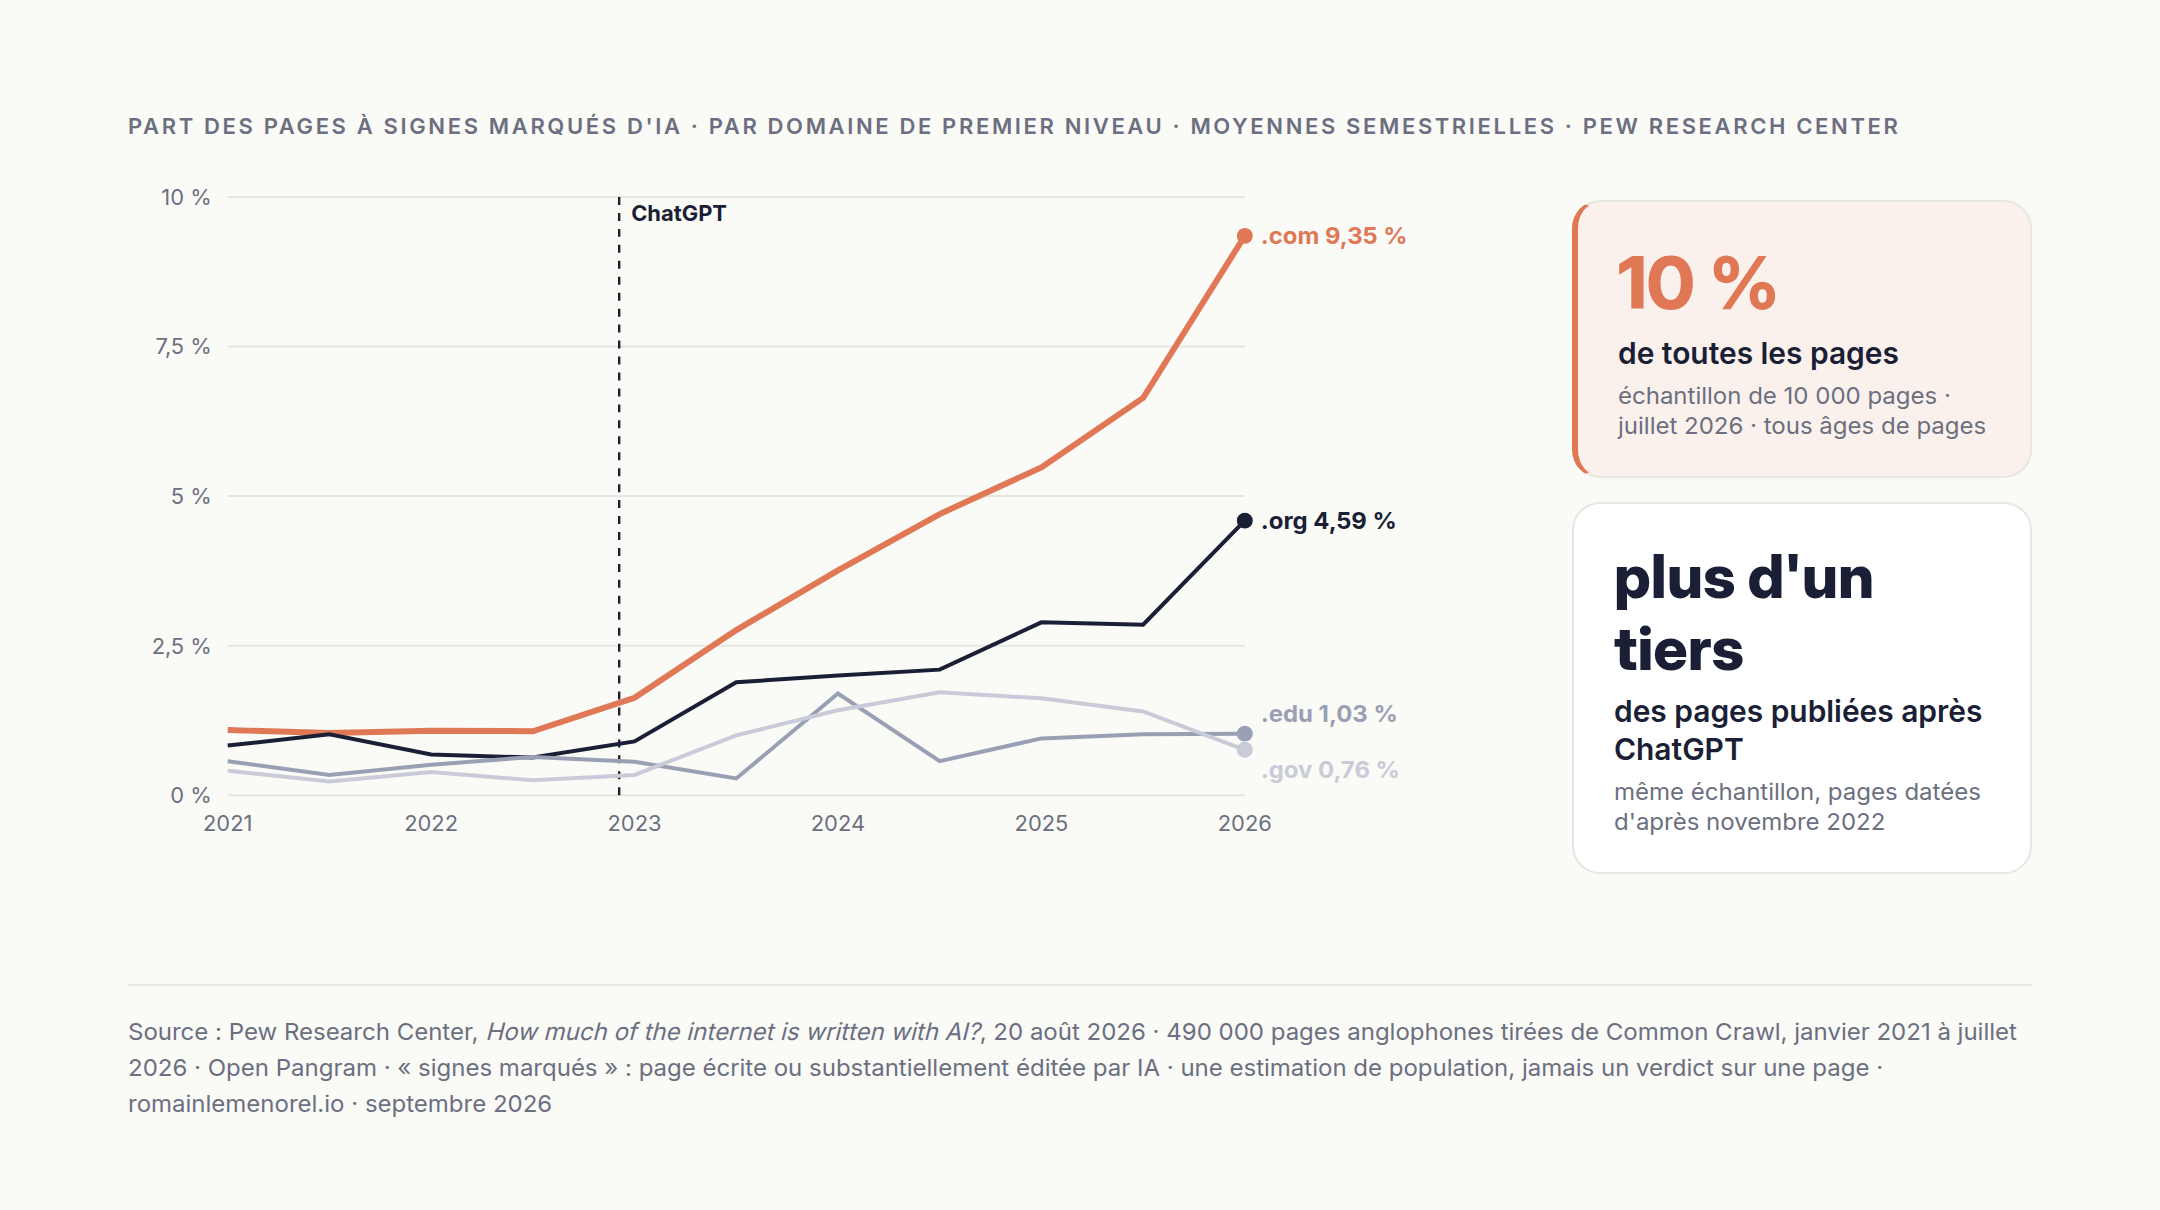
Plusieurs études ont été menées pour évaluer l'évolution des contenus IA par Graphite et Pew Research. Une étude française plus récente a aussi sorti quelques chiffres estimatifs. La part monte et varie selon le secteur et montre que cet usage est considérable à l'échelle du web.
Quand la production de contenu IA voit ses limites
La part de l'IA sur le web est considérable, on ne va pas revenir sur ce constat, il est indéniable.
Cette part croissante des contenus IA ne signifie pas pour autant que ces contenus sont les plus visibles et donc les plus lus sur le web. Graphite effectue cette mesure et montre que les citations de ChatGPT et Perplexity sont majoritairement des contenus rédigés par des humains.
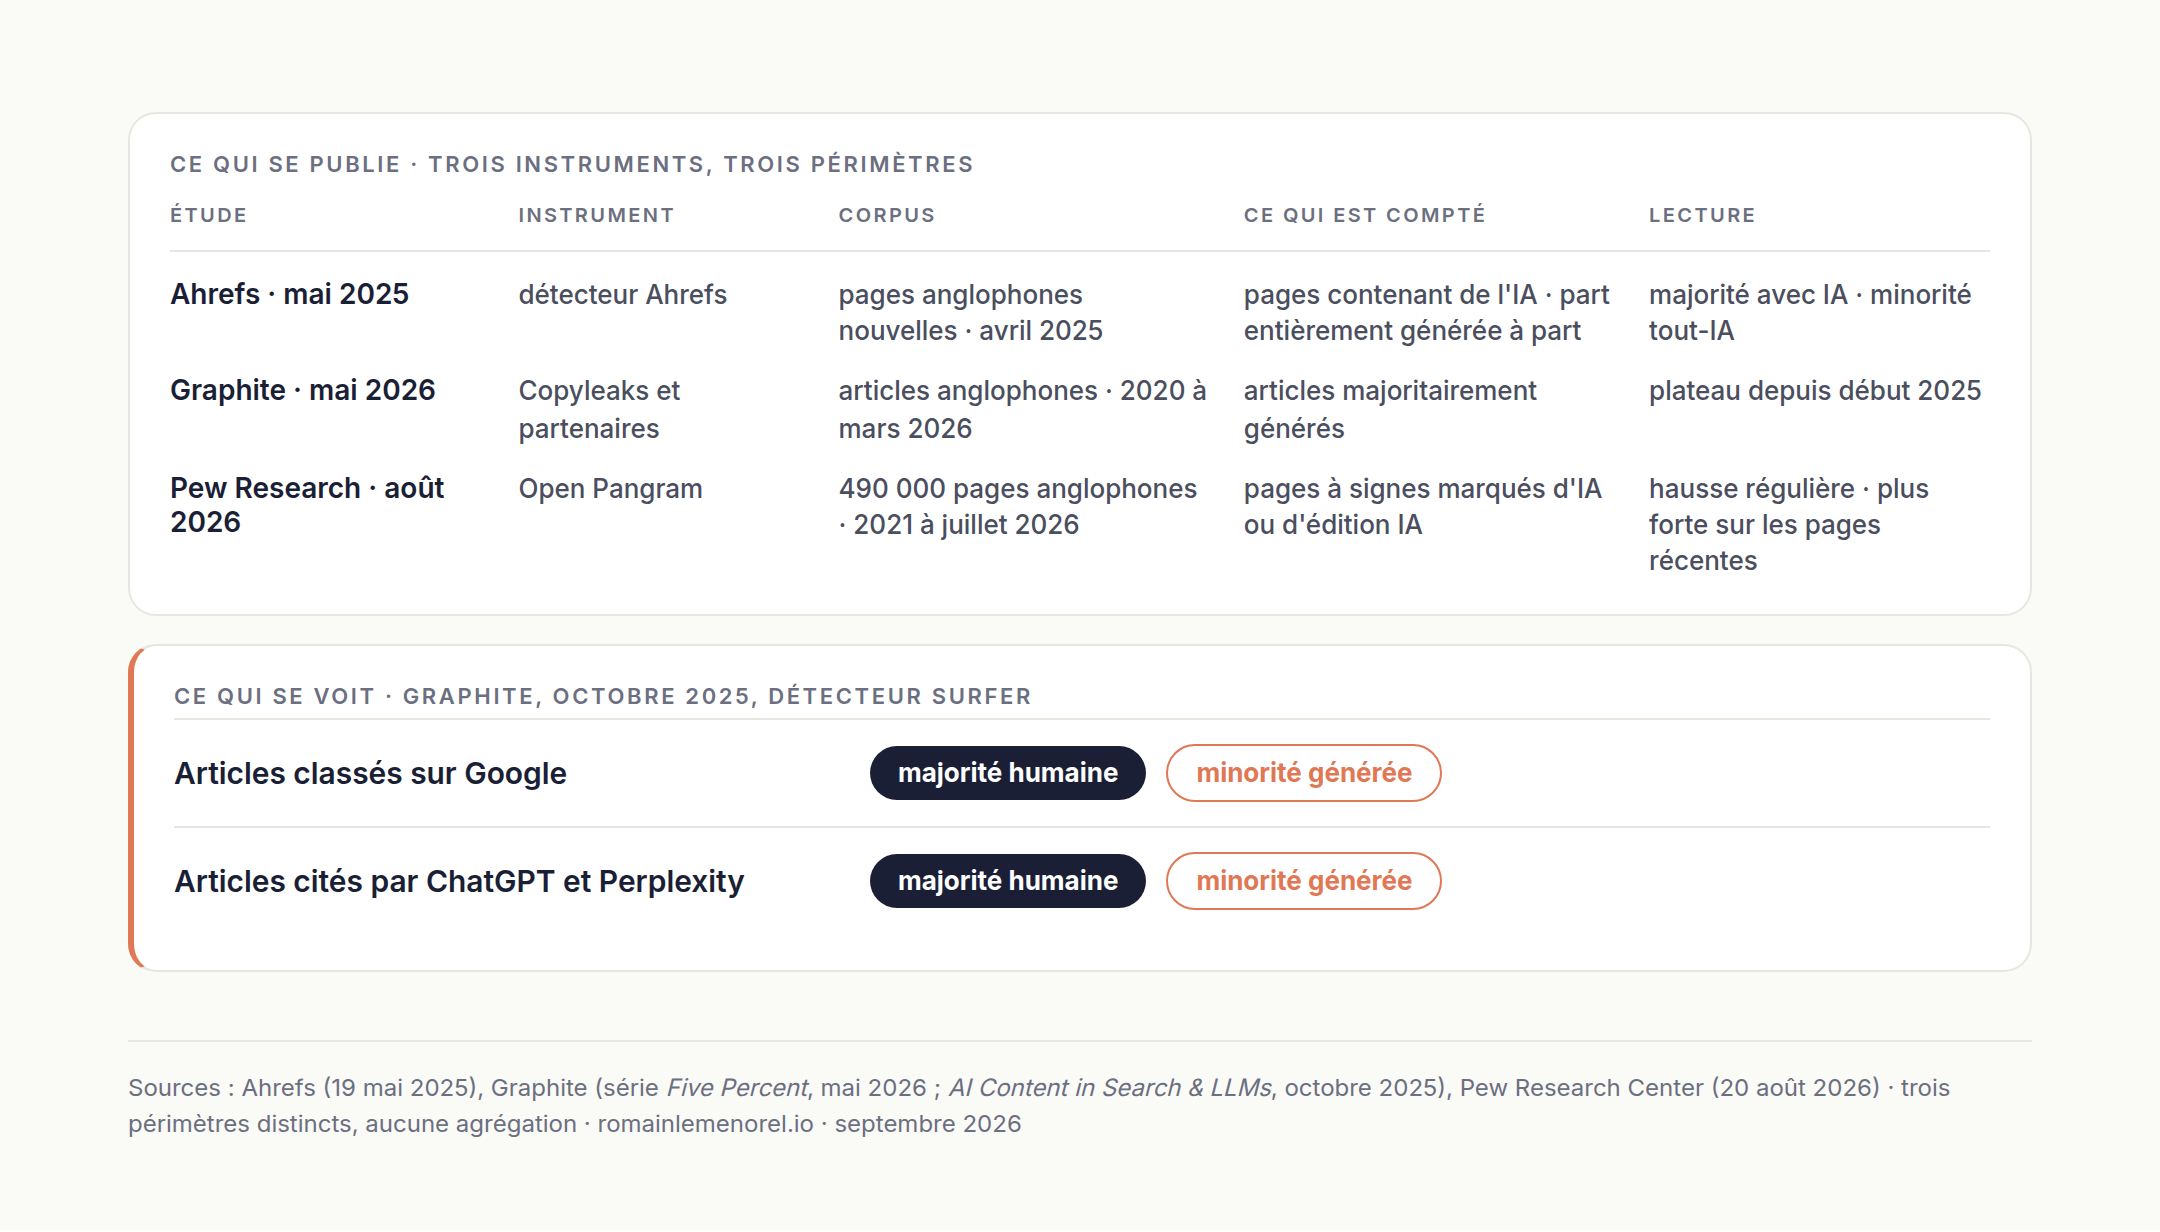
Deux notions importantes qui semblent se rejoindre doivent être distinguées. D'un côté, la détectabilité des contenus qui dit comment un texte a été produit et de l'autre la qualité du contenu qui dit ce qu'il apporte à l'utilisateur comme valeur ajoutée.
Google juge lui l'effort et l'originalité d'un contenu et non le mode de création de ce dernier. Un bon contenu IA peut donc valoir plus qu'un mauvais contenu humain.
Le problème est que beaucoup de stratégies de production à grande échelle ne parviennent plus à assurer des standards de qualité et l'absence de relecture représente un risque majeur.
Soyons clairs, le contenu produit par IA dans une stratégie d'acquisition business impose aujourd'hui une remise en question.
Le contenu par IA est-il factuellement déprécié par les moteurs ?
Aucune étude à ce jour ne démontre que le contenu généré par IA est pénalisé et Google maintient que ce qui compte est la qualité et non le mode de production.
Si on dresse une frise chronologique des guidelines côté Google sur la qualité du contenu, on retient très nettement cette notion de qualité et d'effort sur lesquels repose le classement des sites. Ce constat n'est pas nouveau et a été renforcé chaque année.
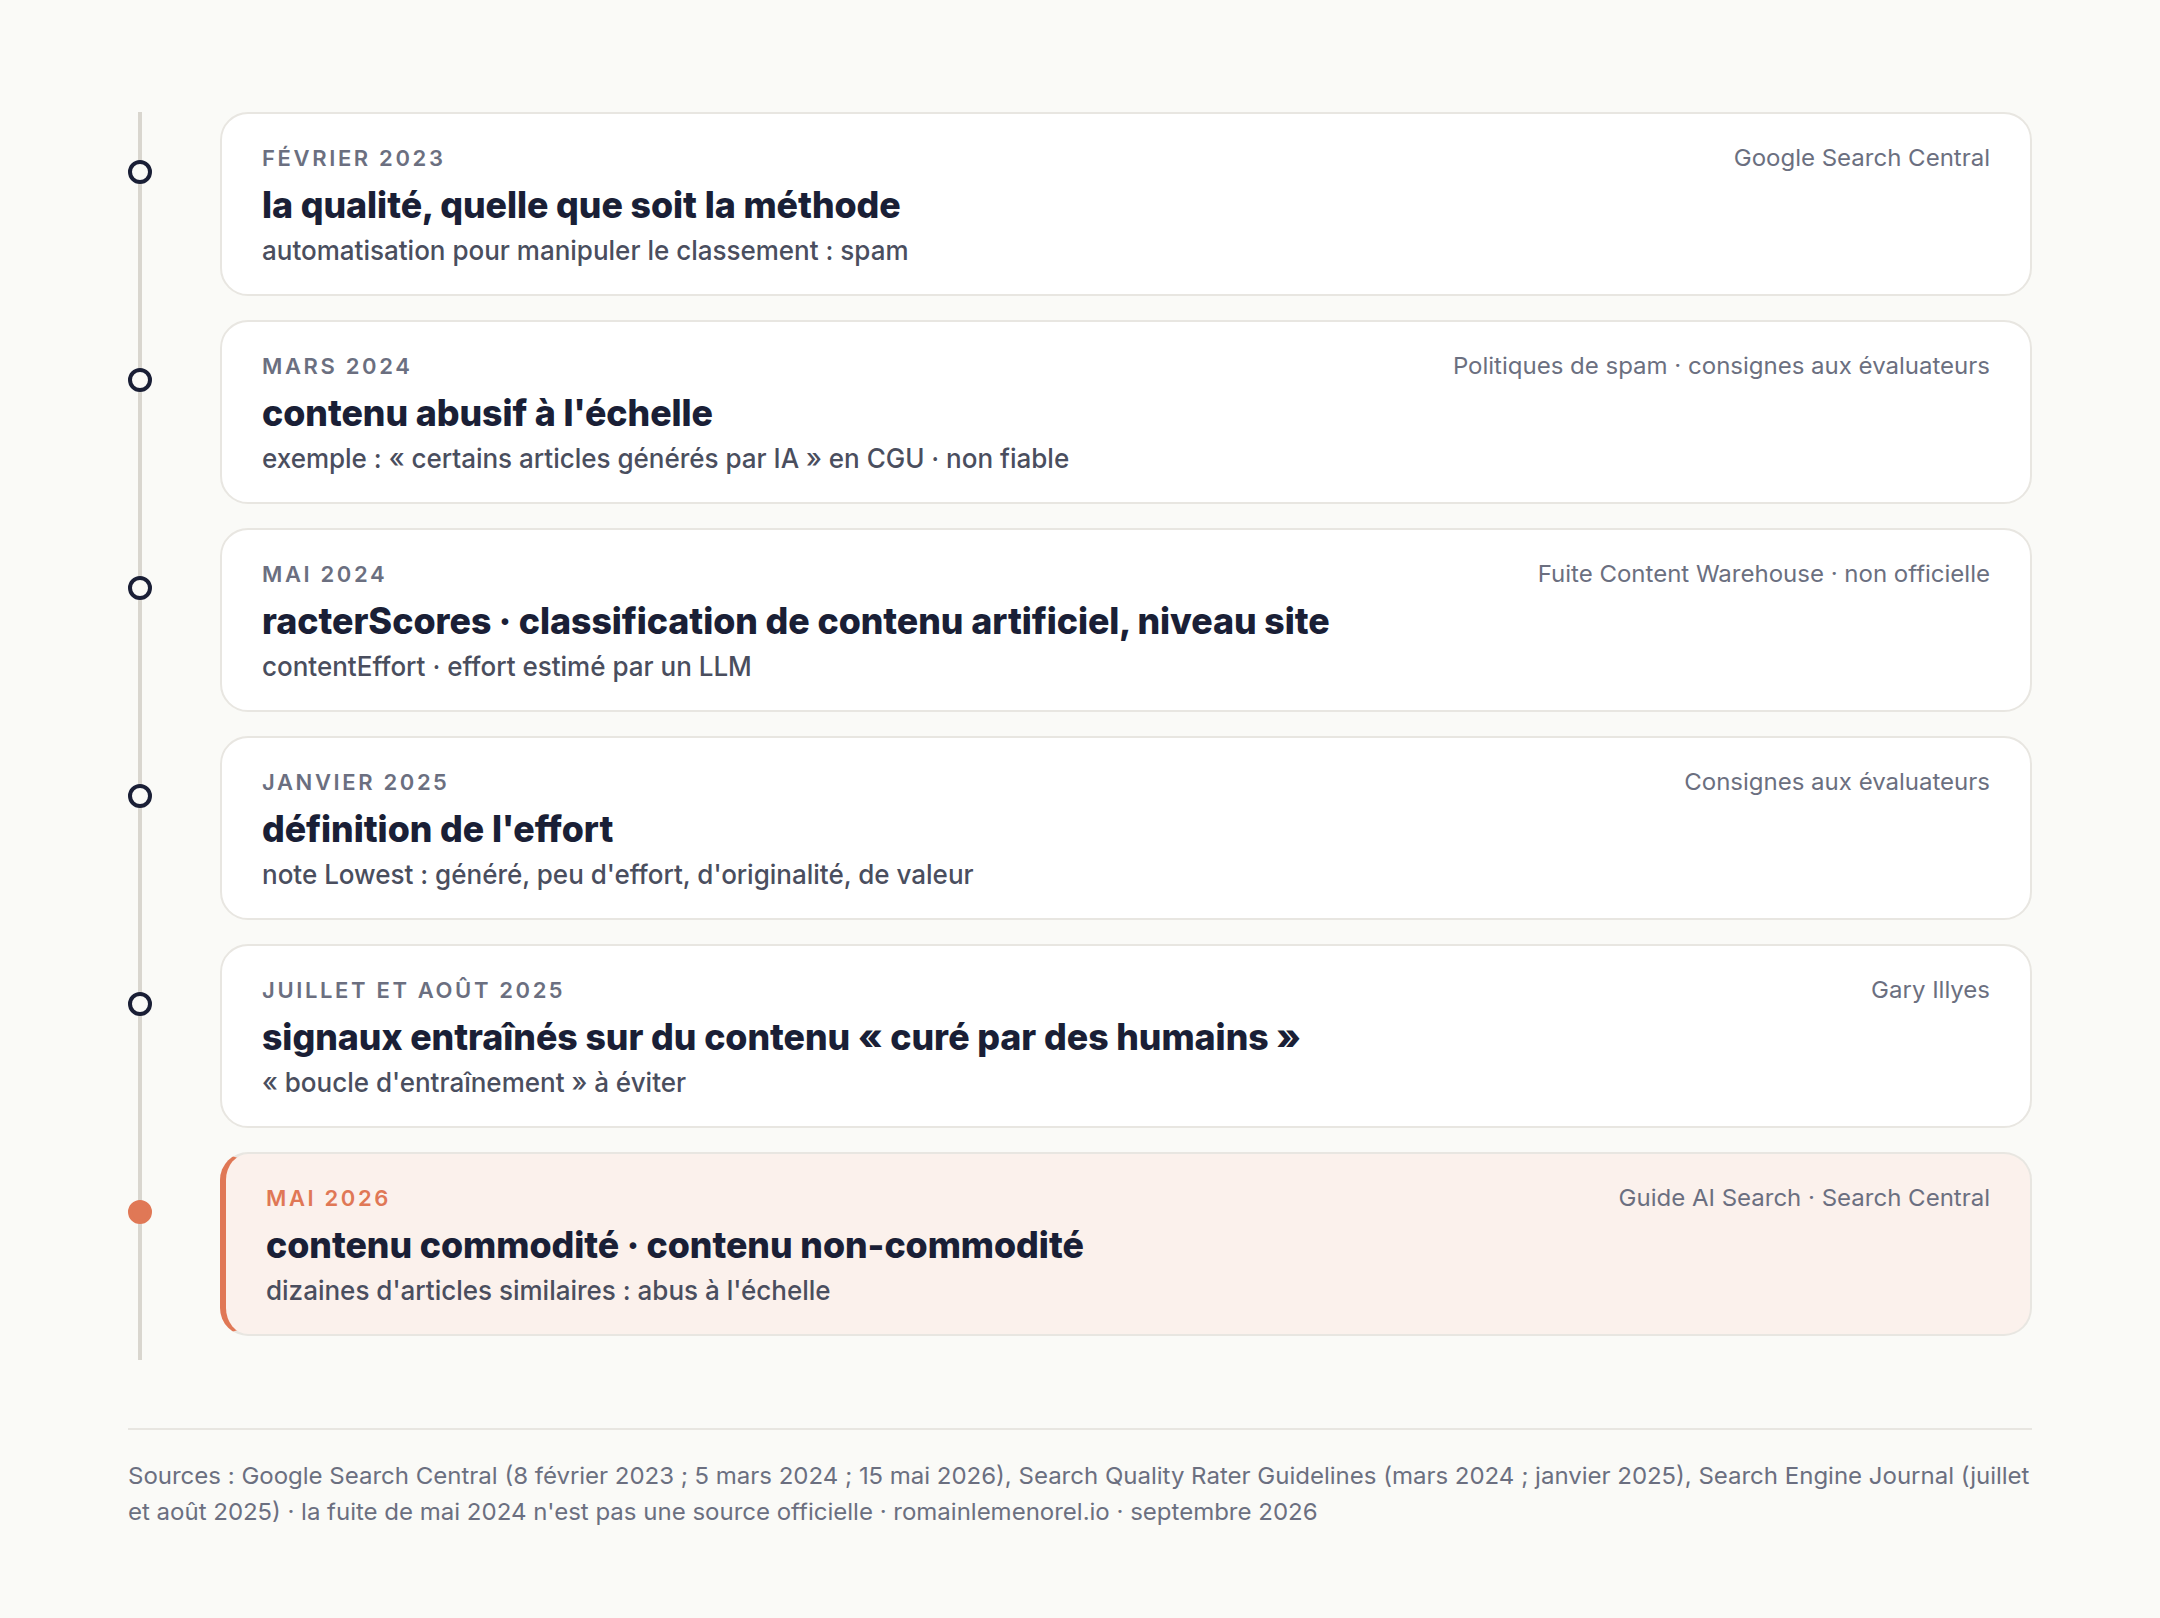
Un contenu IA n'est donc pas déprécié directement, mais les risques qu'ils ne répondent pas aux exigences de qualité sont plus grands en raison d'un mode de production qui de base nécessite moins d'effort. Une réduction de l'effort qui s'en ressent dans la qualité finale.
Les détecteurs d'IA ne représentent pas une menace directe sur le ranking, car ils ne déterminent pas la qualité du contenu produit. Ils ajoutent simplement une couche de transparence qui expose davantage le mode de production.
Si une stratégie de contenu perd son efficacité, la remise en question vient en premier lieu de la qualité des contenus et non du mode de production.
La boucle de l'AI slop
L'AI slop désigne les contenus de basse qualité, produits en masse sans aucune valeur ajoutée pour l'utilisateur final. La notion de boucle entre en jeu dès que ces contenus parviennent à gagner en visibilité sur les moteurs et générer des clics. Ils sont ainsi repris par les moteurs comme source de référence et alimentent les réponses de ces derniers.
La boucle suit cinq étapes :
- Publication
- Indexation et classement
- Citation dans une réponse
- Source pour l'entrainement du modèle
- Nouvelle génération
À chaque tour de la boucle, la pertinence de l'information se dégrade alimentée par des faits potentiellement erronés.
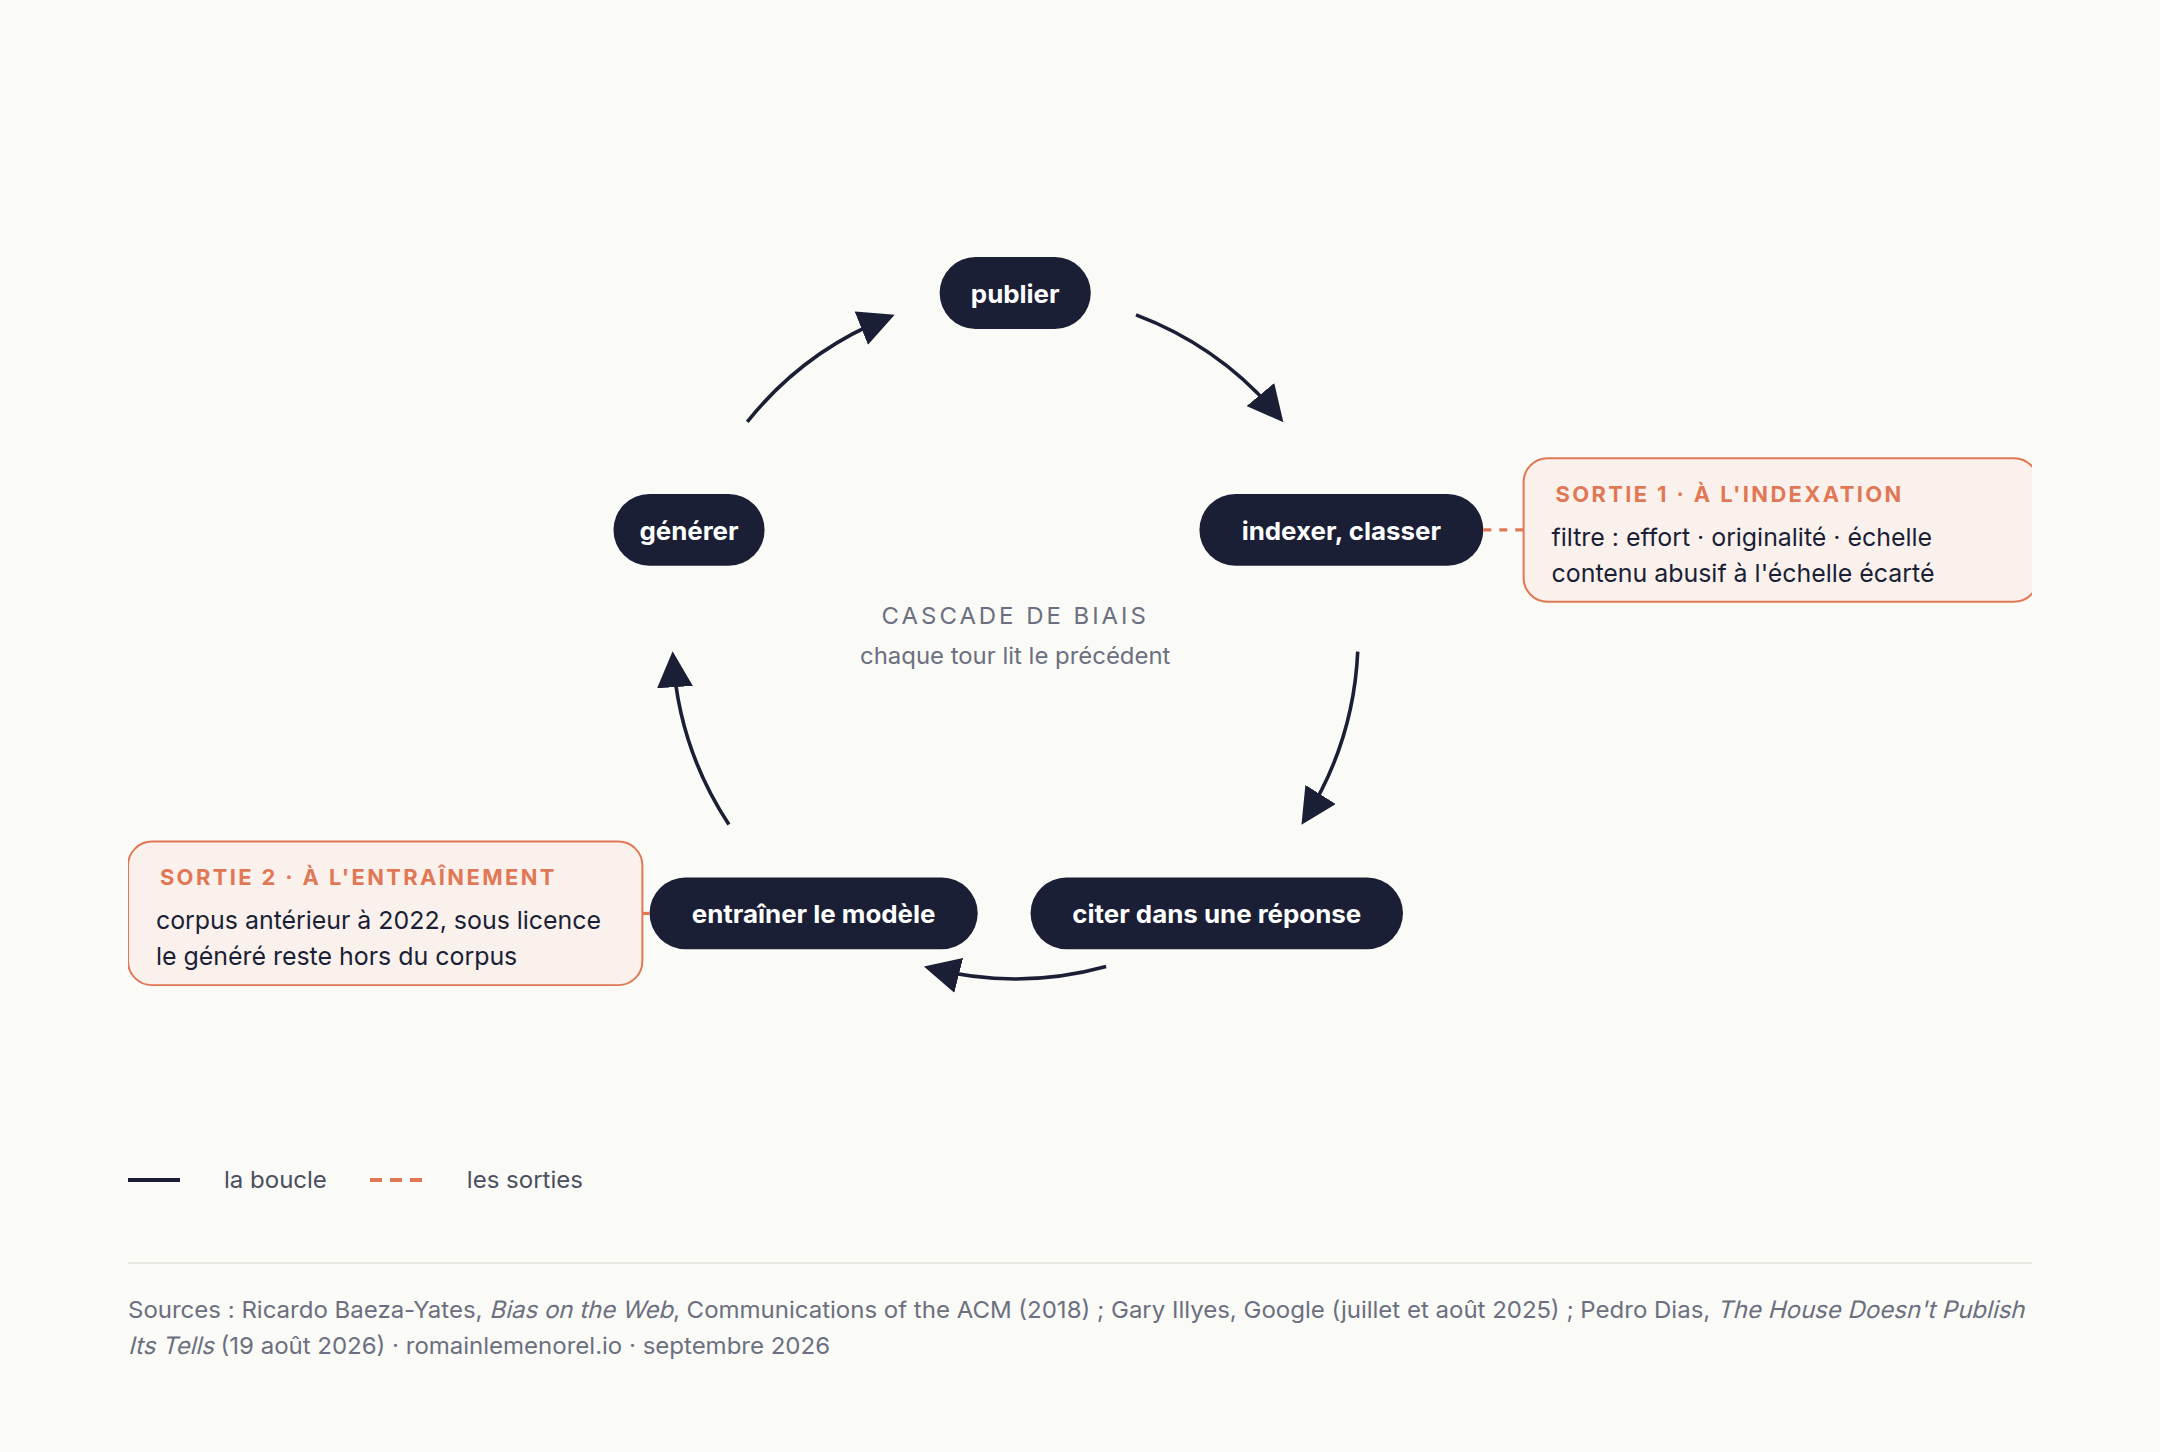
Google apprend déjà à orienter l'entrainement de ses modèles sur du contenu fiable produit par des humains. La capacité des modèles à éviter ce scénario dépend donc de leur capacité à distinguer le contenu humain du contenu IA.
Ce mécanisme se désigne aujourd'hui par ce qu'on appelle la désinformation, à savoir un contenu inventé qui prend source d'une réponse générée et qui par répétition finit par faire consensus et alimenter l'entrainement des modèles. Lily Ray a déjà décrit ce mécanisme et le nomme l'AI Slop Loop.
La conséquence pour la marque et l'EEAT
La visibilité n'est pas le seul coût de ce choix, deux autres entrent en considération.
La confiance de l'utilisateur et des moteurs
Un contenu généré par IA, qu'il soit bon ou mauvais n'est pas un bon signal. Il révèle, comme je le disais en début d'article, une absence de vécu, d'expertise métier ou encore d'un auteur bien identifié et reconnu. On parle ici de tout ce qui donne une identité ou une singularité à une entité représentée dans la page.
Une étude menée par Fractl auprès de consommateurs américains, réalisée deux années consécutives, montre une défiance qui monte face à l'usage de l'IA.
Une marque confiant une majorité de son activité marketing à de l'IA voit la confiance de ses utilisateurs diminuer en un an seulement.
Cette tendance parait logique, car l'image d'une marque est portée par son discours et son expertise. Une IA qui prend ce rôle sur une page d'un site dépersonnalise l'identité de marque.
La dissimulation du contenu produit un effet encore plus négatif
Un sujet de news en novembre 2023 avait fait polémique autour de la marque Sports Illustrated qui publiait sous des noms d'auteurs inexistants.
La pratique qui consiste à dissimuler un contenu constitue une forme de tromperie qui peut fortement dégrader l'image de marque. C'est un pari très risqué et quasiment perdu d'avance maintenant que les détecteurs se révèlent très fiables.
Le contenu devra impérativement être assumé pour ceux qui l'utilisent encore.
Le 2 août 2026 : les obligations de transparence de l'article 50 de l'AI Act
Le règlement européen concernant l'IA cible le contenu généré et l'article 50 pose désormais deux obligations ainsi qu'une exemption pour l'ensemble des éditeurs et cela change beaucoup de choses.
L'ensemble des fournisseurs ont du 2 août au 2 décembre pour intégrer un filigrane permettant la reconnaissance du modèle sur l'ensemble des sorties. La seule exemption à cela est si le texte est révisé par un humain et que le texte publié reste sous la responsabilité de cette personne.
On parle ici, bien entendu, des sujets d'intérêt public, ce qui ne concerne pas l'intégralité des contenus publiés du web.
Même si ce nouveau règlement reste encore limité à une partie des contenus, la logique imposée montre ce sur quoi l'autorité d'un site repose. Chaque page d'un site reposant sur une source vérifiée et reconnue gagne en pertinence. Les pages entièrement générées par IA sans validation humaine ne répondent plus à ces critères.
On ne remplace pas du contenu IA par du contenu humain sans perte
Reste un dernier argument et il n'est pas anecdotique. Une stratégie basée sur du contenu IA alimentée à grande échelle se fait à coût marginal. Si cette stratégie devait être remise en question par un éditeur ou une marque, alors le coût du remplacement des contenus par un écrit humain serait considérable.
Ce n'est pas un remplacement qui se fait en un clic et le coût d'équivalence d'un contenu humain est nettement supérieur si celui-ci doit respecter des consignes de taille ou d'optimisation.
Le coût de cette migration, qu'il soit en temps ou en prix du nombre de mots, est considérable. La mesure d'un projet comme celui-ci doit se faire rapidement et ne doit pas attendre une situation qui imposera un changement soudain.
Quelle approche choisir en 2026 ?
Si l'on rattache cette réflexion à l'audit stratégique et à mon framework présenté dans mon article dédié. Les piliers concernés sont le contenu et l'EEAT.
Le contenu produit par un humain, s'il est de qualité, peut répondre à certains critères auxquels un contenu généré ne pourra jamais répondre. Ces éléments entrent dans la grille lorsque la thématique ou le secteur analysé l'exige.
On parle ici du vécu, des expériences propres, de prises de décisions, d'exemples, d'une opinion propre. Tous ces éléments ne peuvent pas venir directement d'une IA et ils créent une réelle différence entre un contenu humain et un contenu IA.
Si vos contenus portent un message fort et propre à la marque, une IA ne pourra le faire à votre place. Un contenu généré ne parviendrait pas à jouer ce rôle et ferait peser un risque sur l'image de marque.
On peut donc partir sur trois critères :
- La commodité : votre contenu en comparaison directe avec les contenus les mieux positionnés sur le sujet
- L'effort alloué à la production du contenu
- Le mode de production et la déclaration faite sur la page (auteur, signature, date)
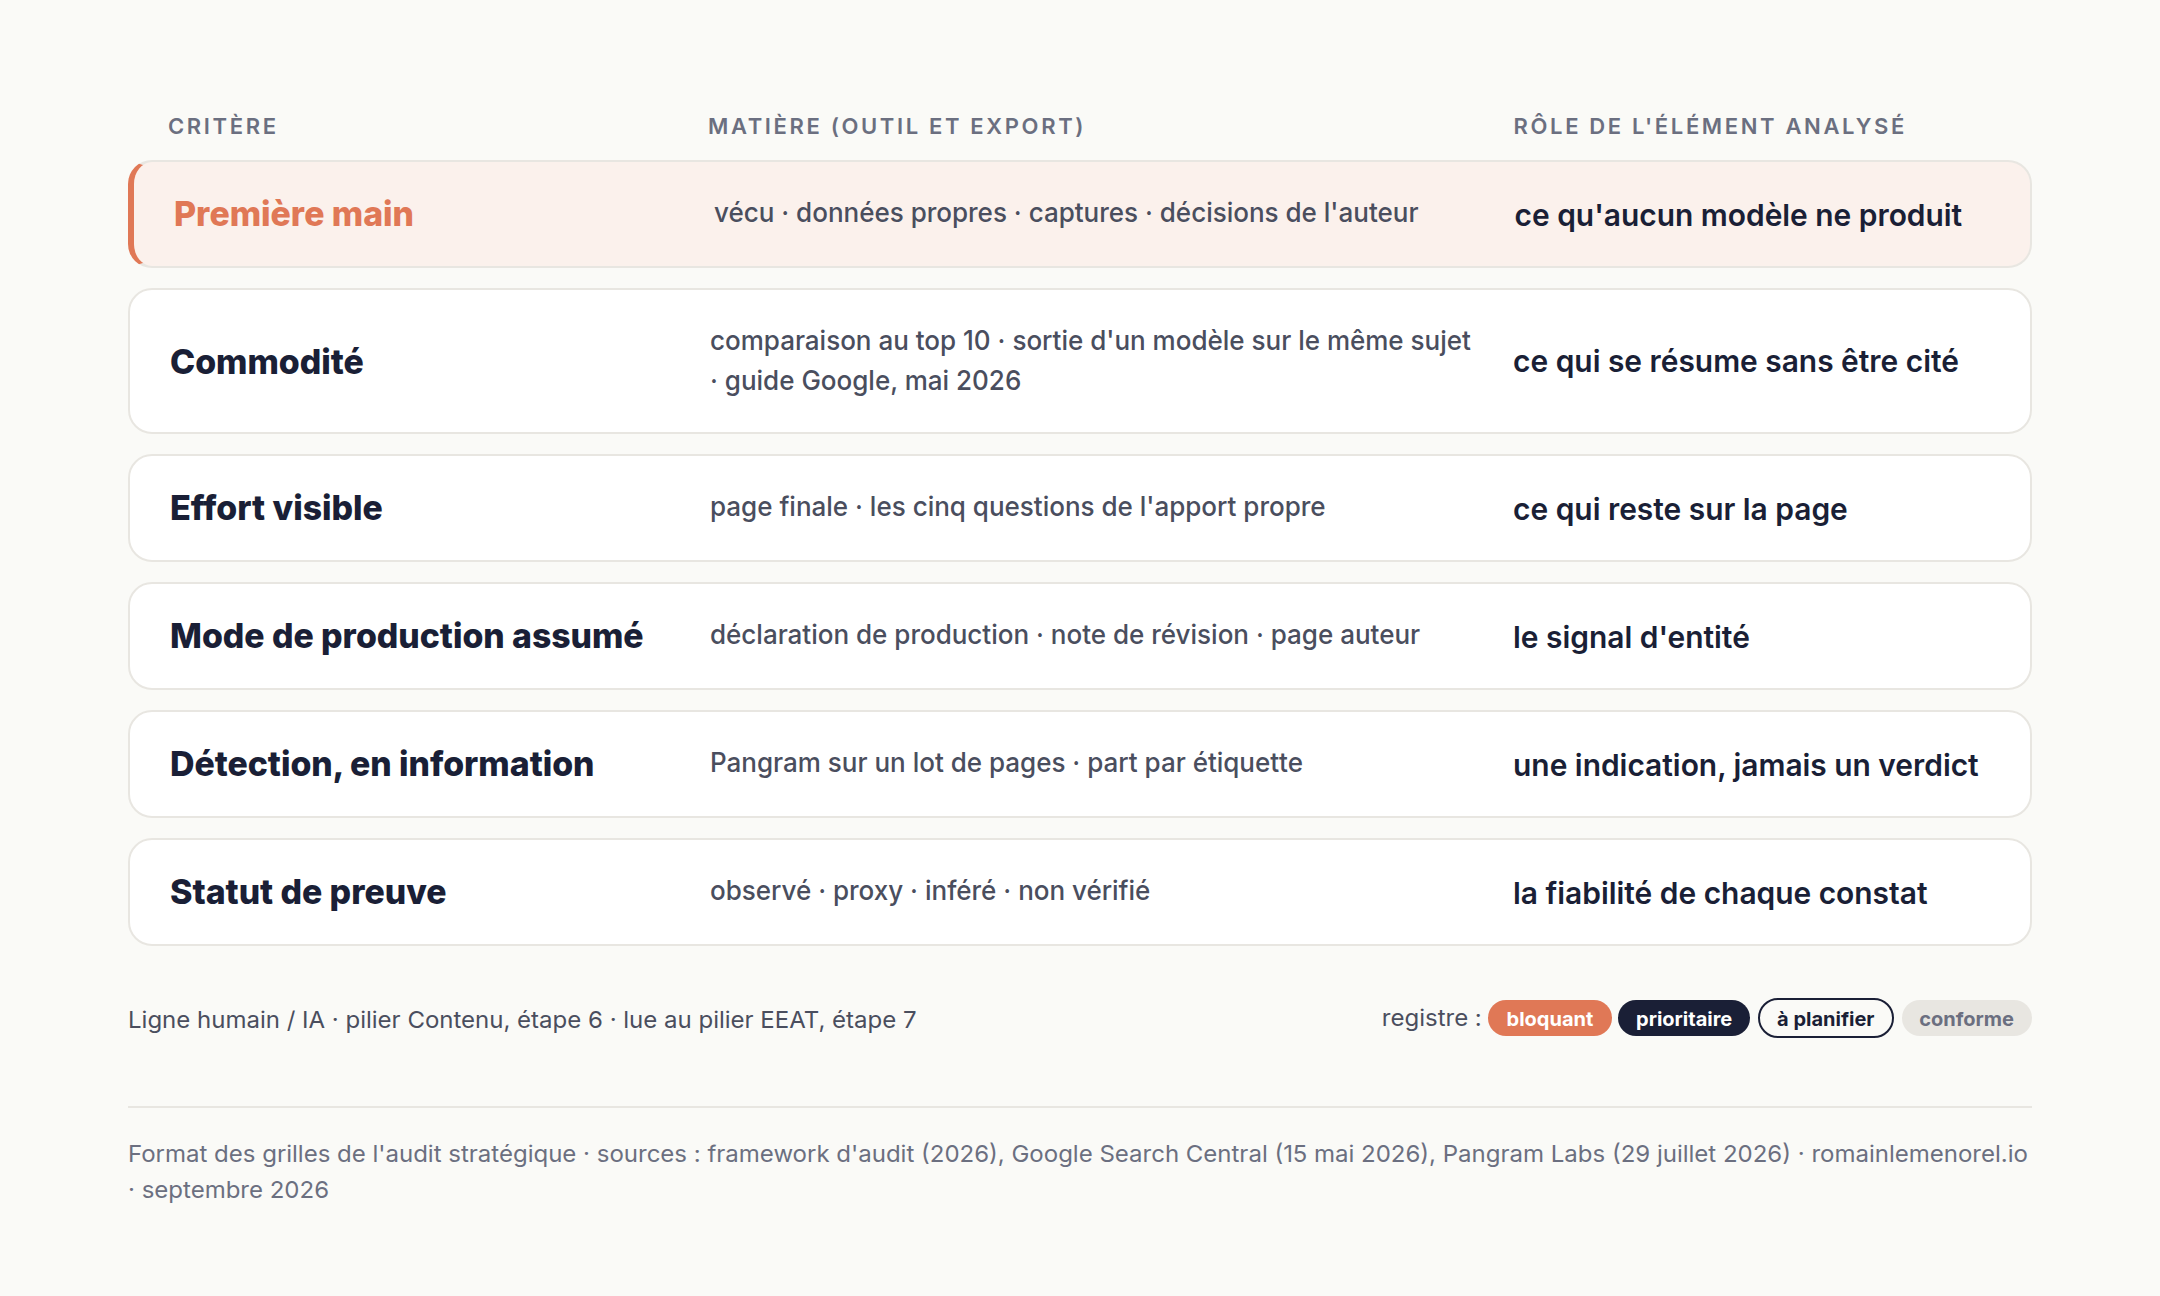
Cette approche répond aux exigences de l'EEAT
La transparence sur le mode de production, que cherchent des plateformes de contenus comme Substack, rejoint ce que l'on pratique dans le pilier EEAT.
Chaque contenu produit, au-delà de sa qualité intrinsèque, doit faire la preuve de sa conformité, de sa pertinence et de ses sources.
La grille de l'audit EEAT que nous avons présentée dans mon article dédié entre en compte dans cette réflexion et détermine si l'usage de l'IA comme mode de production est possible.
Un protocole de rédaction à calibrer en amont
Quand les conditions sont bien définies pour votre marque et votre site, le protocole de production peut être décidé.
Si la production par IA est proscrite, son usage doit se limiter à la recherche documentaire, à la veille ou encore à la relecture. La production du contenu doit rester entre les mains de l'auteur.
Les techniques de contournement ne fonctionnent plus avec les nouveaux systèmes de détectabilité tels que Pangram.
Ce que l'IA peut faire sans affecter votre statut d'auteur :
- Faire de la veille
- Structurer vos contenus
- Vous aider dans la rédaction
- Vérifier les faits
- Relire vos contenus et identifier les fautes
Ce calibrage permet à vos contenus de rester intègralement les vôtres, et vous pouvez y placer votre nom d'auteur en signature.
L'IA comme outil, mais pas comme auteur
Les LLM sont des systèmes très puissants de recherche et d'analyse. Sans ces modèles, je ne serais probablement pas en mesure de faire mon métier comme j'arrive à le faire aujourd'hui. Ma veille approfondie du secteur n'est possible que par cet usage avancé des modèles.
Il est important cependant de placer une barrière importante sur ce que l'IA ne doit pas faire pour un site. L'écriture du contenu en est selon moi un des principaux exemples.
Le contenu est le message d'un auteur ou d'une marque et seul un humain peut légitimement porter ce message et non une machine.
Enfin, le sujet est une question de transparence envers l'utilisateur cible en lui assurant qu'il lit un contenu issu d'une personne réelle avec un vécu, un message à porter et des valeurs. Une IA ne peut faire cela et cette transparence laisse le choix au lecteur de rester ou de repartir.