Ce que l'IA ne voit pas de votre page : le piège du JavaScript

Une page peut parfaitement se classer sur Google, renvoyer un code 200 et ne présenter aucun problème. Cependant, cela ne veut pas dire que les robots IA peuvent parfaitement l'explorer et récupérer son contenu.
En SEO, on a plus ou moins mis en retrait l'analyse d'accessibilité sous javascript car Google l'interprète et cela même quand le site tourne intégralement sous javascript avec un framework de type React ou Angular. Cette capacité a rendu le frein de javascript moins préoccupant et le sujet est passé davantage dans les sujets d'analyses secondaires.
Mais maintenant qu'une bascule se fait en AI Search, les choses sont en train de changer radicalement de nouveaux robots sont entrer en jeux et la documentation sur ces nouveaux robots n'apporte aucune confirmation sur leur capacité face au javascript et que l'on parle d'un site full javascript ou bien de l'usage d'un simple composant qui nécessite une exécution javascript. Nous allons donc faire le tour de ce qu'on sait à ce jour sur le sujet et ensuite nous allons voir comment cet audit Javascript doit être effectué en 2026 pour répondre aux exigences des nouveaux moteurs.
Le sujet du JavaScript redevient donc une préoccupation tant que les robots restent limités par ce niveau d'interprétation.
Les trois architectures pour lire une page
On distingue 3 architectures d'exploration et un robot qui explore une page appartient à l'une d'entre elles. On commence par la plus ancienne qui est le crawler traditionnel, à savoir une requête HTTP suivi d'une réponse HTML qui est enfin analysée.
Voici comment on pourrait le schématiser :
ARCHITECTURE 1 · CRAWLER TRADITIONNEL
GET URL
  ↓
HTML serveur
  ↓
analyse
La 2ème architecture intègre un navigateur. Une fois que la réponse HTML est restituée, la page est mise en file et elle est exécutée par un chromium sans interface qui produit un DOM rendu.
Ce mécanisme est celui que Google et Bing document depuis 2019. Des travaux académiques proches existent depuis 2012 dont celui de Mesbah qui publie Crawljax en 2012 dans ACM transactions on the Web.
ARCHITECTURE 2 · MOTEUR AVEC RENDU
GET URL
  ↓
HTML
  ↓
file de rendu
  ↓
Chromium sans interface
  ↓
exécution du JavaScript
  ↓
DOM rendu
  ↓
index
La 3ème architecture est celle des agents où le navigateur commence d'abord par charger une page complète pour que le modèle en reçoive ensuite une représentation intégrant un arbre d'accessibilité, une capture d'écran et du HTML filtré. Cela permet enfin au modèle de raisonner, de cliquer et de remplir un formulaire. Google et Open AI documentent ces mécanismes avec leurs propres spécificités. OpenAI lit des balises ARIA de la page tandis que chez Google, les agents analysent captures d'écran et DOM.
ARCHITECTURE 3 · AGENT NAVIGATEUR
navigateur complet
  ↓
page rendue
  ↓
DOM · arbre d'accessibilité · capture d'écran · HTML filtré
  ↓
sélection, élagage
  ↓
contexte transmis au modèle
  ↓
raisonnement, action
La 3ème architecture que nous venons de voir exécute le Javascript mais les moteurs qui cite vos pages, ne sont pas dans cette catégorie. Les bots qui parcourent le web pour apprendre ou pour récupérer du contenu sur vos pages ne sont pas confirmés comme être en mesure d'exécuter le javascript. Aucune documentation de la part des nouveaux acteurs ne l'affirme et la communauté se range plutôt à dire que la plupart des modèles qu'on utilise n'interprètent pas le contenu sous javascript.
On a souvent constaté que le contexte d'exploration influençait la capacité des modèles à pouvoir lire un contenu comme c'est le cas des images, qui peuvent être lues en pleine conversation mais pas lors d'une exploration de page.
On retrouve cette situation lorsque l'on partage un onglet de son navigateur à un modèle. Cette fonctionnalité s'est répandue et existe sur Chrome, Comet ou même Edge.
Dan Petrovic a réalisé un test sur cette fonctionnalité afin de voir si le JavaScript constituait un frein dans ce mode de navigation très spécifique. Il s'avère qu'ici le fonctionnement est très différent, la page n'est pas restituée à l'assistant IA en HTML mais elle est convertie en Markdown structuré. Dans ce cas particulier, le JavaScript n'est plus un frein direct à l'exploration de la page.
Il ne faut donc pas comparer ces deux cas et porter une conclusion hâtive. Le problème d'exploration de base reste et ce cas spécifique ne résout rien au problème de base.
Je propose maintenant qu'on s'intéresse à la documentation.
Ce que la documentation dit sur chaque modèle
Avant de vous lancer dans un audit, il faut bien délimiter le périmètre qui nous intéresse et donc ce qui compte pour un site francophone.
5 systèmes occupent le marché en France, à savoir Google, Bing, OpenAI, Anthropic et Perplexity. Les 2 premiers qui sont historiques et qu'on connait bien proposent déjà une documentation héritée du SEO. Les 3 nouveaux qui émergent avec l'AI Search ne documentent rien sur le rendu du Javascript.
La documentation de Google fait état de 3 phases successives : l'exploration, le rendu et l'indexation. Un chromium, maintenu à jour exécute le javascript et Google en reçoit un HMTL rendu pour l'indexation. La documentation qui existe depuis l'ère du SEO a été enrichie et le guide de Mai 2026 sur les fonctionnalités génératives précise que celles-ci fonctionnent sur la même base. Un seul cas reste non confirmé côté Google, est celui d'une d'url que l'on soumet dans l'application Gemini, un fetch à la demande de l'utilisateur et dans ce cas spécifique l'exécution du javascript n'est pas confirmée.
Bing
Depuis 2019, Bing exécute également le Javascript comme Google et il passe par Microsoft Edge comme moteur pour rendre les pages intégrant des mises à jour fréquente avec la version la plus récente. L'IA de Microsoft, à savoir Copilot, bénéficie de la même capacité d'execution du Javascript.
Comme pour Google la récupération en directe de contenu sous javascript, depuis une page soumise par conversation n'est confirmée comme prise en charge.
OpenAI
Chez OpenAI, la documentation cite quatre agents spécifiques : OAI-SearchBot pour la recherche web, OAI-AdsBot, GPTBot pour la phase d'entraînement, ChatGPT-User pour les demandes venant directement de l'utilisateur.
Pour rendre son site éligible à Chat GPT, OAI-SearchBot doit être autorisé et l'hébergeur ou CDN doit autoriser les adresses IP qui sont publiées. L'agent d'Atlas qui navigue à la place de l'utilisateur interprète les balises Aria.
A date, la documentation ne fait état d'aucune phase de rendu, ni de l'usage de chromium ni même d'un DOM rendu.
Anthropic
Trois robots sont recensés côté Anthropic :
- ClaudeBot pour tout ce qui concerne l'entrainement des modèles
- Claude-User pour traiter les pages traitées sur demande de l'utilisateur
- Claude-SearchBot qui parcourt le web pour améliorer la qualité des réponses
La documentation affirme respecter les technologies anti-contournement telles que les CAPTCHA. Comme pour OpenAI aucun mot concernant le rendu Javascript.
Perplexity
La documentation de Perplexity ne dit rien non plus sur le rendu Javascript. On y retrouve simplement les deux catégories de robots : PerplexityBot pour l'index et Perplexity-User pour le traitement des demandes de l'utilisateur.
| Écosystème | Robots | Rendu, index | Rendu, récupération | Source |
|---|---|---|---|---|
| Googlebot | Documenté, Chromium | Non documenté | Google Search Central | |
| Bing | bingbot | Documenté, Edge | Non documenté | Bing Webmaster Blog |
| OpenAI | OAI-SearchBot, GPTBot, ChatGPT-User, OAI-AdsBot | Non documenté | Non documenté | developers.openai.com |
| Anthropic | ClaudeBot, Claude-SearchBot, Claude-User | Non documenté | Non documenté | support.claude.com |
| Perplexity | PerplexityBot, Perplexity-User | Non documenté | Non documenté | docs.perplexity.ai |
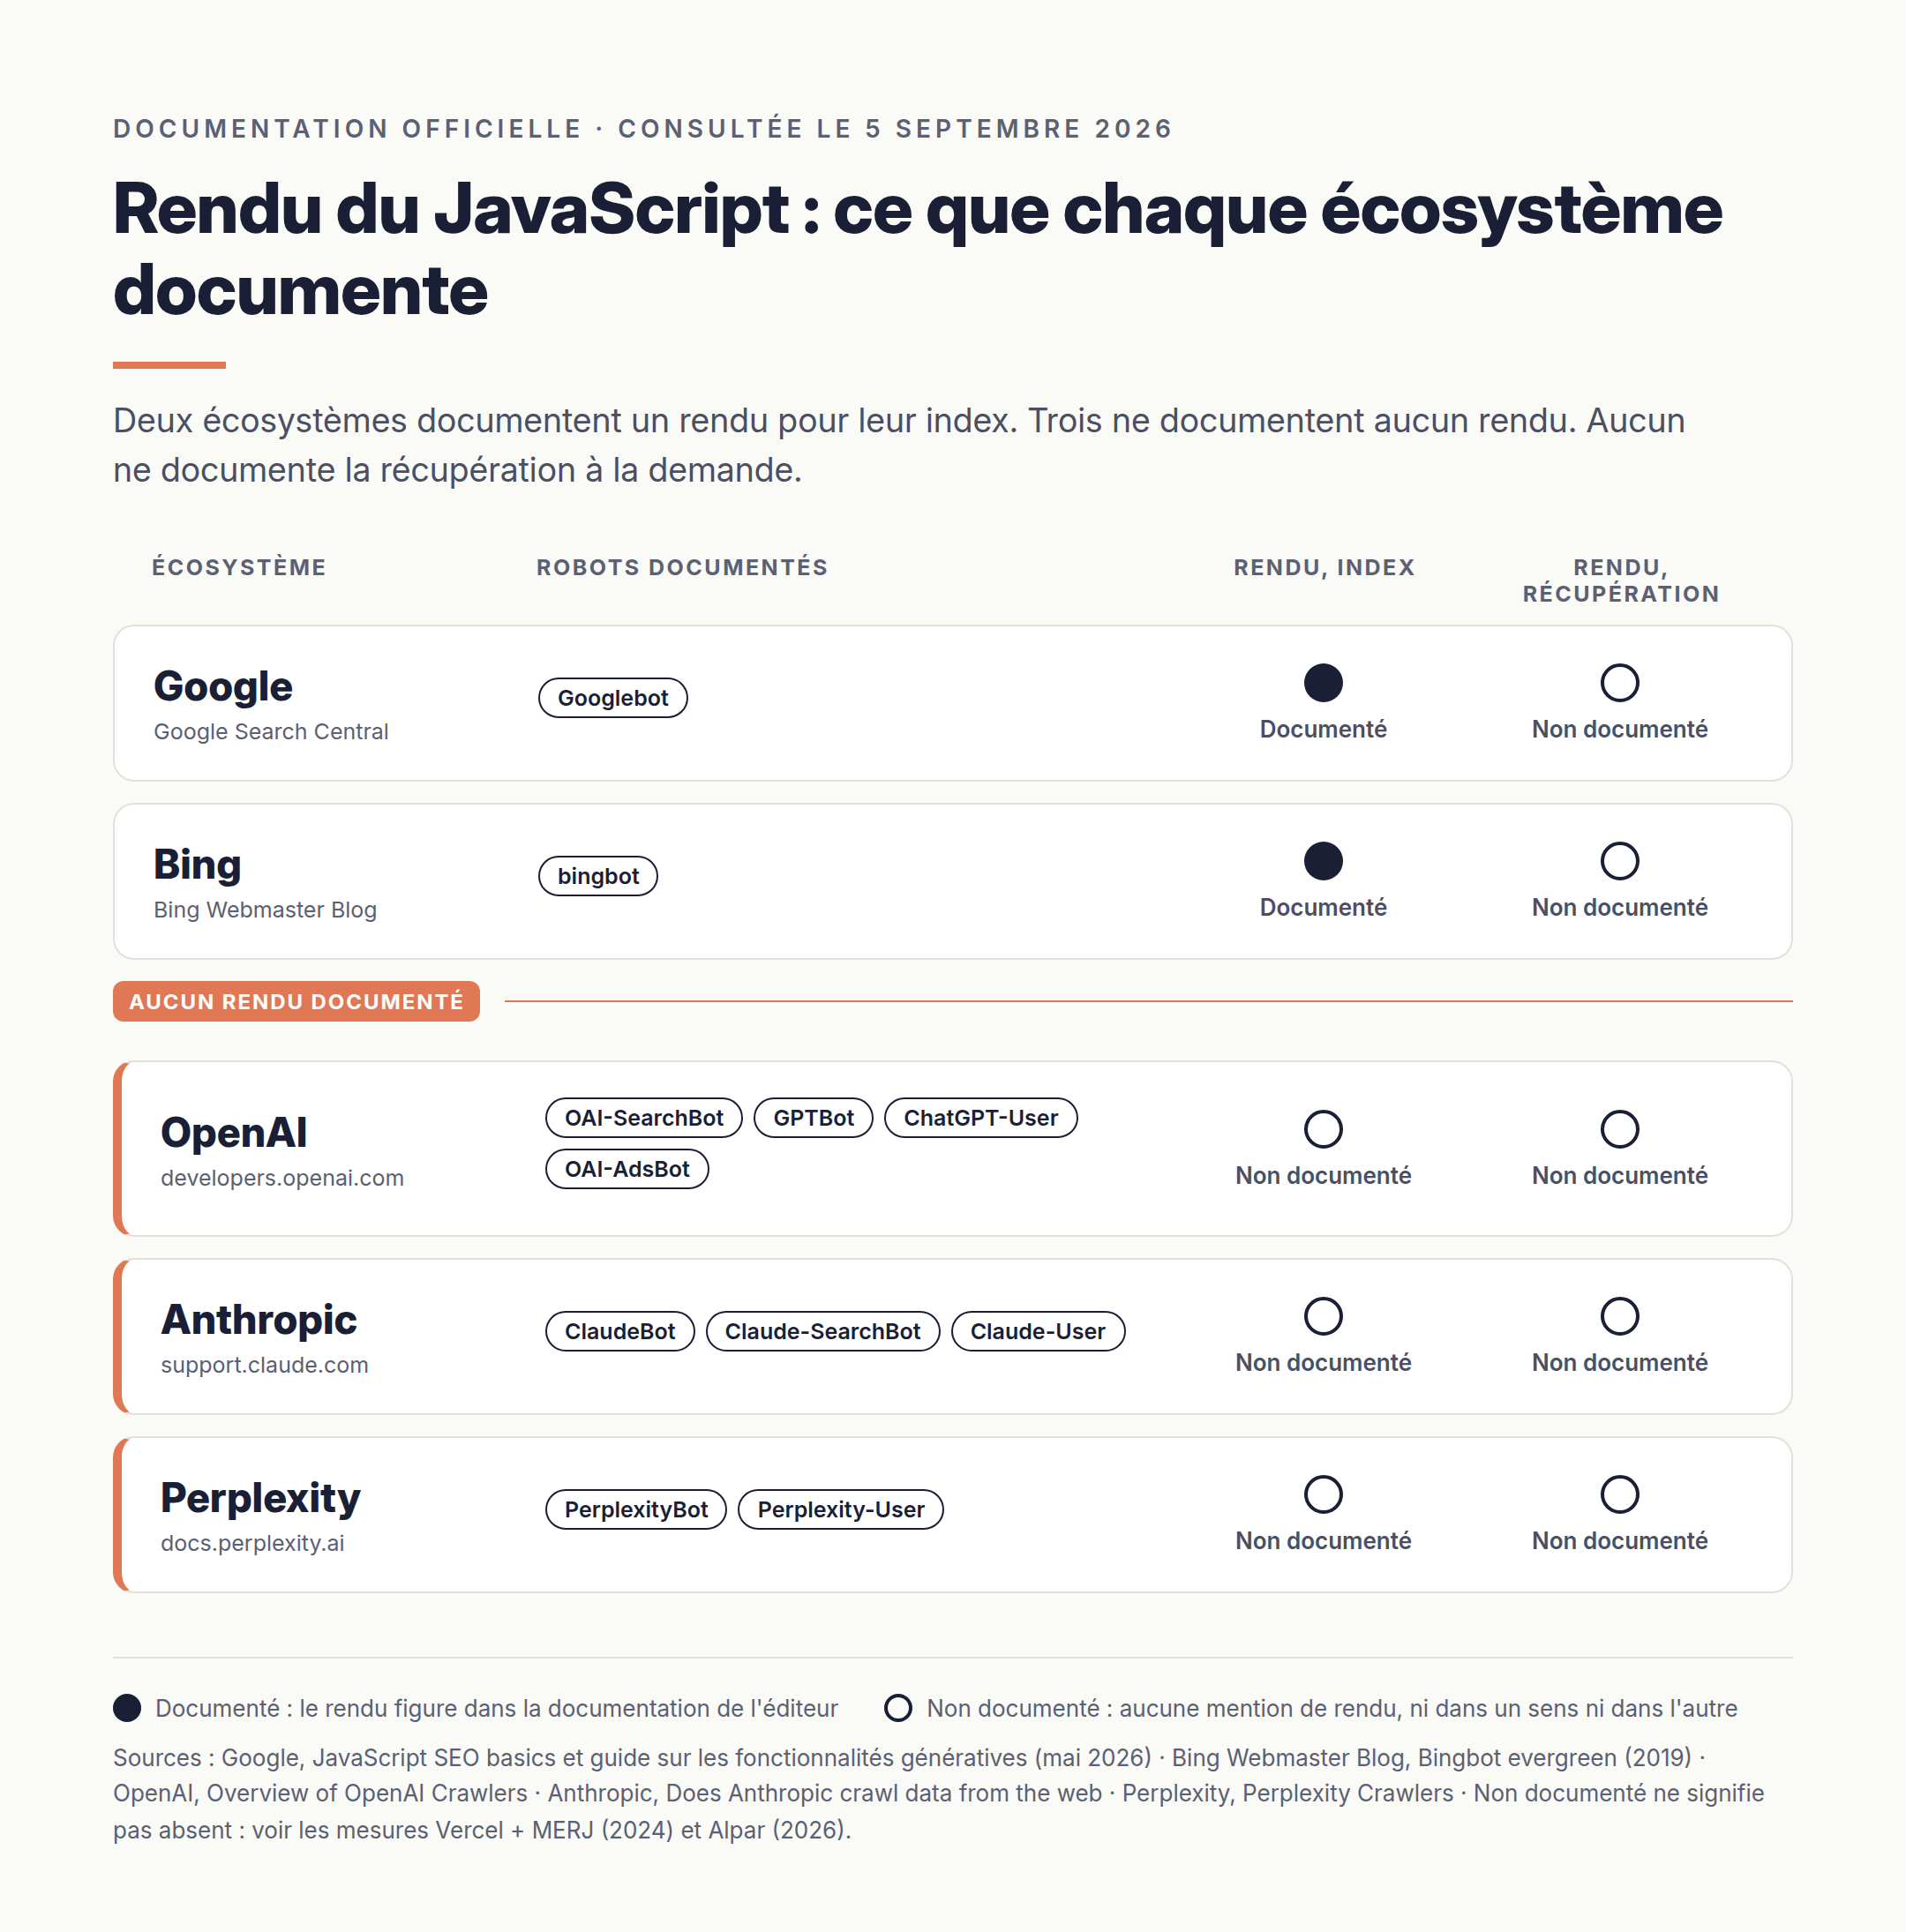
L'absence d'information au sujet du rendu pour les trois moteurs AI Search émergent n'est pas une surprise et laisse entendre une contrainte réelle. La communauté GEO ne s'est pas privée de faire des tests pour appuyer cette théorie concernant le javascript sachant que les enjeux en découlent sont important.
Les 2 études que nous allons voir juste après et que je prends en exemple appuie cette hypothèse encore confirmé par la documentation officielle en attendant un changement.
Une exploration qui peut se faire de deux façons différentes
En Ai Search, il faut bien distinguer deux chemins qui amène un bot sur une page. Le premier est par l'exploration planifié au moment où le bot parcourt le web pour indexer. Le second est celui que l'utilisateur déclenche quand il soumet une url à un assistant IA dans une conversation. Dans ce second cas, le robot sollicité n'est pas exactement le même et la lecture de la page n'est pas confirmée être identique dans ces 2 cas spécifiques.
Bing est un excellent exemple dans ce cas de figure. Son index est rendu par Edge comme nous l'avons évoqué précédemment. La récupération côté Copilot passe par un service qui télécharge le fichier de script mais ne l'exécute pas. Le constat est plus ou moins similaire côté Google.
Voici la synthèse qu'on peut en dresser sur ce tableau :
| Écosystème | Crawl planifié, doc | Récupération, doc | Récupération, mesure juin 2026 |
|---|---|---|---|
| Rend | Non documenté | Ne rend pas, Gemini | |
| Bing, Copilot | Rend | Non documenté | Ne rend pas |
| OpenAI | Non documenté | Non documenté | Ne rend pas |
| Anthropic | Non documenté | Non documenté | Ne rend pas |
| Perplexity | Non documenté | Non documenté | Ne rend pas |
| Mistral | Non mesuré | Non documenté | Rend |
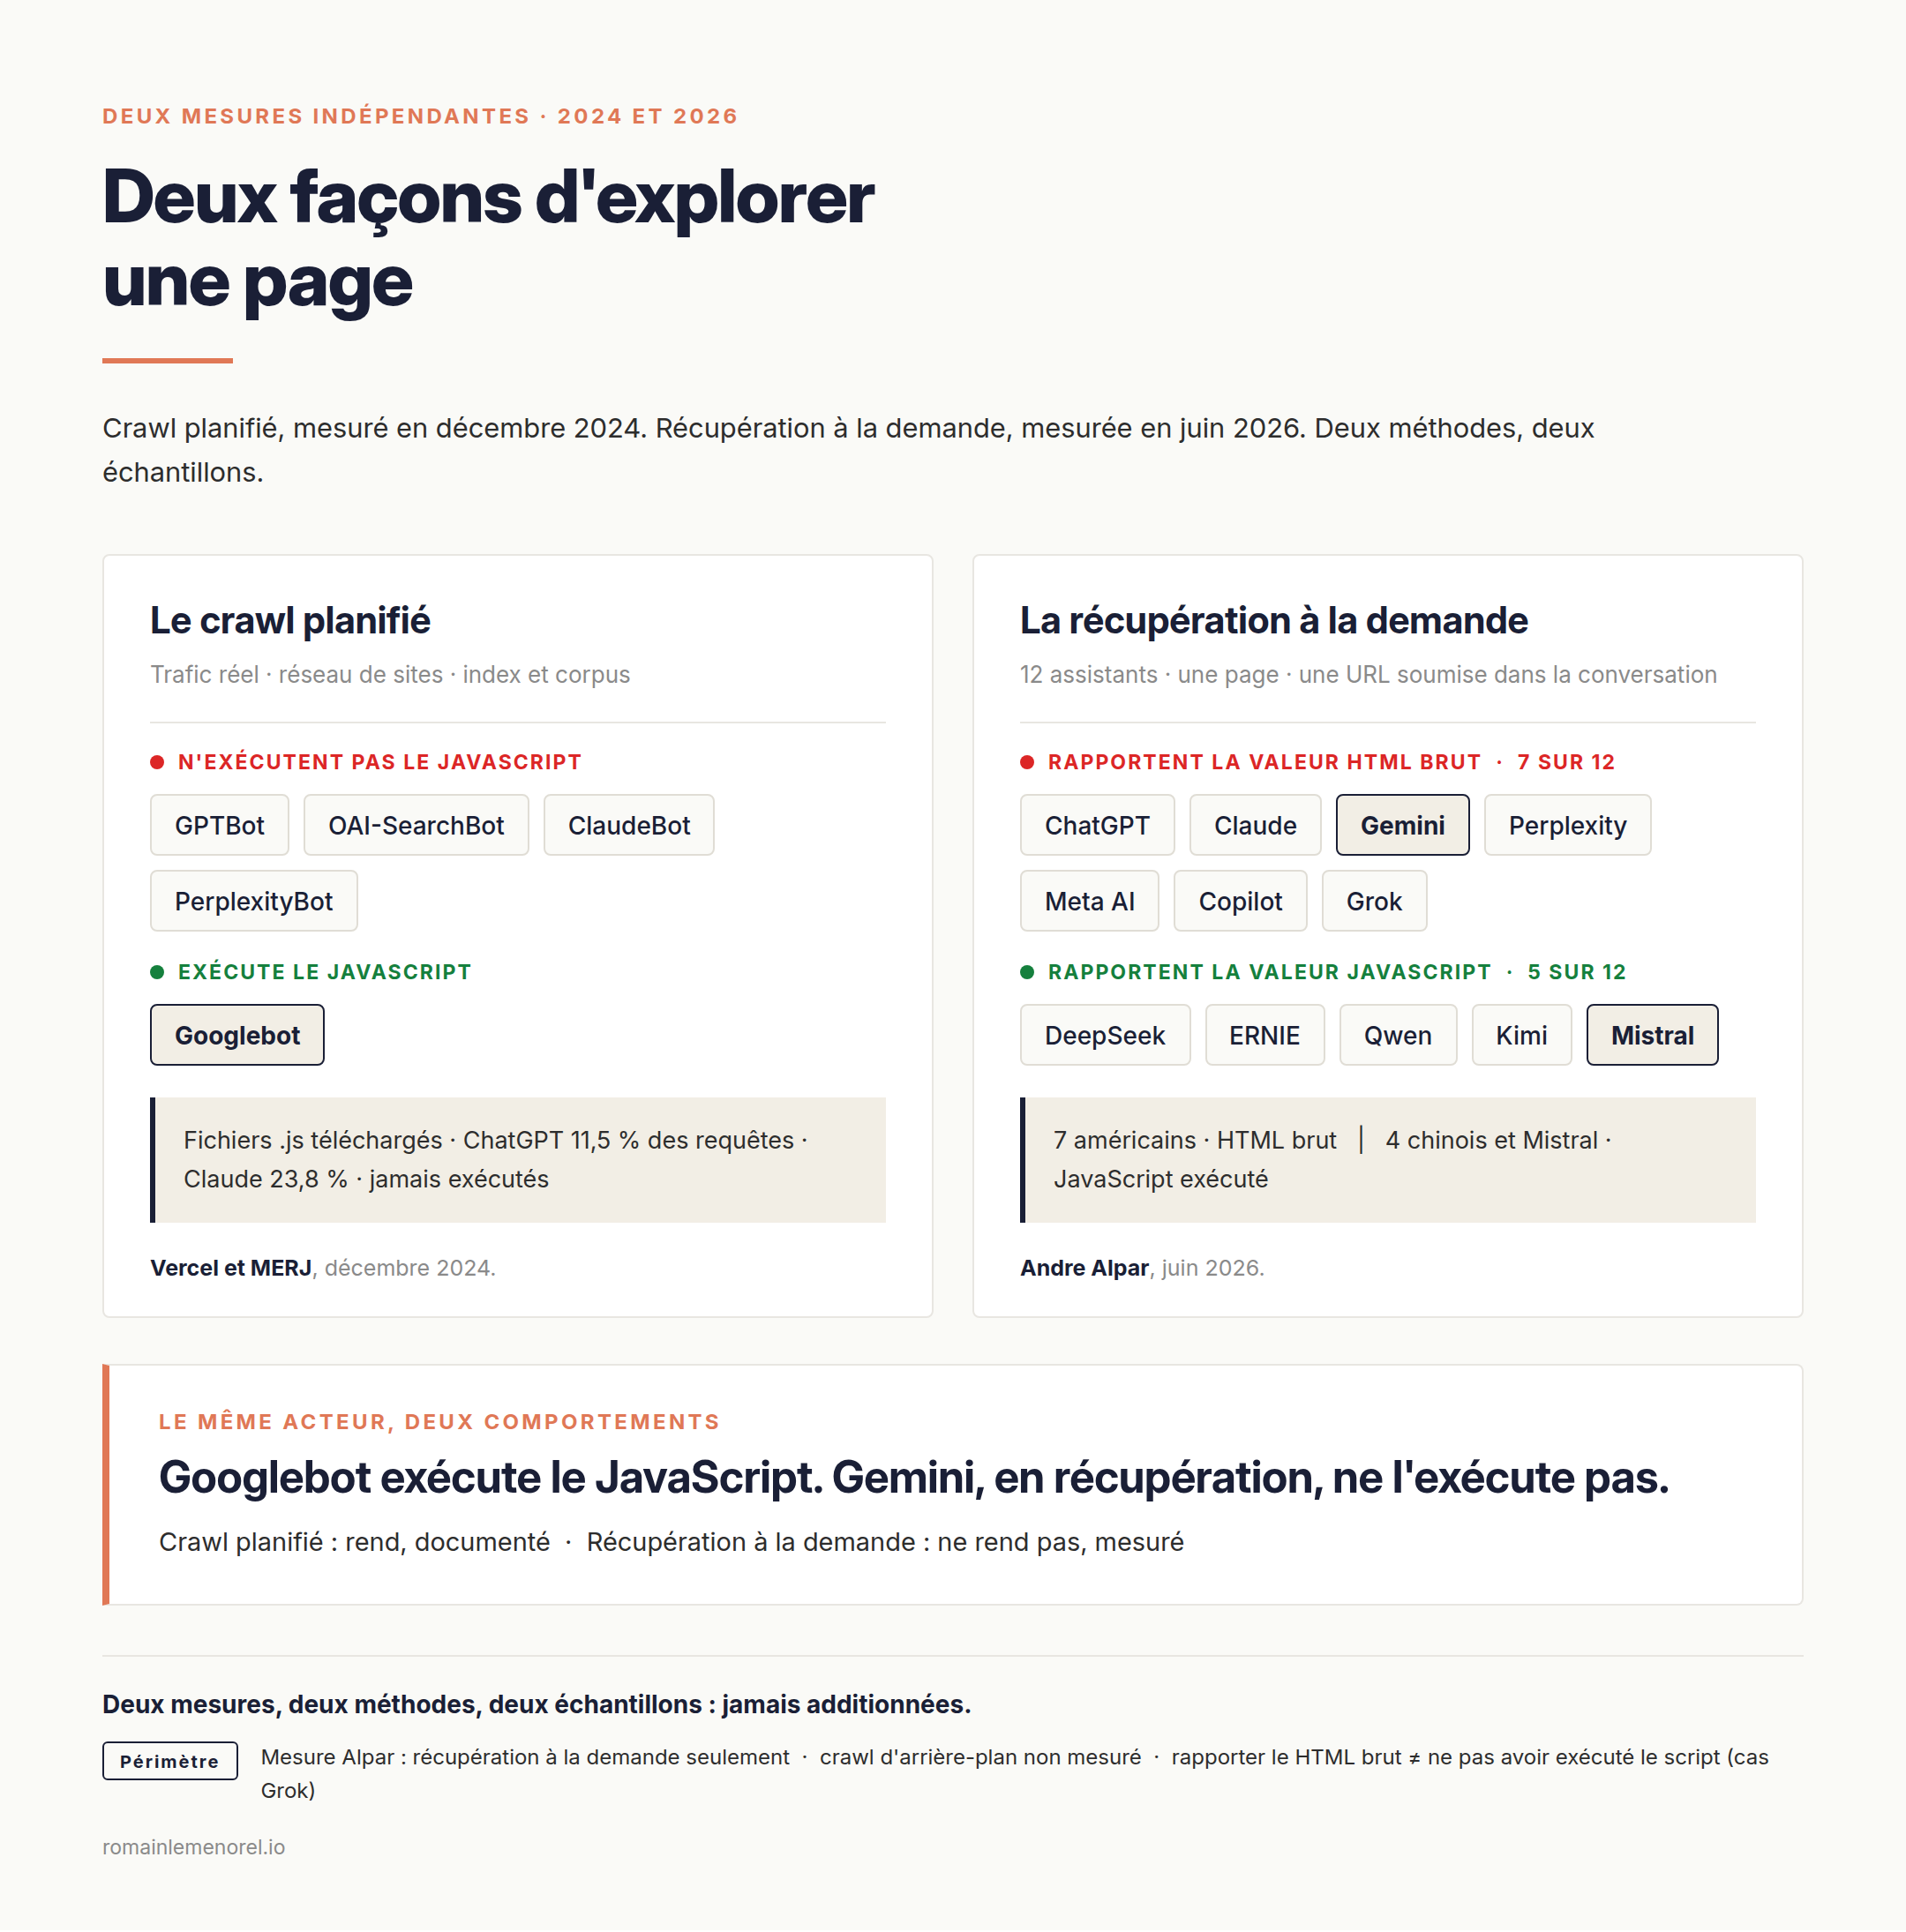
C'est précisément dans ce sens que les robots ne doivent pas être rangé ensemble même quand ils proviennent du même système.
| Famille | User-agents | Déclencheur |
|---|---|---|
| Entraînement | GPTBot, ClaudeBot | Calendrier opérateur |
| Recherche IA, index | OAI-SearchBot, Claude-SearchBot, PerplexityBot, bingbot, Googlebot | Calendrier opérateur |
| Récupération à la demande | ChatGPT-User, Claude-User, Perplexity-User | Question humaine |
Une dernière nuance, qui n'est pas anodine. La capacité d'interprétation du JavaScript peut aussi dépendre de la méthode d'exploration, un crawl du site classique vs une exploration à la demande d'une url par un utilisateur peut générer des comportements différents. Dans le cas d'une exploration à la demande, Alpar a constaté des limitations même chez Gemini, normalement en mesure d'exécuter le JavaScript.
Cette analyse pose une nuance qui s'applique à l'ensemble de l'audit. L'assistant IA peut très bien exécuter du Javascript et répondre sur du HMTL brute ou bien déclaré ne pas avoir eu accès à une page alors que celle-ci était en 200.
Une mauvaise lecture de la page ne signifie donc pas que la page n'est pas intégralement visible aux robots, il faut faire particulièrement attention à cette association qui peut être trompeuse.
On peut donc utiliser les logs serveur pour savoir si un bot a trouvé une page, on ne peut par contre pas savoir s'il l'a correctement analysée.
Où le contenu est-il assemblé ?
Pour en revenir aux frameworks utilisant du JavaScript, tels que React, une question se pose souvent : faut-il envisager une migration et abandonner React ?
La réponse n'est pas nécessairement "oui", la question à se poser avant d'envisager ce type de solution est de savoir à quel moment votre page est assemblée en HTML.
Si l'assemblage se fait au niveau du serveur et que le contenu est envoyé ensuite en HTML avant même qu'il n'atteigne le navigateur, alors tout est bon et les robots IA pourront parfaitement lire la page. Quel que soit le framework utilisé, le constat est le même dès lors que le contenu est assemblé côté serveur.
Ce qui reste invisible, c'est lorsque l'exécution du JavaScript se fait dans le navigateur du visiteur. Un framework ne constitue pas un frein par défaut et il est important de prendre la bonne décision avant d'engager une refonte d'urgence potentiellement non nécessaire.
| Assemblage | Reçu sans rendu | Verdict |
|---|---|---|
| Génération statique, SSG | Page complète | Lisible |
| Rendu serveur, SSR | Page complète | Lisible |
| Hydratation, hybride | Page initiale | Par composant |
| Rendu client, CSR, SPA | Coquille | Invisible |
| Pré-rendu dynamique | Statique, robots reconnus | Partiel |
Google a historiquement connu la même évolution, le JavaScript a longtemps été un frein de la même façon jusqu'à ce qu'il soit intégralement pris en charge, quel que soit le moment où le contenu est assemblé.
Avec l'AI Search, on fait un retour en arrière à cette période que l'on a connue avec Google.
Etape 1 : ce que le serveur envoie
L'audit doit commencer par la première question que l'on se pose : que contient la réponse HTTP avant toute forme d'exécution ? Un test fiable consiste à récupérer cette source sans navigateur. C'est précisément ce que les robots de la première architecture reçoivent.
Voici une commande que vous pouvez lancer dans un terminal :
curl -L --compressed \
  -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; OAI-SearchBot/1.4; +https://openai.com/searchbot" \
  https://www.exemple.com/page/ > page-brut.html
2 points importants comptent au moment de ce test. Le user agent d'abord dont le contenu servi peut différer selon ce que le serveur lit dans cet en-tête. Il faut donc y indiquer le user agent de la famille qu'on souhaite analyser. Le code de réponse est également un point important d'analyse. Le code 202 et 403 sont généralement les plus fréquents pour un document HTML bien formé.
curl -L --compressed -o /dev/null -s -w "%{http_code} %{size_download}\n" \
  -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" \
  https://www.exemple.com/page/
On cherche ensuite si des éléments spécifiques de la page sont bien restitués, on cherche des éléments clés tels que le h1 de la page, le début du contenu, le prix ou encore la mention d'une marque.
grep -c "Formation développeur web" page-brut.html
grep -o '<h1[^>]*>.*</h1>' page-brut.html
grep -c 'application/ld+json' page-brut.html
Une limite concernant cette méthode manuelle est votre IP qui ne sera pas celle du robot. Elle n'assure pas qu'un blocage aura lieu en amont.
Attention au piège de la fonction qui désactive le JavaScript qui ne détermine pas si un contenu est absent du HTML, il peut simplement être masqué par un élément d'interactivité utilisant du JavaScript.
La navigateur chrome sans Javascript reste bien un navigateur qui applique le style CSS et peut servir des pages à partir de son cache. Ce test ne simule donc pas ce que voit le robot.
Etape 2 : les deux crawls de Screaming Frog
Le code source d'une page que vous pouvez récupérer d'un crawl comparé directement à ce que vous voyez en réel est le comparatif qui peut révéler un élément non visible aux assistants IA.
Une comparaison minutieuse de vos sources HTML avec la page réellement affichée est un moyen efficace. Il faut chercher dans la source les informations essentielles que le navigateur rend et qui n'y figurent pas.
L'analyse HTTP concerne une page mais le crawler doit être en mesure de produire les deux versions de chaque url analysée, l'originale et la version rendue. C'est précisément ce que Screaming frog gère avec cette configuration :
Configuration > Spider > Rendering
   Rendering            : JavaScript
Configuration > Spider > Extraction
   Store HTML           : activé
   Store Rendered HTML  : activé
Avec ce paramétrage le crawl analyse les deux états et permet de les comparer sur une même fenêtre de rapport.
ORIGINAL HTML            RENDERED HTML
réponse serveur          DOM après JavaScript
contenu A                contenu A + contenu B
Screaming Frog propose différents rapports prêts à l'emploi et ces rapports traduisent chacun un constat en AI Search qu'il faut traduire :
FILTRE SCREAMING FROG                 LECTURE SEO (Google)     LECTURE AI SEARCH
Contains JavaScript Content           à surveiller             texte invisible
Contains JavaScript Links             à surveiller             liens non découverts
Page Title Only in Rendered HTML      à surveiller             titre absent
H1 Only in Rendered HTML              à surveiller             H1 absent
Meta Description Only in Rendered     à surveiller             description absente
Canonical Only in Rendered HTML       déconseillé              canonical absente
Noindex Only in Original HTML         bloque le rendu          sans objet
Uses Old AJAX Crawling Scheme URLs    obsolète depuis 2015     obsolète
Ces rapports sont donc précieux sur vos pages stratégiques car ils peuvent permettre d'identifier des composants précis sollicitant du javascript. J'utilise le crawl avec rendu javascript a minima au lancement d'un projet pour évaluer la part du javascript dans les pages.
Sur un site e-commerce, on peut par exemple se rendre compte qu'un bloc de push produits en format slider est intégralement géré en javascript rendant le bloc de maillage inefficace pour les systèmes qui n'exécutent pas le javascript. Encore, cela peut concerner un menu de navigation qui provoque ici une incapacité du robot à naviguer sur le site.
Il faut bien savoir que le crawl avec rendu est lourd et lent. En local il peut solliciter votre PC et peut durer très longtemps. Sur un site de forte volumétrie, mon conseil est d'échantillonner votre analyse. Il faut savoir que l'export des versions originales et rendues ne peut pas être filtré. Le téléchargement des exports peut donc être massif si vous faites ce crawl sur l'intégralité du site.
Etape 3 : les critères de comparaison des 2 versions
Maintenant que vous avez les deux versions de vos pages sous la main, la checklist des éléments à analyser est à définir. Ce sont les éléments que vous auditez systématiquement mais il ne faut pas en oublier un seul.
Voici un tableau que je propose avec une mesure d'évaluation distincte pour le SEO et l'AI Search
| Élément | Importance SEO | Importance AI Search |
|---|---|---|
| title | très forte | très forte |
| meta description | moyenne | faible |
| canonical | très forte | moyenne |
| meta robots | critique | critique |
| H1 et intertitres | forte | très forte |
| contenu principal | critique | critique |
| liens internes | critique | forte |
| navigation, menus | critique | forte |
| fil d'Ariane | forte | moyenne |
| données structurées | forte | moyenne |
| hreflang | forte | faible |
| pagination | forte | moyenne |
| images et alt | variable | moyenne |
| auteur, biographie | forte | très forte |
| citations, sources | moyenne | très forte |
| informations d'entité (organisation, adresse, contacts) | forte | très forte |
| prix, disponibilité, caractéristiques | forte | très forte |
| dates de publication et de mise à jour | moyenne | forte |
| FAQ, réponses courtes | moyenne | forte |
Voici un exemple que l'on peut obtenir sur une page dont le title est le seul élément servi :
HTML BRUT

<title>Formation développeur web</title>
<body>
  <div id="app"></div>
  <script src="/app.js"></script>
</body>
HTML RENDU

<h1>Formation développeur web</h1>
<p>Devenez développeur en douze semaines...</p>
<a href="/formations/">Nos formations</a>
<div class="author">Par ...</div>
<script type="application/ld+json">...</script>
Dans le cas illustré ci-dessus, tout ce qui est extrait dans le HTML rendu ne l'est pas dans la version originale qui ne remonte que la balise title. Tout système qui n'exécute pas le javascript reçoit donc une coquille vide.
Voici les différents niveaux d'interaction qui peuvent interférer avec une page la rendant graduellement moins accessible.
| Niveau | Apparaît | Déclencheur | Lisible par |
|---|---|---|---|
| L0 | HTML serveur | Aucun | Tous |
| L1 | Après JavaScript | Chargement | Google, Bing |
| L2 | Après interaction | Clic, défilement, appel API, consentement | Aucun robot d'index |
| L3 | État utilisateur | Connexion, cookie, session | Aucun |
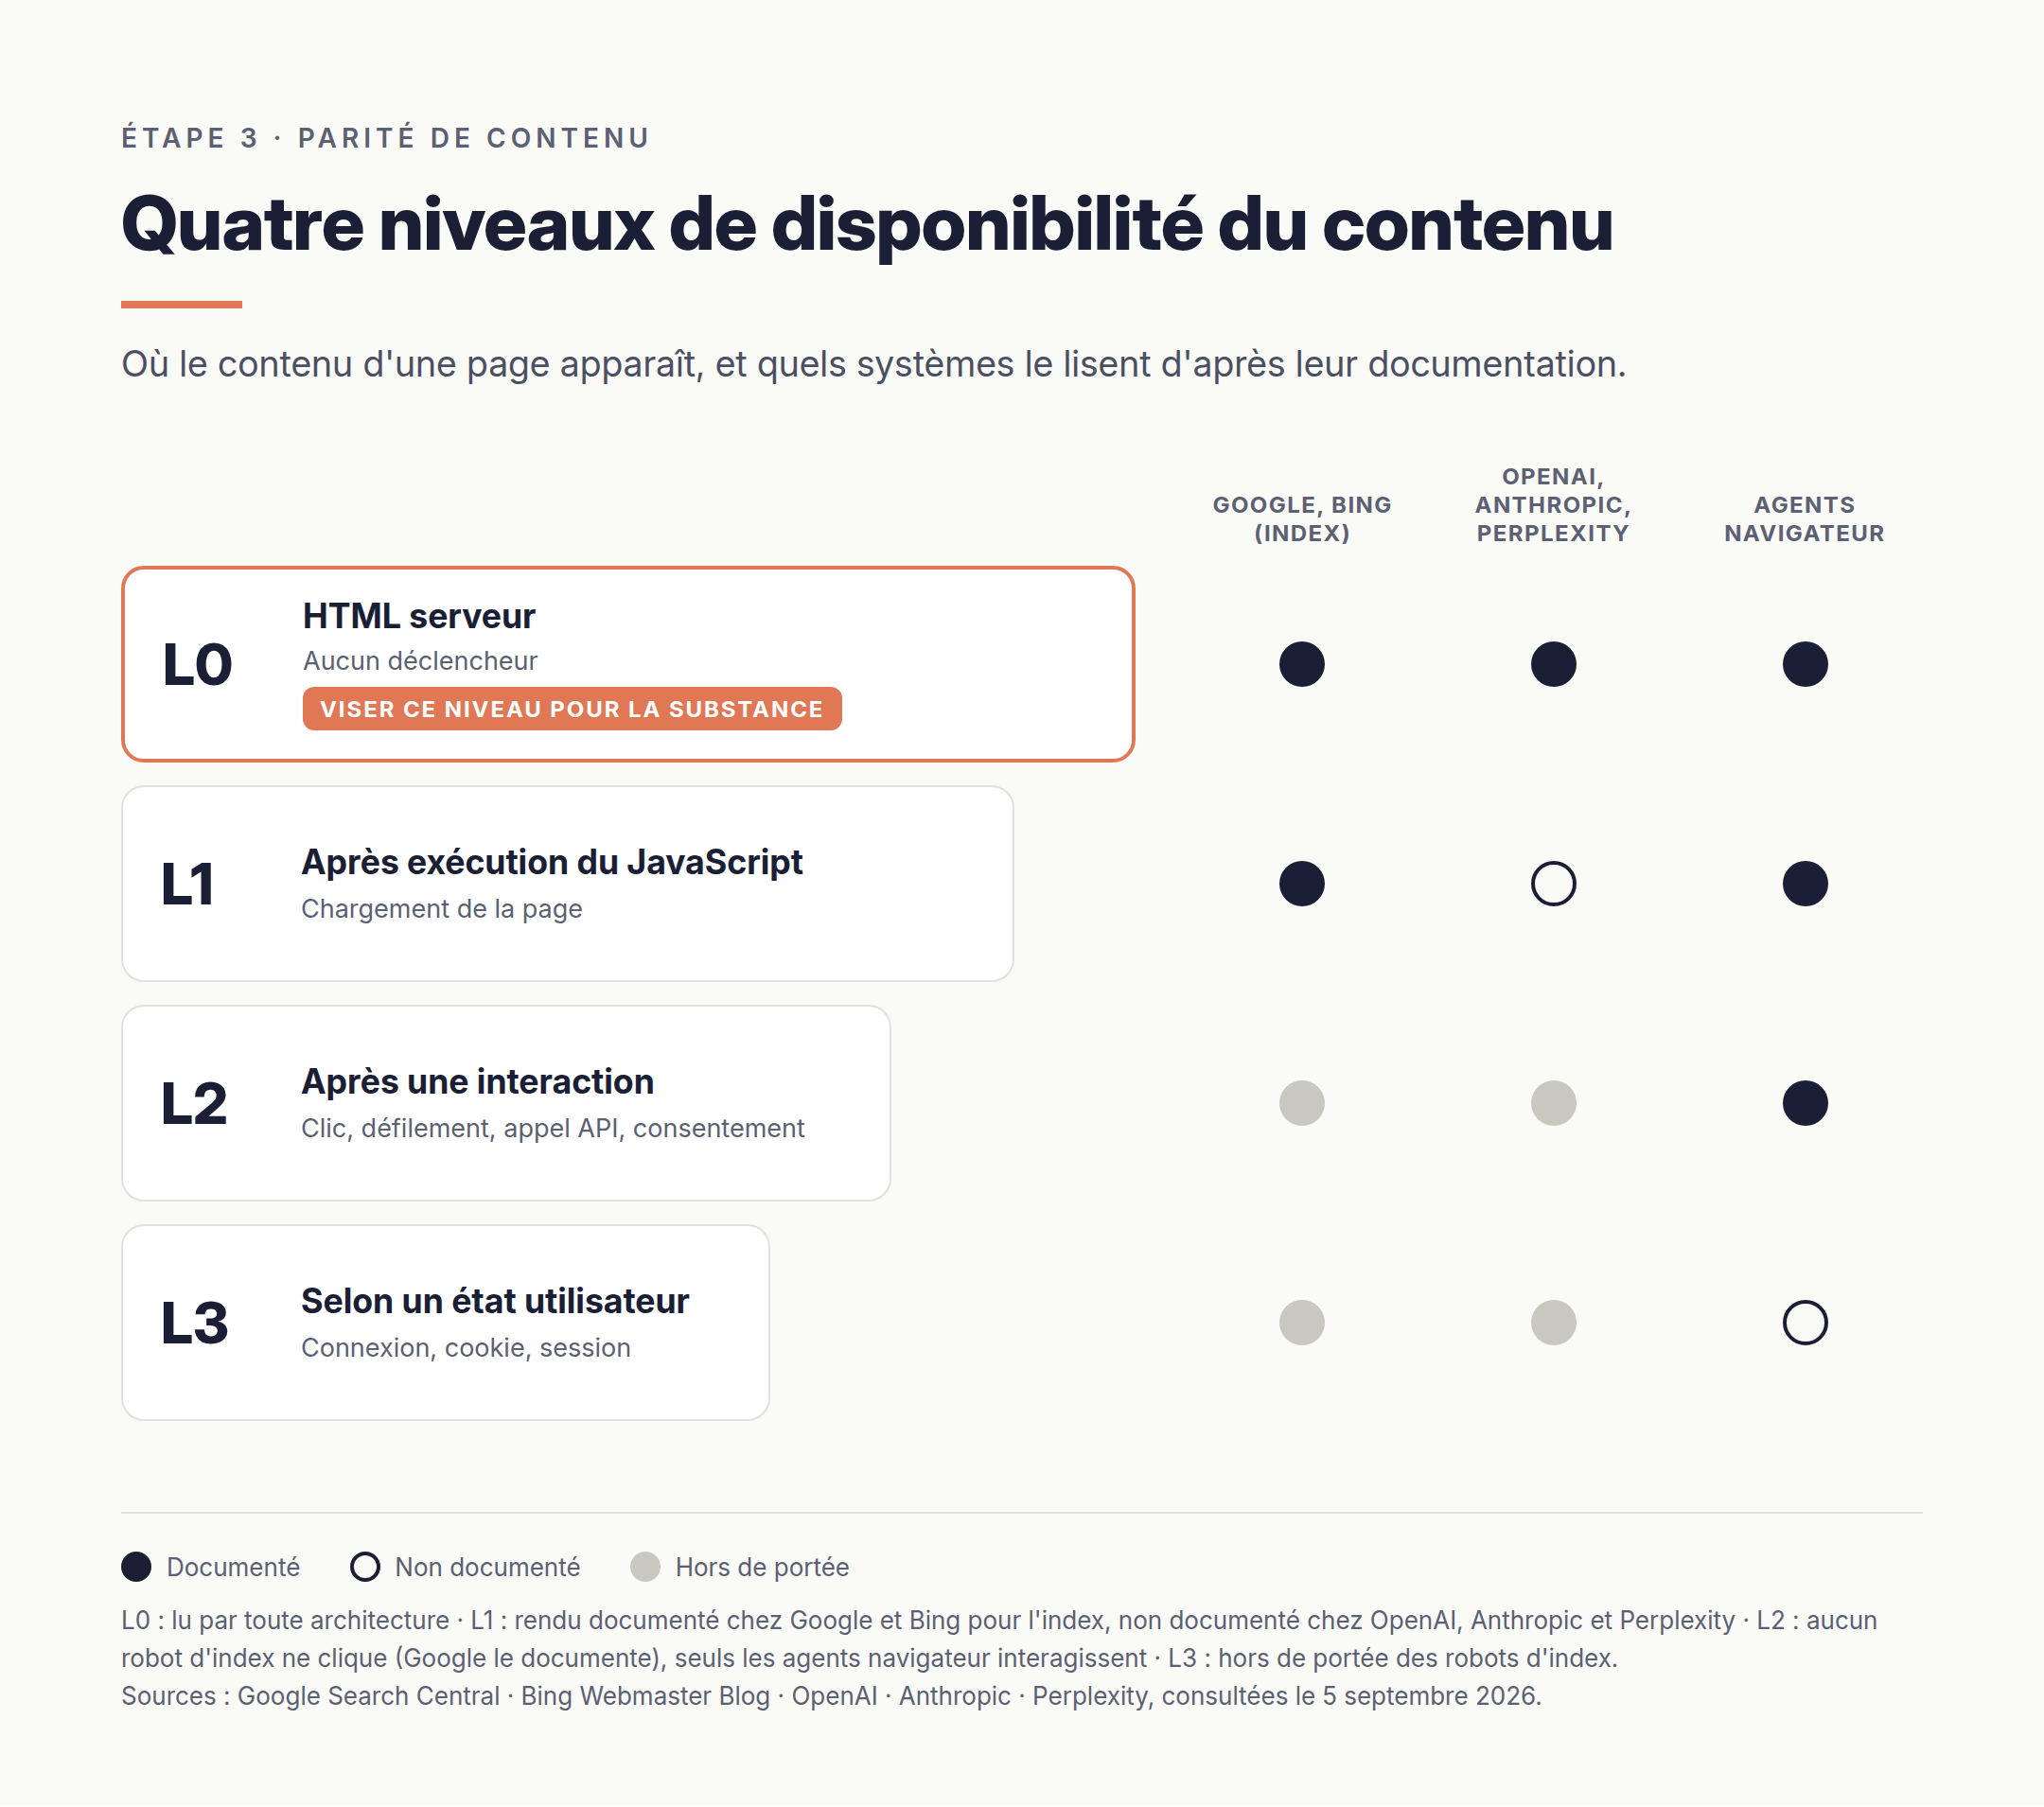
Le niveau L0 est celui que tout système peut lire, le niveau L1 est celui que Google et Bing peuvent interpréter sous certaines conditions. L2 est celui qui est à risque car tous les robots, y compris Google, ne sont pas en mesure de cliquer et si cette interaction est requise pour afficher un contenu, celui-ci peut rester hors de portée.
Etape 4 : l'analyse des logs serveur
Lors des trois premières étapes nous avons pu identifier ce qui peut manquer sur votre page. Cette analyse ne dit en revanche rien sur la visite du robot ni la réponse qu'il a reçue du serveur. Cette preuve n'existe que dans les logs serveur avec trois conditions de lecture :
- Par famille de robots
- Par user agents
- Par plage IP que chaque éditeur publie
La dernière version du log file Analyzer dispose de ces pré réglages dans sa dernière version d'Avril 2026.
Une attention toute particulière doit être portée sur les codes de réponse reçu pour chaque user agent. Tout ce qui n'est pas en 200 doit être analysé. Le code 499 est celui qu'il faut regarder en priorité car il indique que le client a abandonné avant la fin de la réponse. Un croisement avec le crawl peut être fait pour détecter des pages dans le crawl mais pas dans les logs.
Ce qui bloque avant le rendu
Nous allons maintenant voir une autre situation mais qui cette fois ne fait pas référence directement au JavaScript. On sort donc un peu du sujet de base mais cela vaut la peine d'en parler car c'est un sujet qui peut représenter un frein majeur.
Suganthan Mohanadasan documente un test très intéressant qui ouvre un débat. Sur des logs serveur, une page de son site reçoit 3 hits positifs avec des pages complètement chargées. Mais à partir du 4ème hit, la page est bloquée, un pare-feu applicatif renvoie une page de vérification qui exige d'exécuter du JavaScript avec un code HTTP 202. L'origine de ce problème provient d'une limitation de débit fixée à 3 requêtes par adresse IP.
Cette page de test, qui ne pose aucun souci côté navigateur pour un utilisateur constitue un blocage pour un robot qui n'exécute pas le JavaScript.
Cela fait d'ailleurs pont avec ce que la documentation des modèles indique notamment sur les règles WAF ou l'autorisation par l'hébergeur et CDN.
Le blocage au niveau de l'hébergeur
Un blocage de ce type est possible sans la moindre décision de votre part. Depuis le 1er Juillet 2026, Cloudflare catégorise les bots IA sous trois catégories :
- Search pour les bots qui explorent et indexent
- Agent pour les bots qui agissent en temps réel pour un utilisateur
- Training pour les bots d'entrainement
Cloudflare prévoit de bloquer par défaut les 2 dernières catégories à partir du 15 septembre et ce pour tous les nouveaux domaines.
Ce blocage soulève des questions et accroit l'importance de ces paramétrages qui ne seront plus dépendant d'un choix mais d'une mécanique par défaut.
| Catégorie | Robots | Défaut, 15 septembre 2026 |
|---|---|---|
| Search | OAI-SearchBot, PerplexityBot, Claude-SearchBot | Autorisé |
| Agent | ChatGPT-User, Claude-User, agents navigateur | Bloqué |
| Training | GPTBot, ClaudeBot | Bloqué |
Ce sont donc des choix majeurs qui ont un impact mais que vous n'avez pas nécessairement décidés. Ce sont donc des points de vigilance à suivre côté hébergeur car le blocage peut provenir même à cette étape.
Indexé ne veut pas dire récupérable
Dan Petrovic effectue un autre test et ici rien à voir avec le JavaScript.
Son test consiste à mettre en 404 une page de son site initialement connue d'AI Mode. Quand la page passe en 404, le statut est constaté puis quand Petrovic la remet en ligne plus tard, AI Mode persiste à la voir en erreur malgré son retour dans l'index.
Son analyse montre qu'AI mode ne fait pas une lecture du web en direct, il puise d'abord dans un magasin de contenu non rattachée directement à l'index de recherche.
Cela remet aussi en question le lien entre la bonne position sur Google et son impact direct sur la récupération des contenus de vos pages.
Une stratégie d'AI Search doit anticiper ces freins
Le contenu qui compte pour votre site doit être accessible aux assistants IA et vous devez vous assurer que ceux-ci sont chargés en rendu serveur ou génération statique. La refonte n'est pas l'option à privilégier, il est préférable de privilégier une intervention ciblée qui ne remet pas en question l'ensemble de l'architecture du site.
La règle à retenir est que tout ce qui contribue à la bonne compréhension d'une page doit être servie en niveau L0. Le Javascript prend tout le reste.
| Viser L0, côté serveur | Garder en JavaScript |
|---|---|
| Sujet, title, H1 | Interaction, filtres |
| Contenu essentiel | Comparateurs, simulateurs |
| Identité de l'organisation | Personnalisation |
| Auteur, expertise | Animations |
| Données factuelles, caractéristiques | États d'interface |
| Prix | |
| FAQ | |
| Citations, sources | |
| Liens internes, fil d'Ariane | |
| Données structurées |
Ensuite on agit selon la nature du composant qui est bloqué par du javascript. Si ce composant est essentiel pour la compréhension ou pour la navigation, on intervient pour dupliquer ce qu'il contient dans une version texte accessible. Quand c'est le site tout entier qui est en javascript, la réflexion va plus loin et touche l'architecture en commençant par les gabarits qui sont les plus importants pour le site.
| Peu de pages | Beaucoup de pages | |
|---|---|---|
| Peu de contenu dépendant | Composant isolé → SSR du composant | Composant transversal → gabarit |
| Beaucoup de contenu dépendant | Quelques gabarits → SSR ciblé | Site en CSR → SSR gabarit par gabarit |
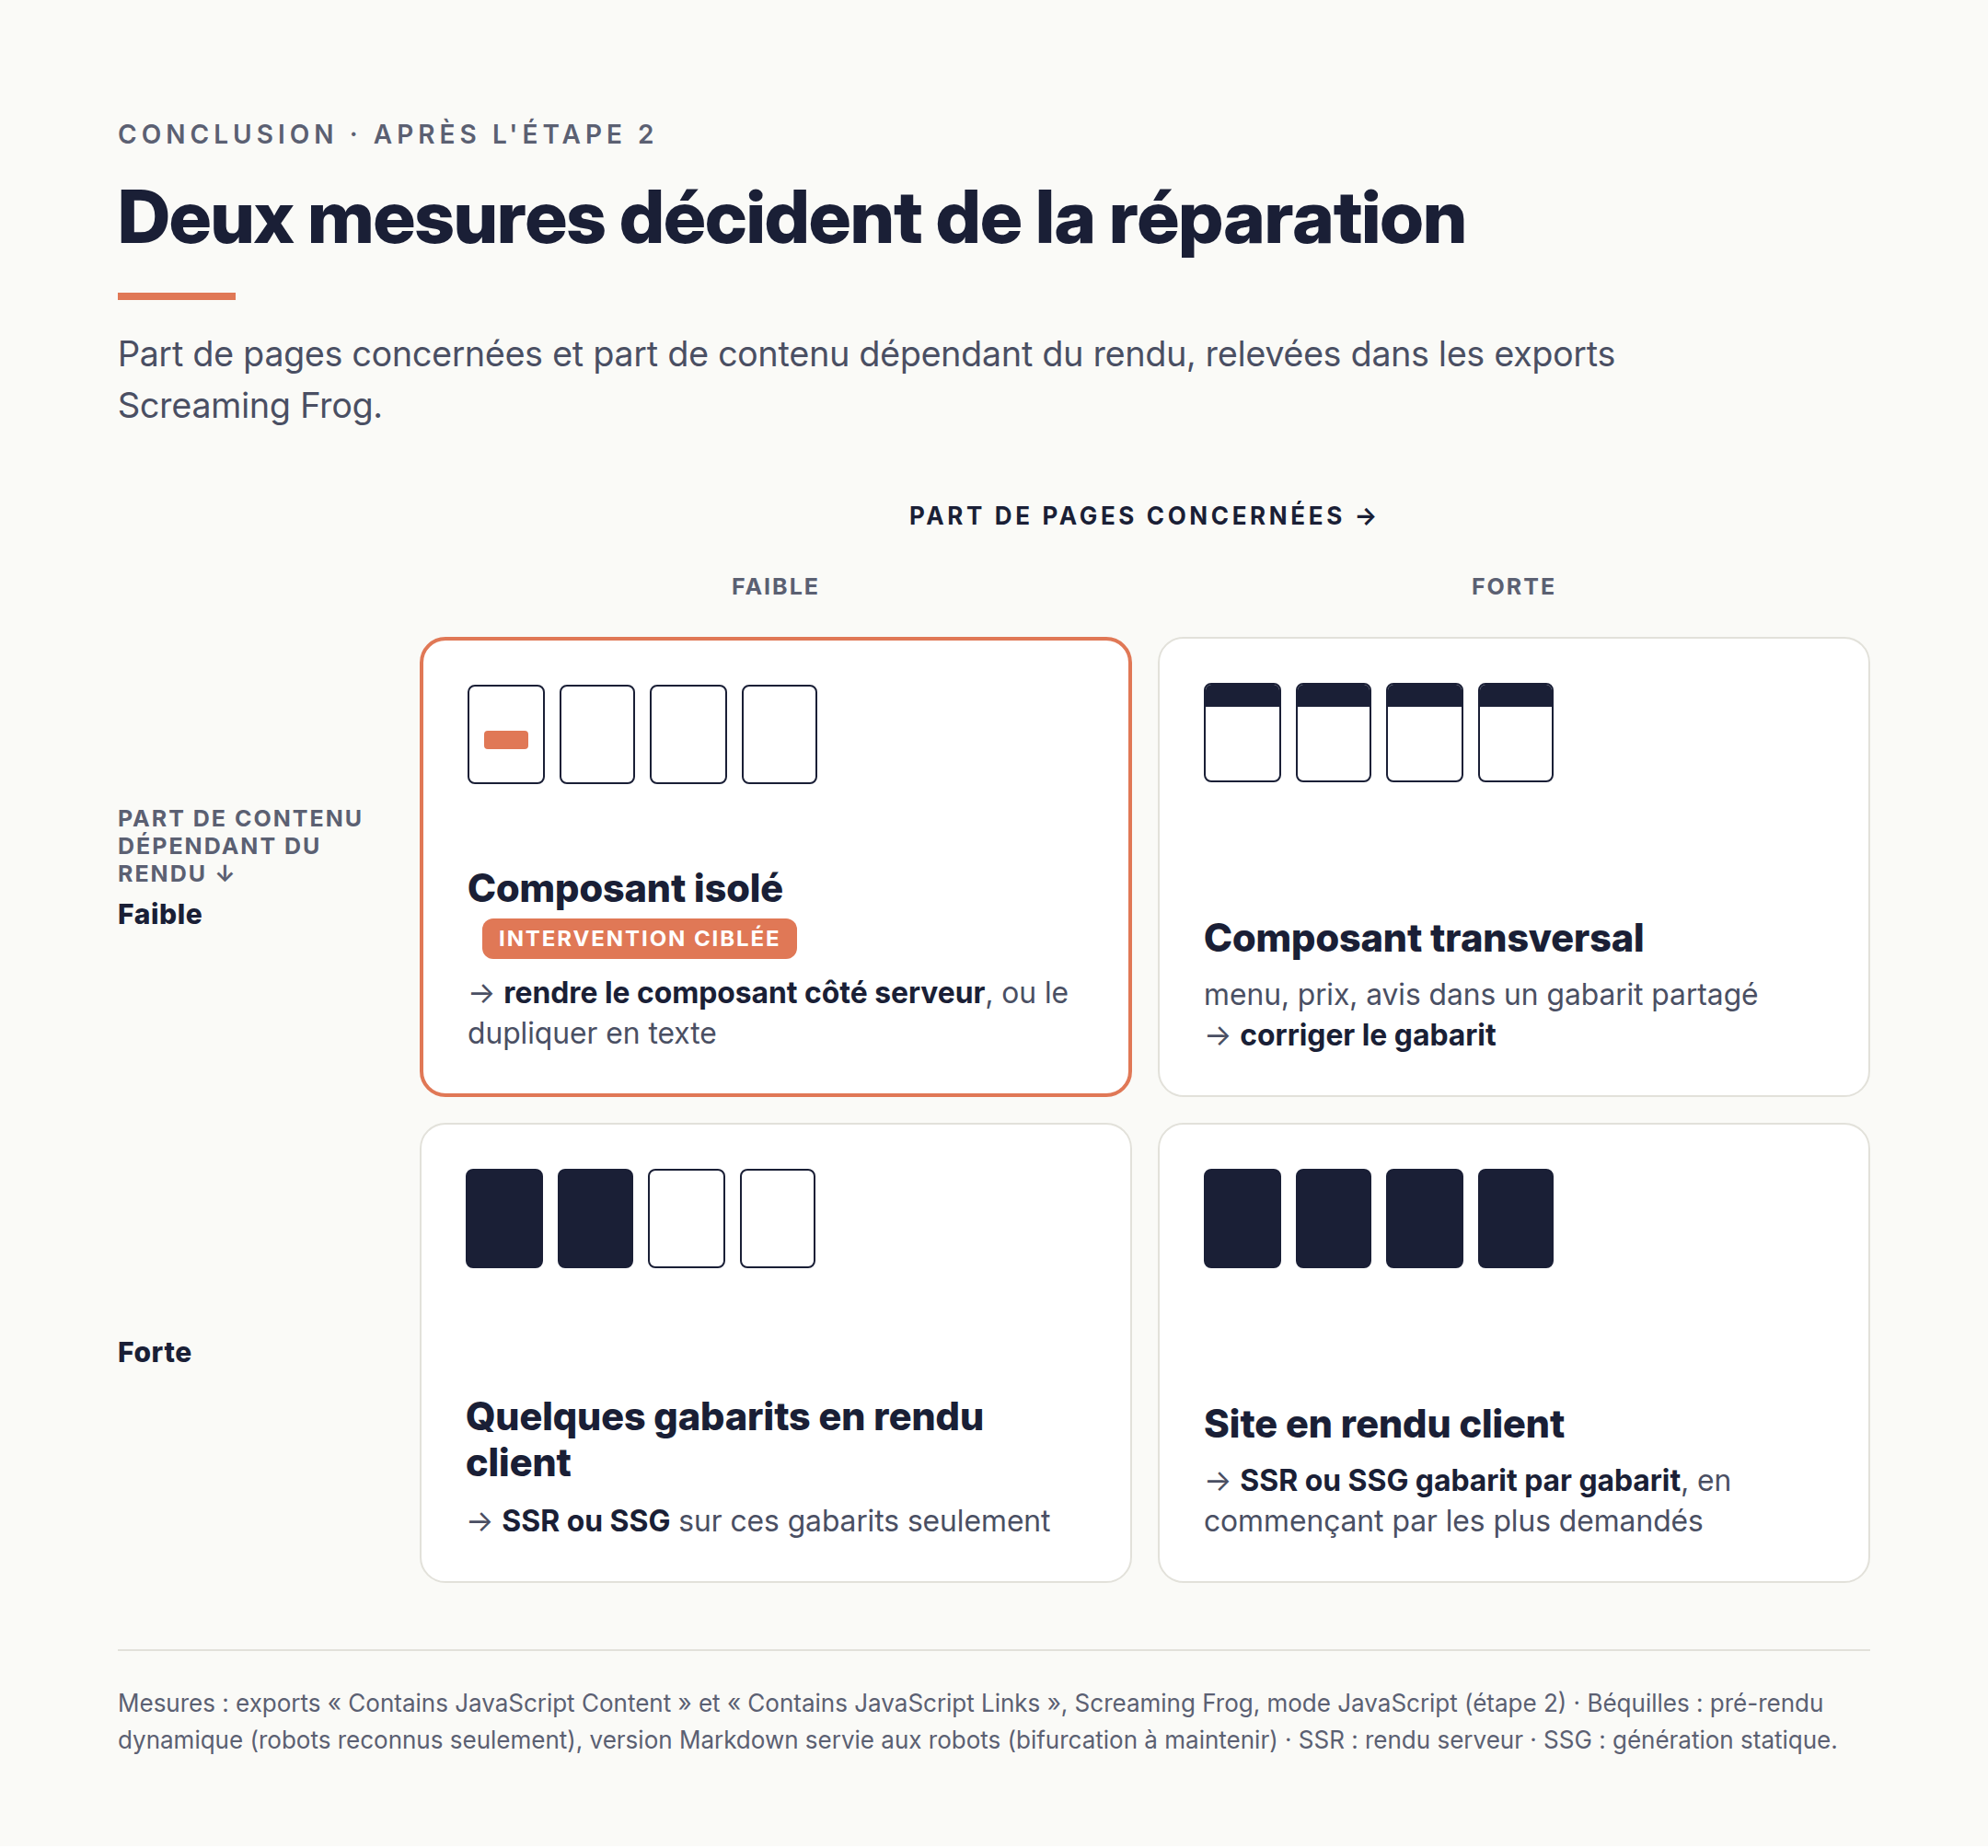
Ces freins, moins fréquents en SEO, doivent s'anticiper davantage en AI Search. La phase d'éligibilité et d'accès aux contenus y est plus difficile. La barrière qui peut bloquer un assistant IA à votre contenu est potentiellement plus grande.
Tous ces sujets doivent donc s'anticiper très rapidement dans l'approche stratégique. Un frein à ce niveau détecté trop tardivement peut avoir un impact lourd sur le reste. Sans oublier que les outils à ce jour qui alertent de ces problèmes ne sont pas systématisés.
Le javascript a été laissé de côté pendant un certain temps où il ne constituait pas un frein majeur au référencement des sites. Avec l'AI Search, le sujet reprend de l'intérêt : ce détail technique tout simple peut faire toute la différence. Ce détail n'est pas visible à l'œil humain et aucun outil officiel ne vous prévient de ce problème. La politique des hébergeurs entre même désormais en ligne de compte.
L'Audit Javascript est clairement un des leviers que vous allez devoir mettre en œuvre dès à présent et Screaming Frog est l'outil que je vous recommande car il vous permettra d'appréhender ce sujet sans que vous soyez un expert technique.