Ce qu'une IA retient vraiment de votre page
Bien se positionner sur Google et être cité sur les moteurs IA sont 2 choses différentes. Nous l'avions vu dans l'analyse des facteurs de citations et le ranking ne détermine pas une mention ou une citation.
Dans mon article précédent, je distinguais 2 mécanismes qui caractérisent les LLM, à savoir la récupération ancrée et la génération probabiliste qui recompose la réponse. J'y indiquais que la récupération se faisait sur des fragments de texte et non des pages entières.
Je propose d'analyser plus en détail cette phase de récupération et de voir comment elle fonctionne en observant le budget de récupération, la sélection des phrases et la dépendance avec la requête initiale.
Le budget de récupération
Quand une IA récupère un contenu sur le web, elle ne le fait pas sur des pages entières. Elle extrait des fragments de textes et cette récupération est limitée par une enveloppe qu'on appelle le budget de récupération.
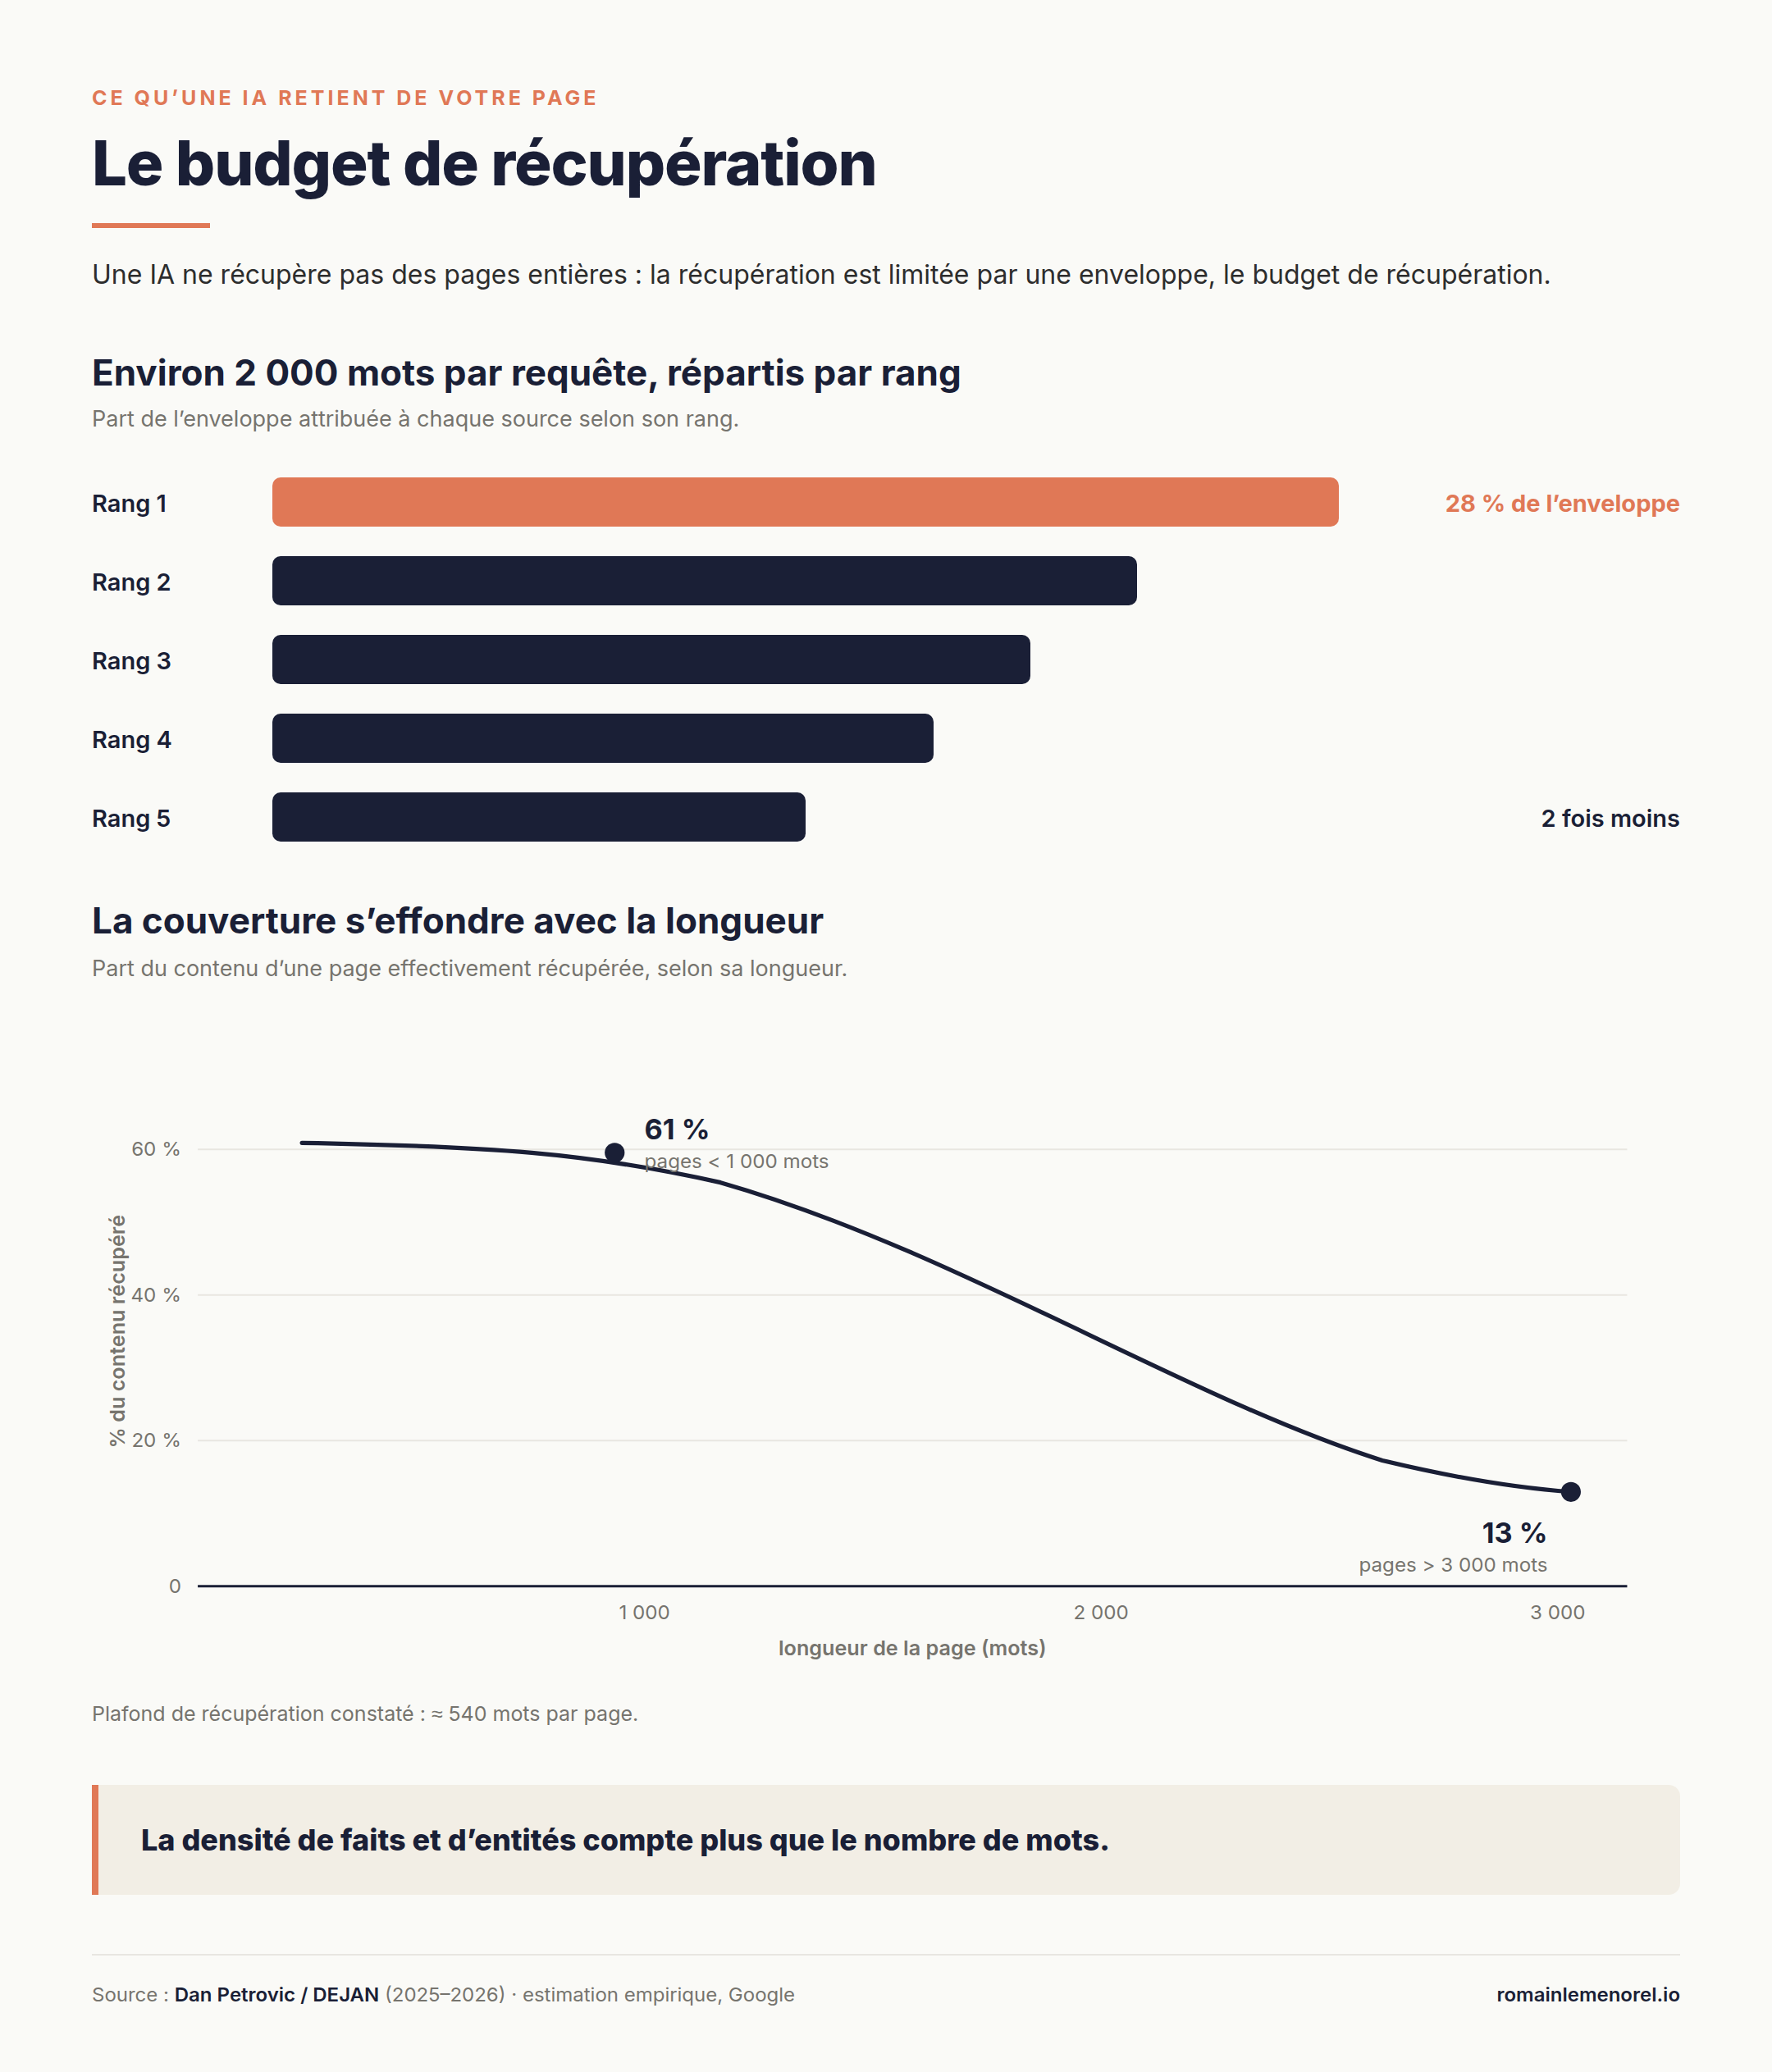
Le budget de récupération serait estimé à 2000 mots répartis selon le ranking
Une mesure effectuée par Dan Petrovic a permis d'aboutir à cette estimation de 2000 mots. Il est parti de 7060 requêtes, 2275 pages et 883 262 extraits collectés.
Pour ancrer une réponse, le volume de mots nécessaire s'est rapproché de 2000 mots et ceci quel que soit le nombre de sources ou la longueur des contenus. L'enveloppe reste la même quelle que soit la densité des pages récupérées et des sources et ceci pose un constat => les sources se partagent les parts de cette enveloppe de 2000 mots.
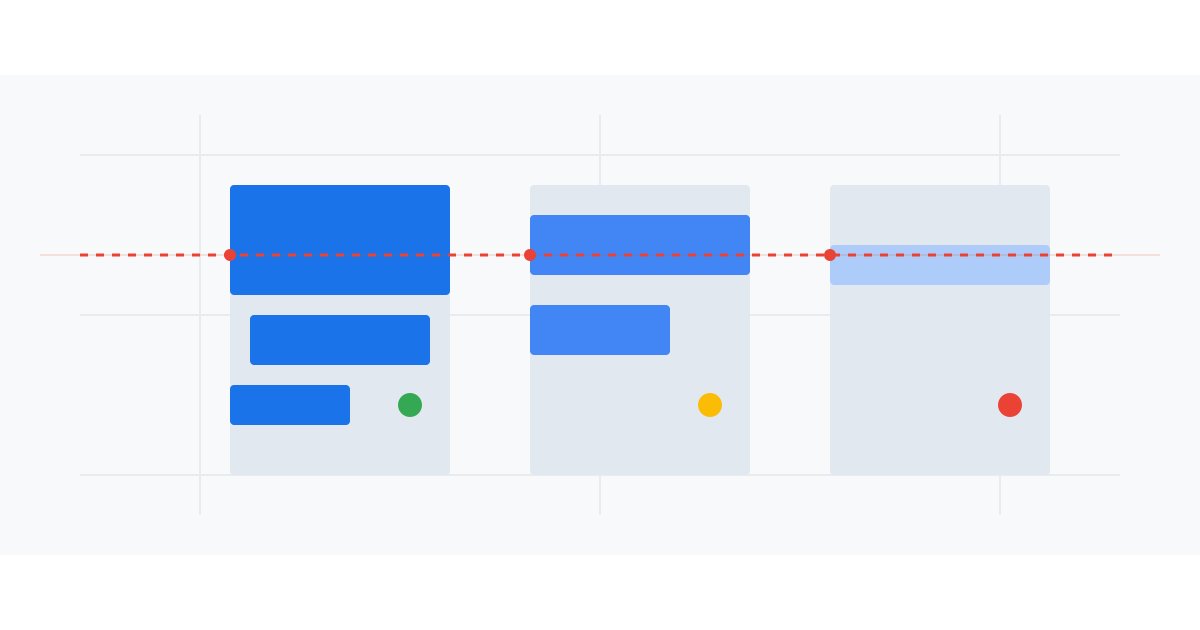
Un autre constat montre que le ranking influence cette part de l'enveloppe où la première source classée reçoit en moyenne 28% de l'enveloppe. La 5ème source quant à elle reçoit 2 fois moins de l'enveloppe.
La longueur de vos contenus ne compte plus
La longueur des contenus n'est donc plus un critère déterminant en AI Search, une page plus longue ne se voit pas attribuer une part plus importante de l'enveloppe. Le plafond de récupération constaté sur cette étude est de 540 mots. Les pages inférieures à 1000 mots voient 61 % de leur contenu récupéré, contre 13 % au-delà de 3000 mots.
La longueur de la page n'accroît donc pas directement la récupération.
En revanche la longueur des textes peut rester un critère de ranking organique qui affectera positivement le budget de récupération.
La sélection des passages
L'extraction se fait sans reformulation
Cette étape de la récupération consiste à découper un contenu en passages. Dan Petrovic a également étudié ce mécanisme en étudiant l'API de grounding de Gemini pour en comprendre le fonctionnement exact.
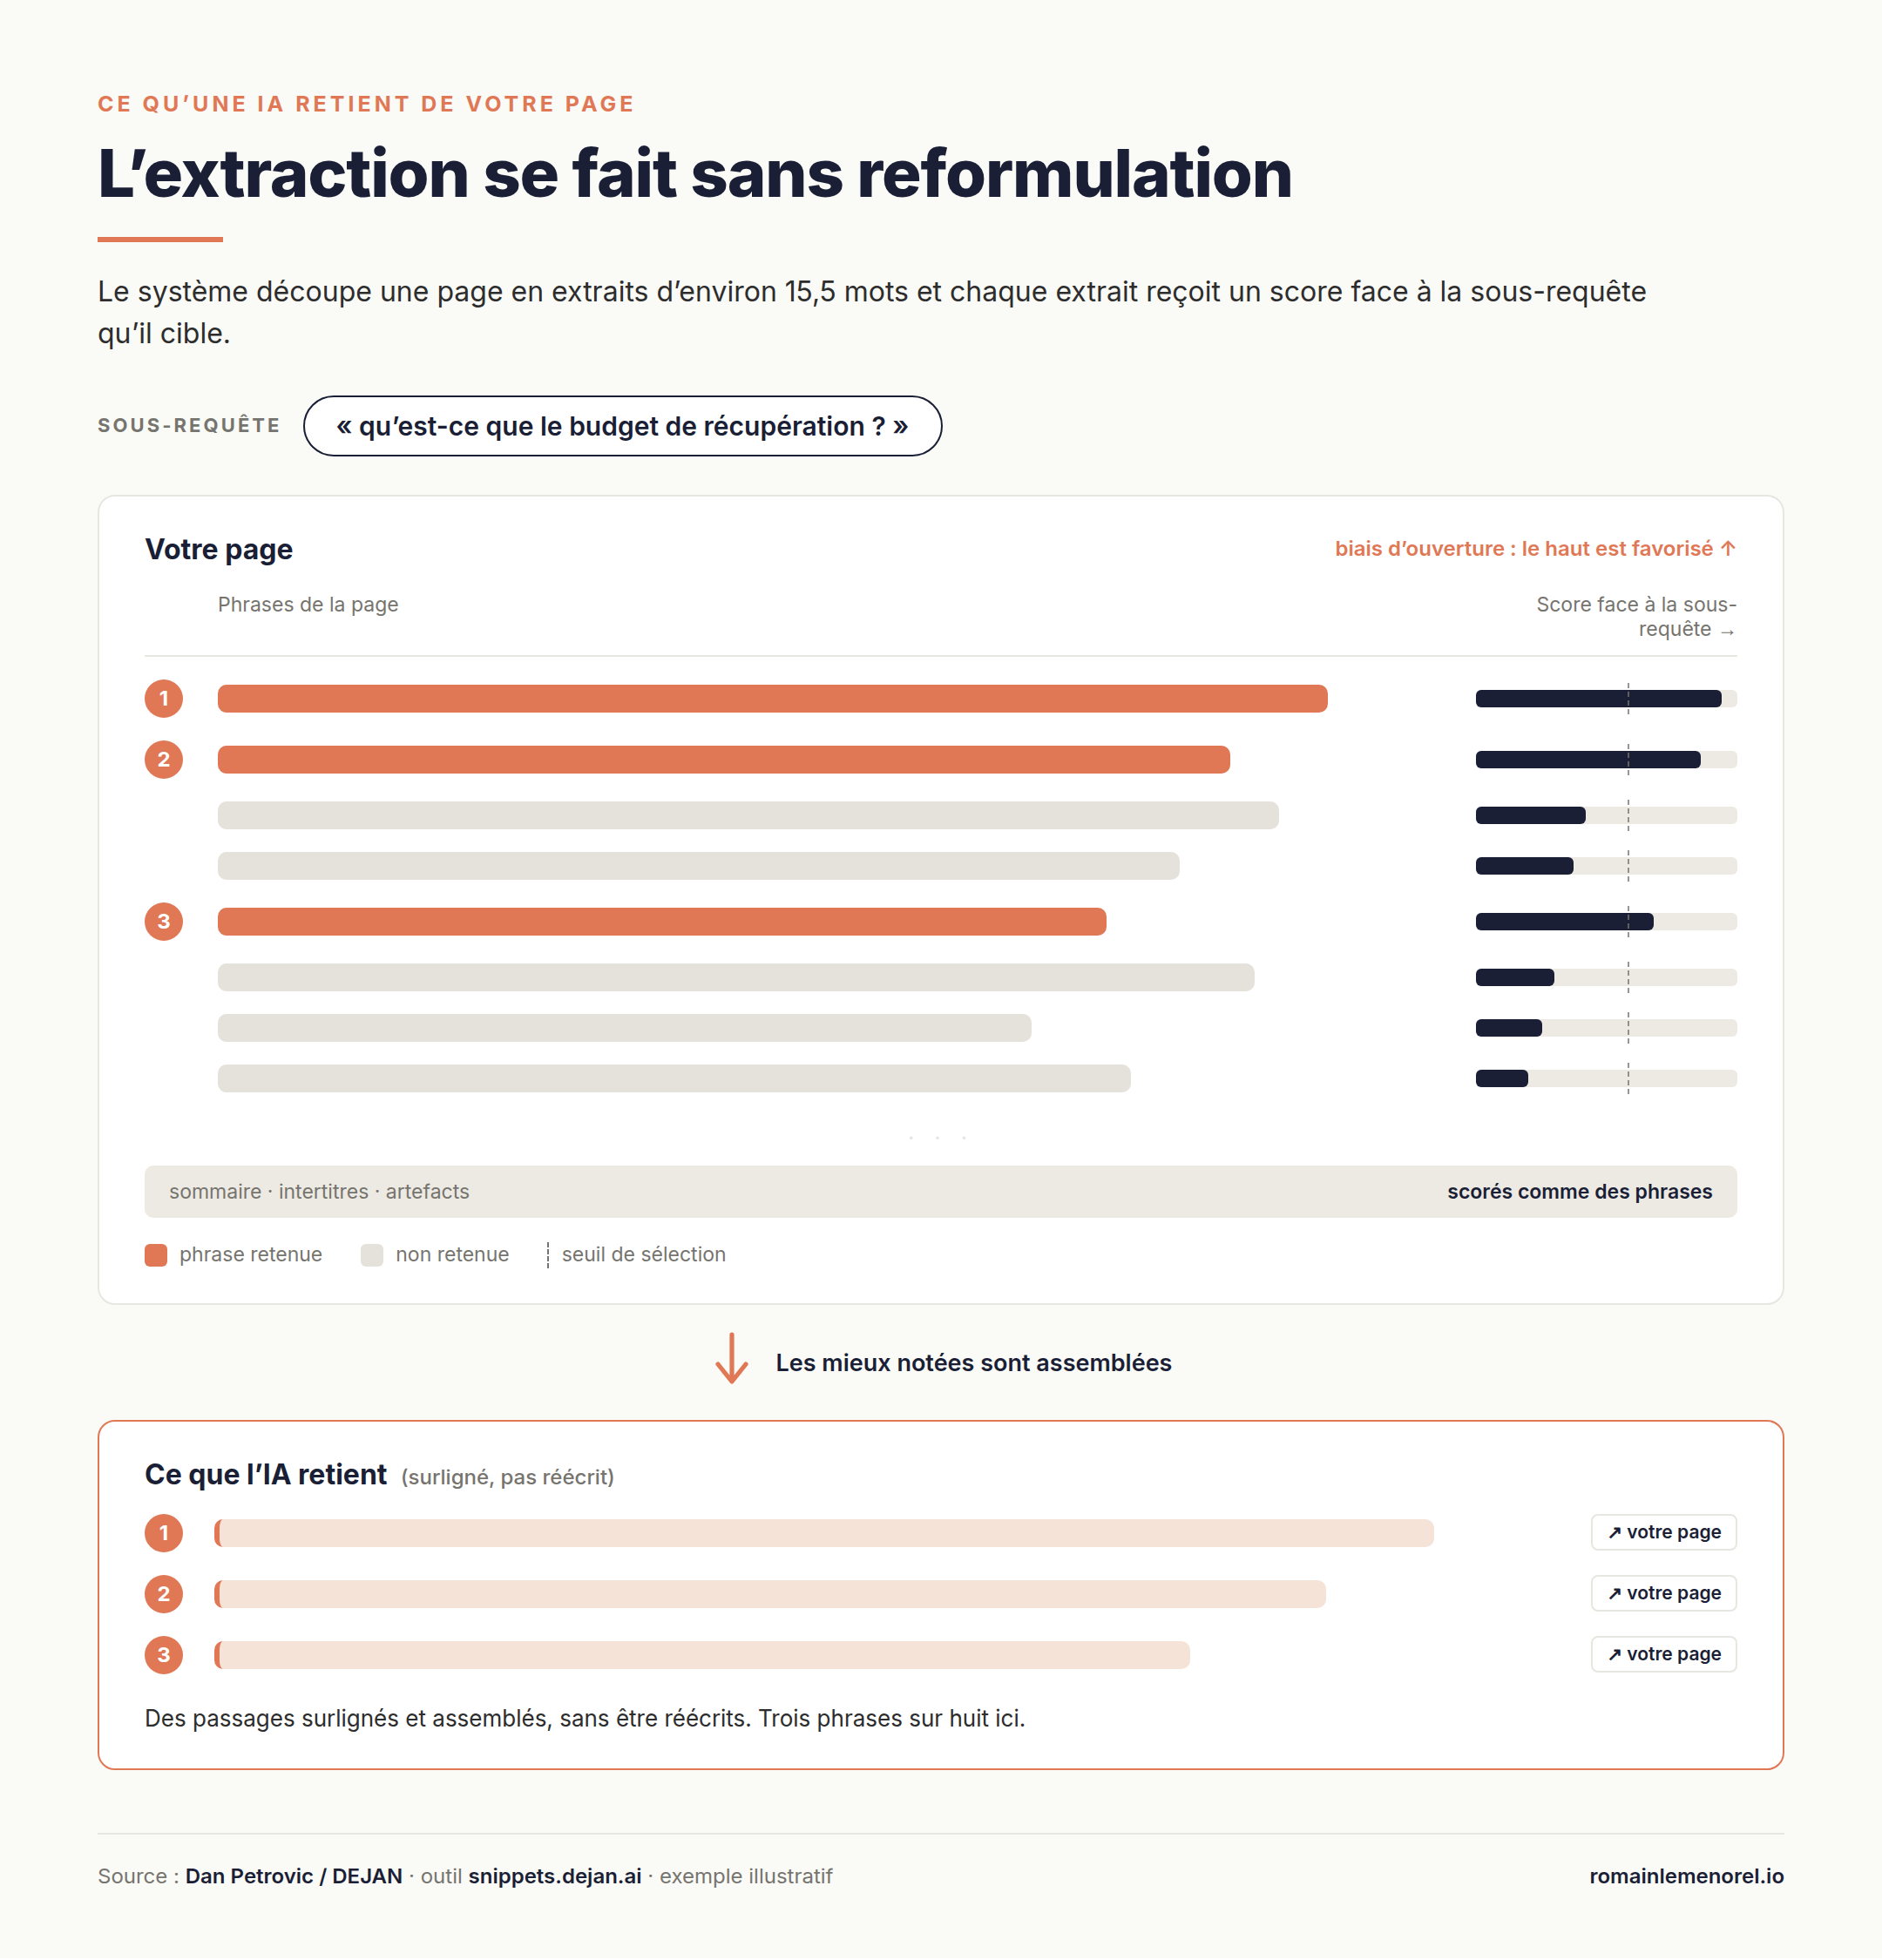
Il en ressort que le système découpe une page en extraits d'environ 15,5 mots en moyenne et chaque extrait se voit attribuer un score face à la sous-requête qu'il cible. Les passages les mieux notés sont assemblés puis surlignés sans être réécrits.
Cette mécanique peut être appuyée par la documentation officielle de Vertex AI Search qui expose son mécanisme aux développeurs.
Le pipeline observé (Gemini, API de grounding)

  prompt utilisateur
        │
        ▼
  1. décomposition en sous-requêtes (fan-out)
        │
        ▼
  2. récupération : 5 à 20 sources par sous-requête
        │
        ▼
  3. extraction : la page est découpée en phrases,
     chaque phrase est scorée contre la sous-requête
        │
        ▼
  4. assemblage des mieux notées (… entre elles)
        │
        ▼
  5. contexte de grounding  →  6. synthèse + attribution
2 autres constats ressortent de cette analyse de Petrovic :
- Le début de votre contenu compte plus que le reste et c'est évidemment un constat qui ne surprend pas, le modèle se comporte comme un le lecteur qui lit avant tout le début du contenu pour évaluer la page dans son ensemble.
- Le second point est que le bruit structurel entre dans le scoring. Chaque éléments de structure non textuel (sommaire, intertitres, artefacts) sont également extrait de la page et non uniquement les caractères textes.
Une page reçue n'est pas nécessairement citée
Selon Petrovic, la récupération fonctionne en 3 étapes où la page est d'abord reçue quand la recherche renvoie l'URL comme source candidate. La page doit ensuite être lue par le modèle pour enfin être citée comme source lors de la réponse.
Il est important de rappeler qu'une page reçue n'est pas nécessairement lue ni même citée par les moteurs. Dan Petrovic fait ce test avec une requête qu'il envoie à plusieurs systèmes IA et il relève les écarts entre pages reçues et pages citées. La variation est forte entre chaque modèle.
| Pipeline (modèle testé) | Pages reçues | Pages citées | Profil |
|---|---|---|---|
| Google (gemini-3.5-flash) | 7 | 7 | 100% de citations |
| OpenAI (gpt-5.5) | 39 (37 lisibles) | 2 | forte récupération mais faible citation |
| Anthropic (claude-opus-4-8) | 14 | 9 | lecture en profondeur avec quelques rejets |
Le comportement de récupération d'un modèle à l'autre varie beaucoup et une page reçue par le modèle peut ne pas finir citée dans la réponse envoyée à l'utilisateur.
La requête de l'utilisateur influence le comportement de récupération
Selon que l'utilisateur pose une question précise ou très générale, le moteur ne va pas chercher la réponse au même endroit sur la page.
Petrovic y a effectué un test sur une page construite avec 2 sections, l'une qui propose le détail du contenu (~80 %) et une autre sur les conseils généraux (~20 %)
Sur 7 questions dont une très spécifique, on constate que seule la question spécifique va chercher la réponse dans le cœur détaillé du contenu.
Une page, sept requêtes (démonstration Petrovic, déc. 2025)

  ┌────────────────────────────────────────────┐
  │  zone A · cœur détaillé (~80 % du contenu) │ ◄── 1 requête,
  │  4 tisanes, posologies, interactions       │     la plus spécifique
  ├────────────────────────────────────────────┤
  │  zone B · conseils généraux (~20 %)        │ ◄── 6 requêtes
  └────────────────────────────────────────────┘     génériques
  la requête « à éviter » ne sont pas récupérer sur des questions qui n'appelle pas du négatif
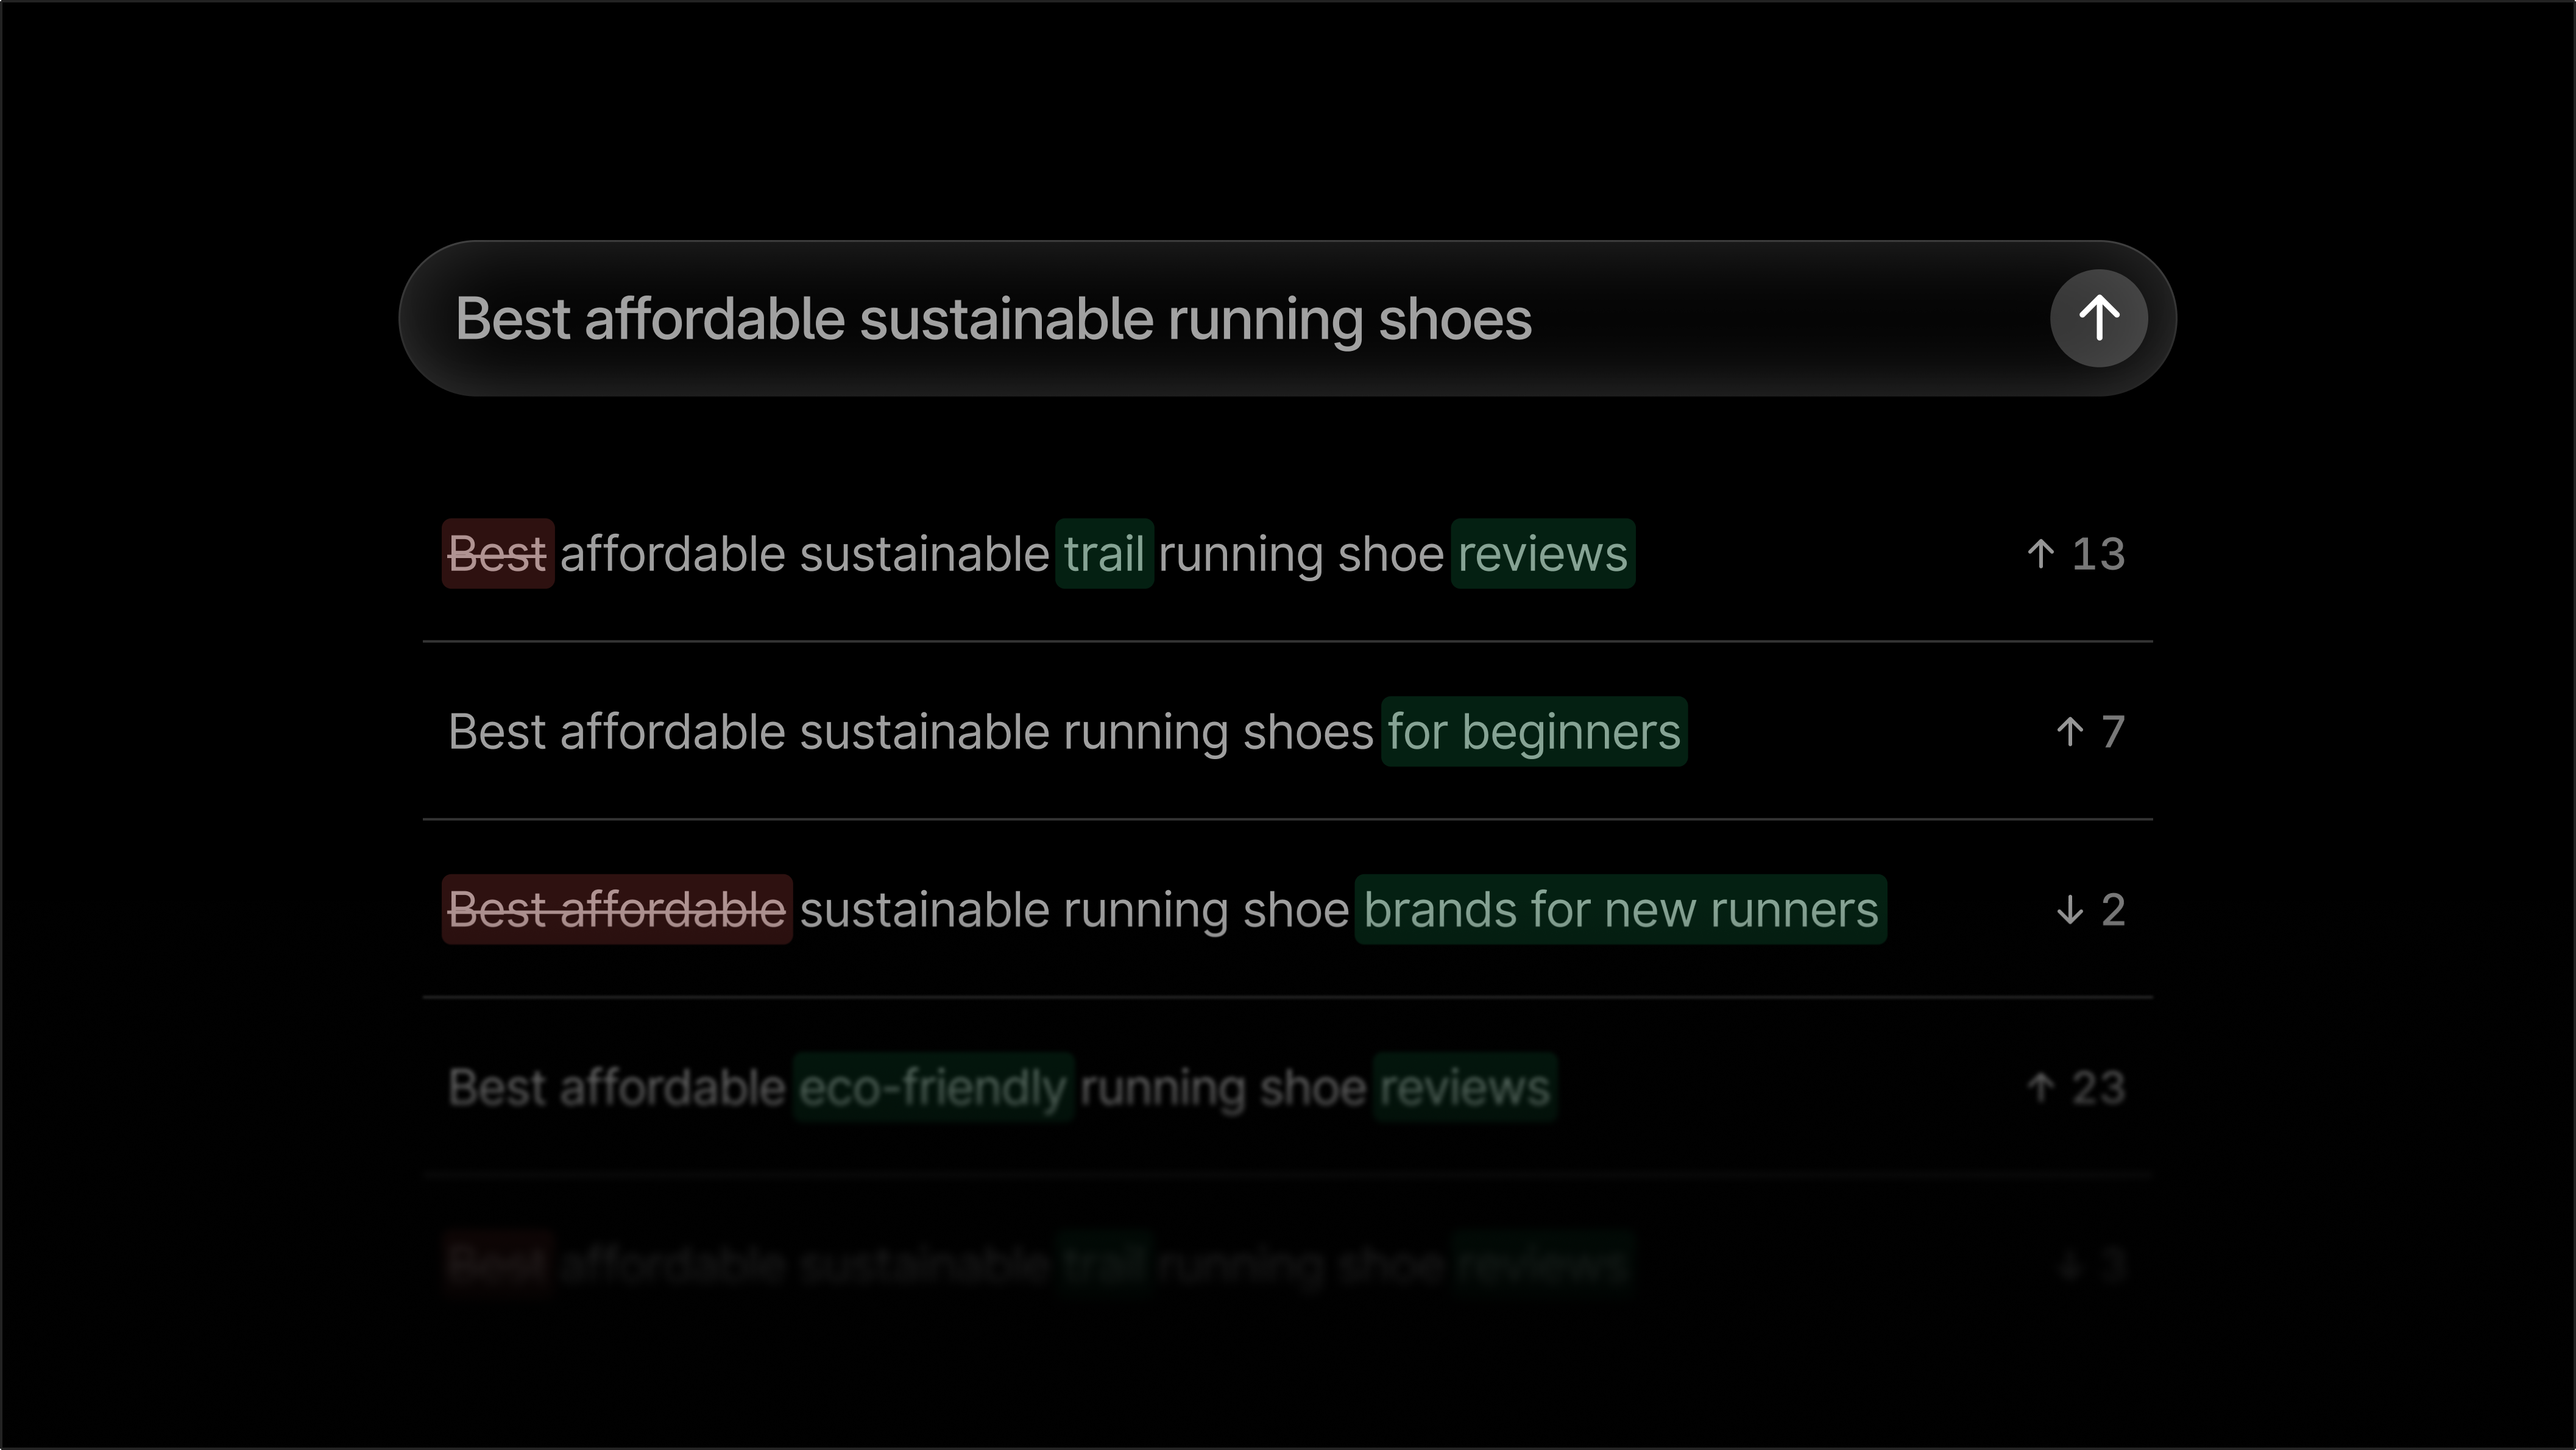
Les Query fan out font plus de 7 mots
Une autre étude s'intéresse cette fois aux Query fan out et à leur longueur moyenne. Selon Petrovic, sur 365 920 fan out capturées chez Google et OpenAI, 71% des fan out font plus de 7 mots et celles faisant moins de 4 mots ne pèsent que 4%.
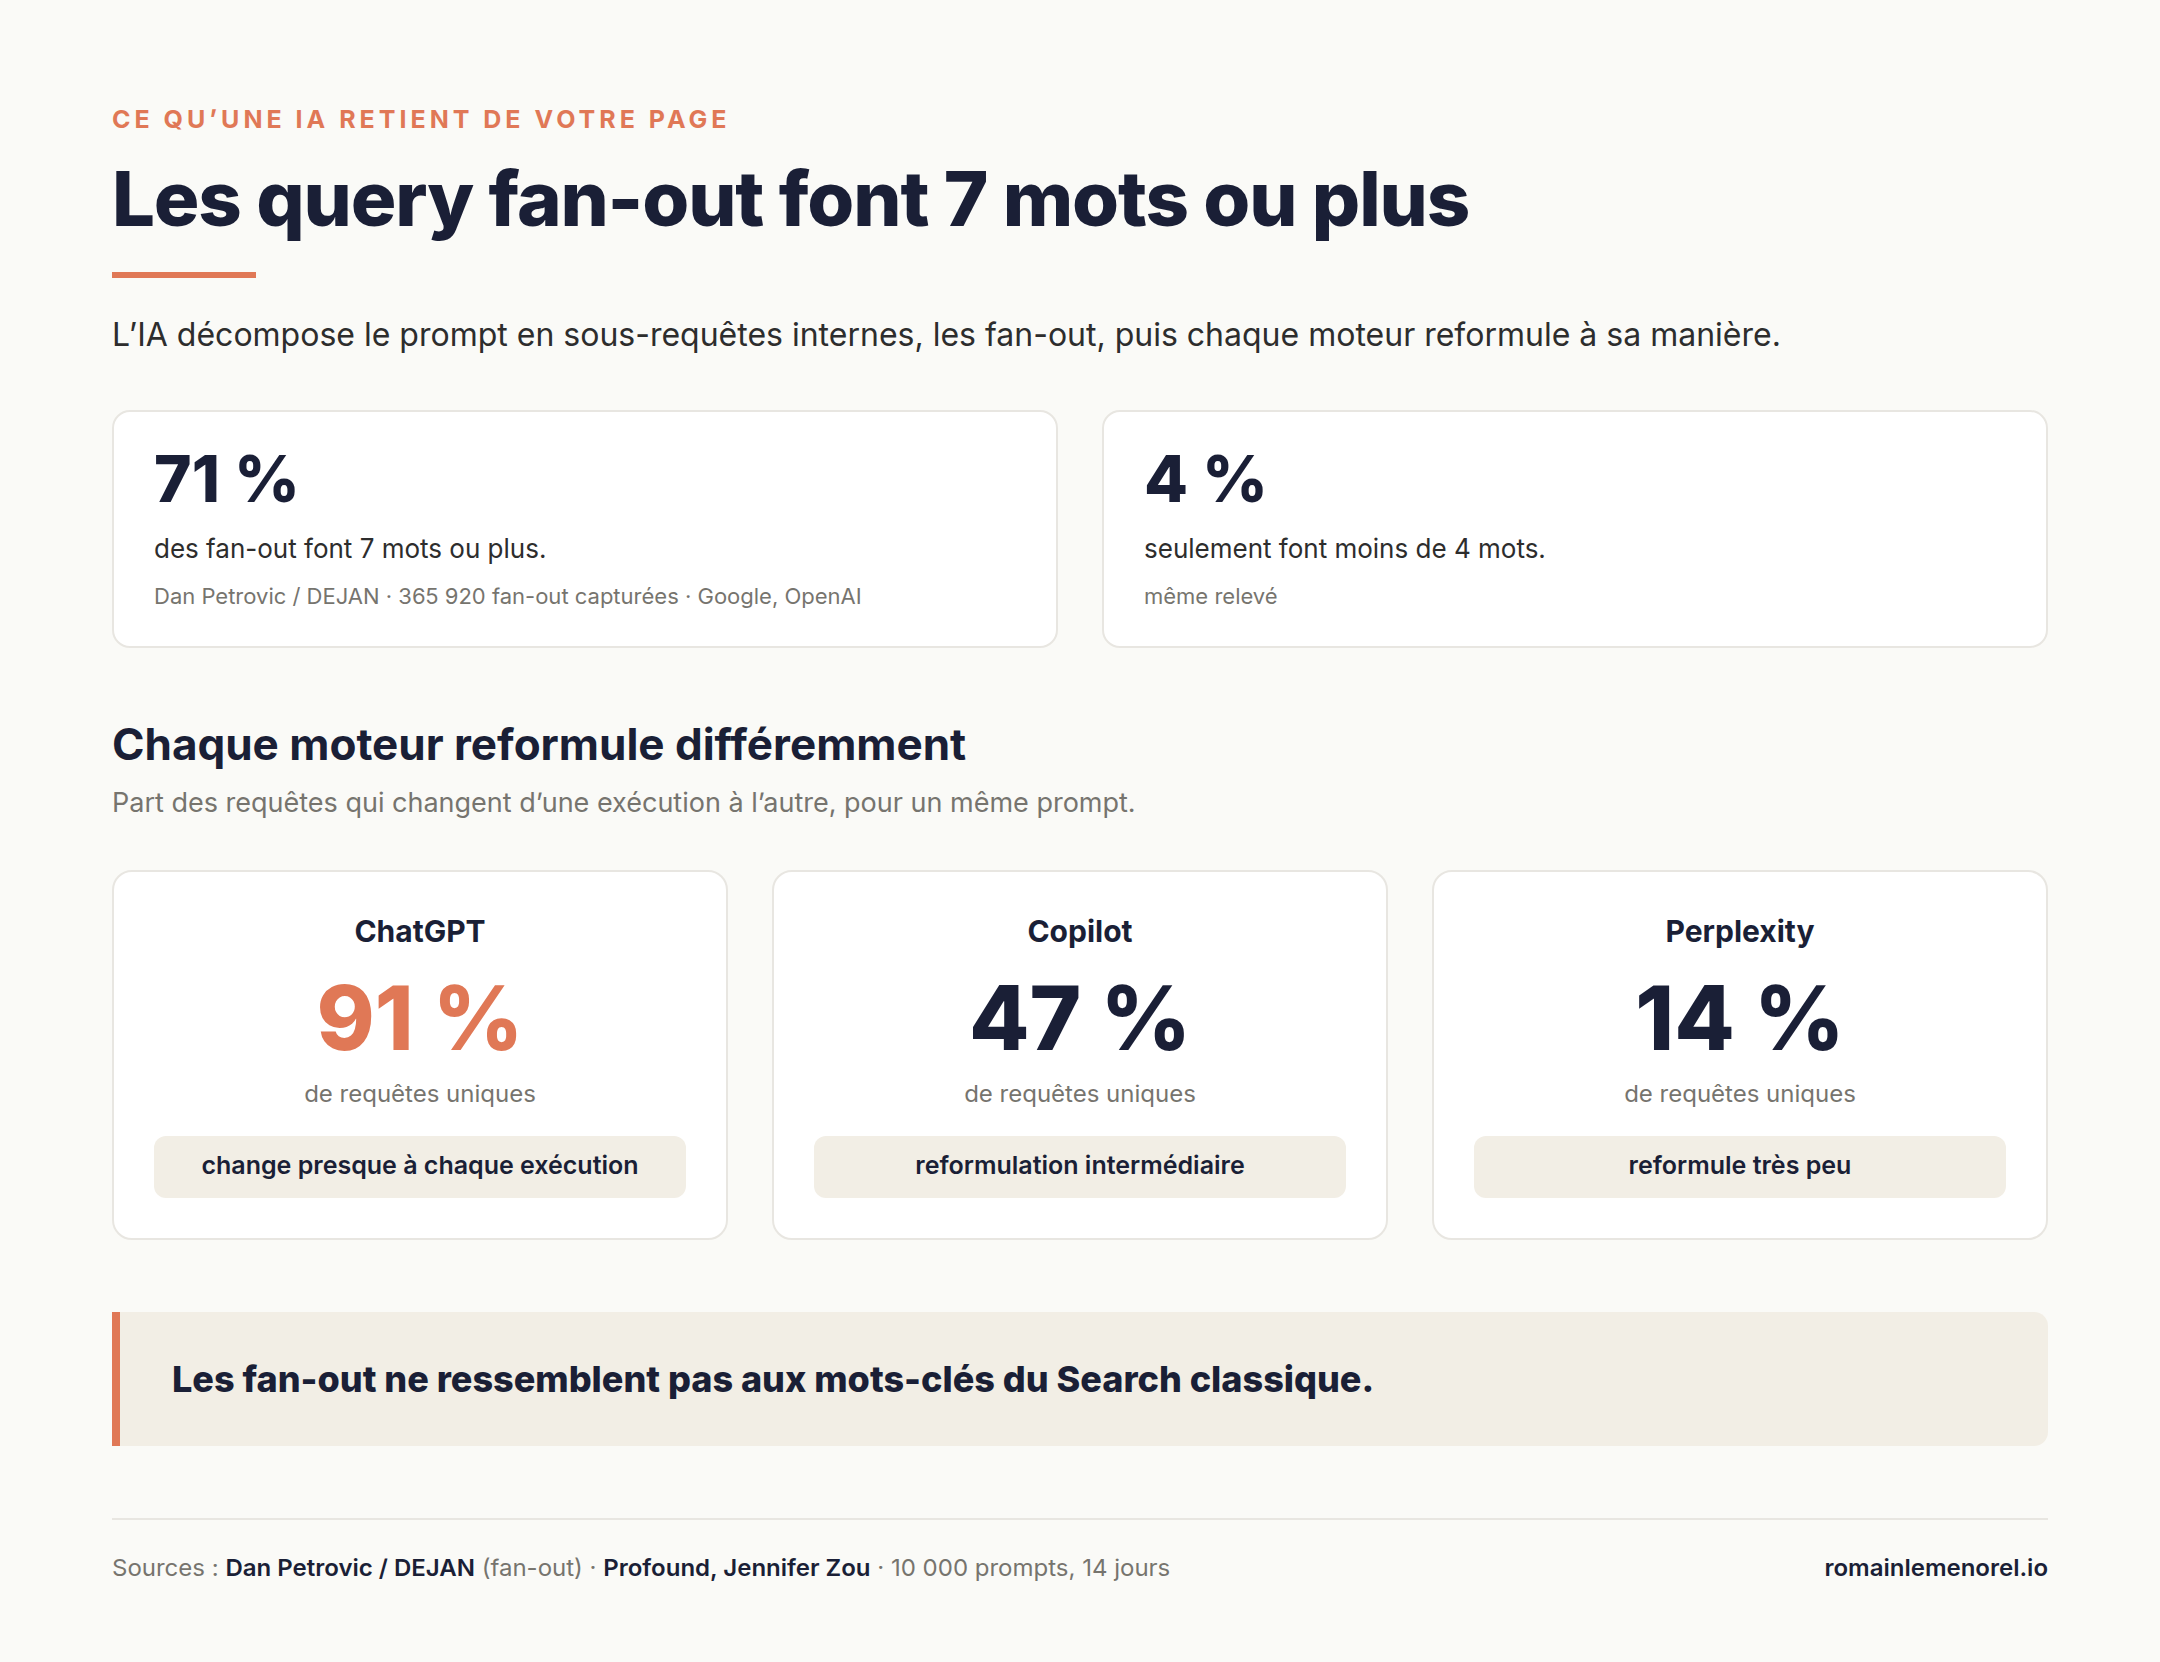
Les fan out ne ressemblent donc pas aux mots-clés que l'on analyse en Search classique
Chaque système IA reformule le prompt différemment et une étude de Profound sur 10 000 prompts pendant 14 jours l'a démontré avec 91% de requêtes ChatGPT qui changent d'une exécution à une autre. Chez Copilot on tombe à 47% et 14% pour Perplexity qui reformule très peu.
Comment écrire son contenu pour être mieux récupéré ?
Après ces analyses qui permettent de mieux comprendre comment le processus de récupération fonctionne mécaniquement. On peut en venir aux bonnes pratiques pour rédiger un contenu qui maximise les chances d'être récupéré et cité par un modèle.
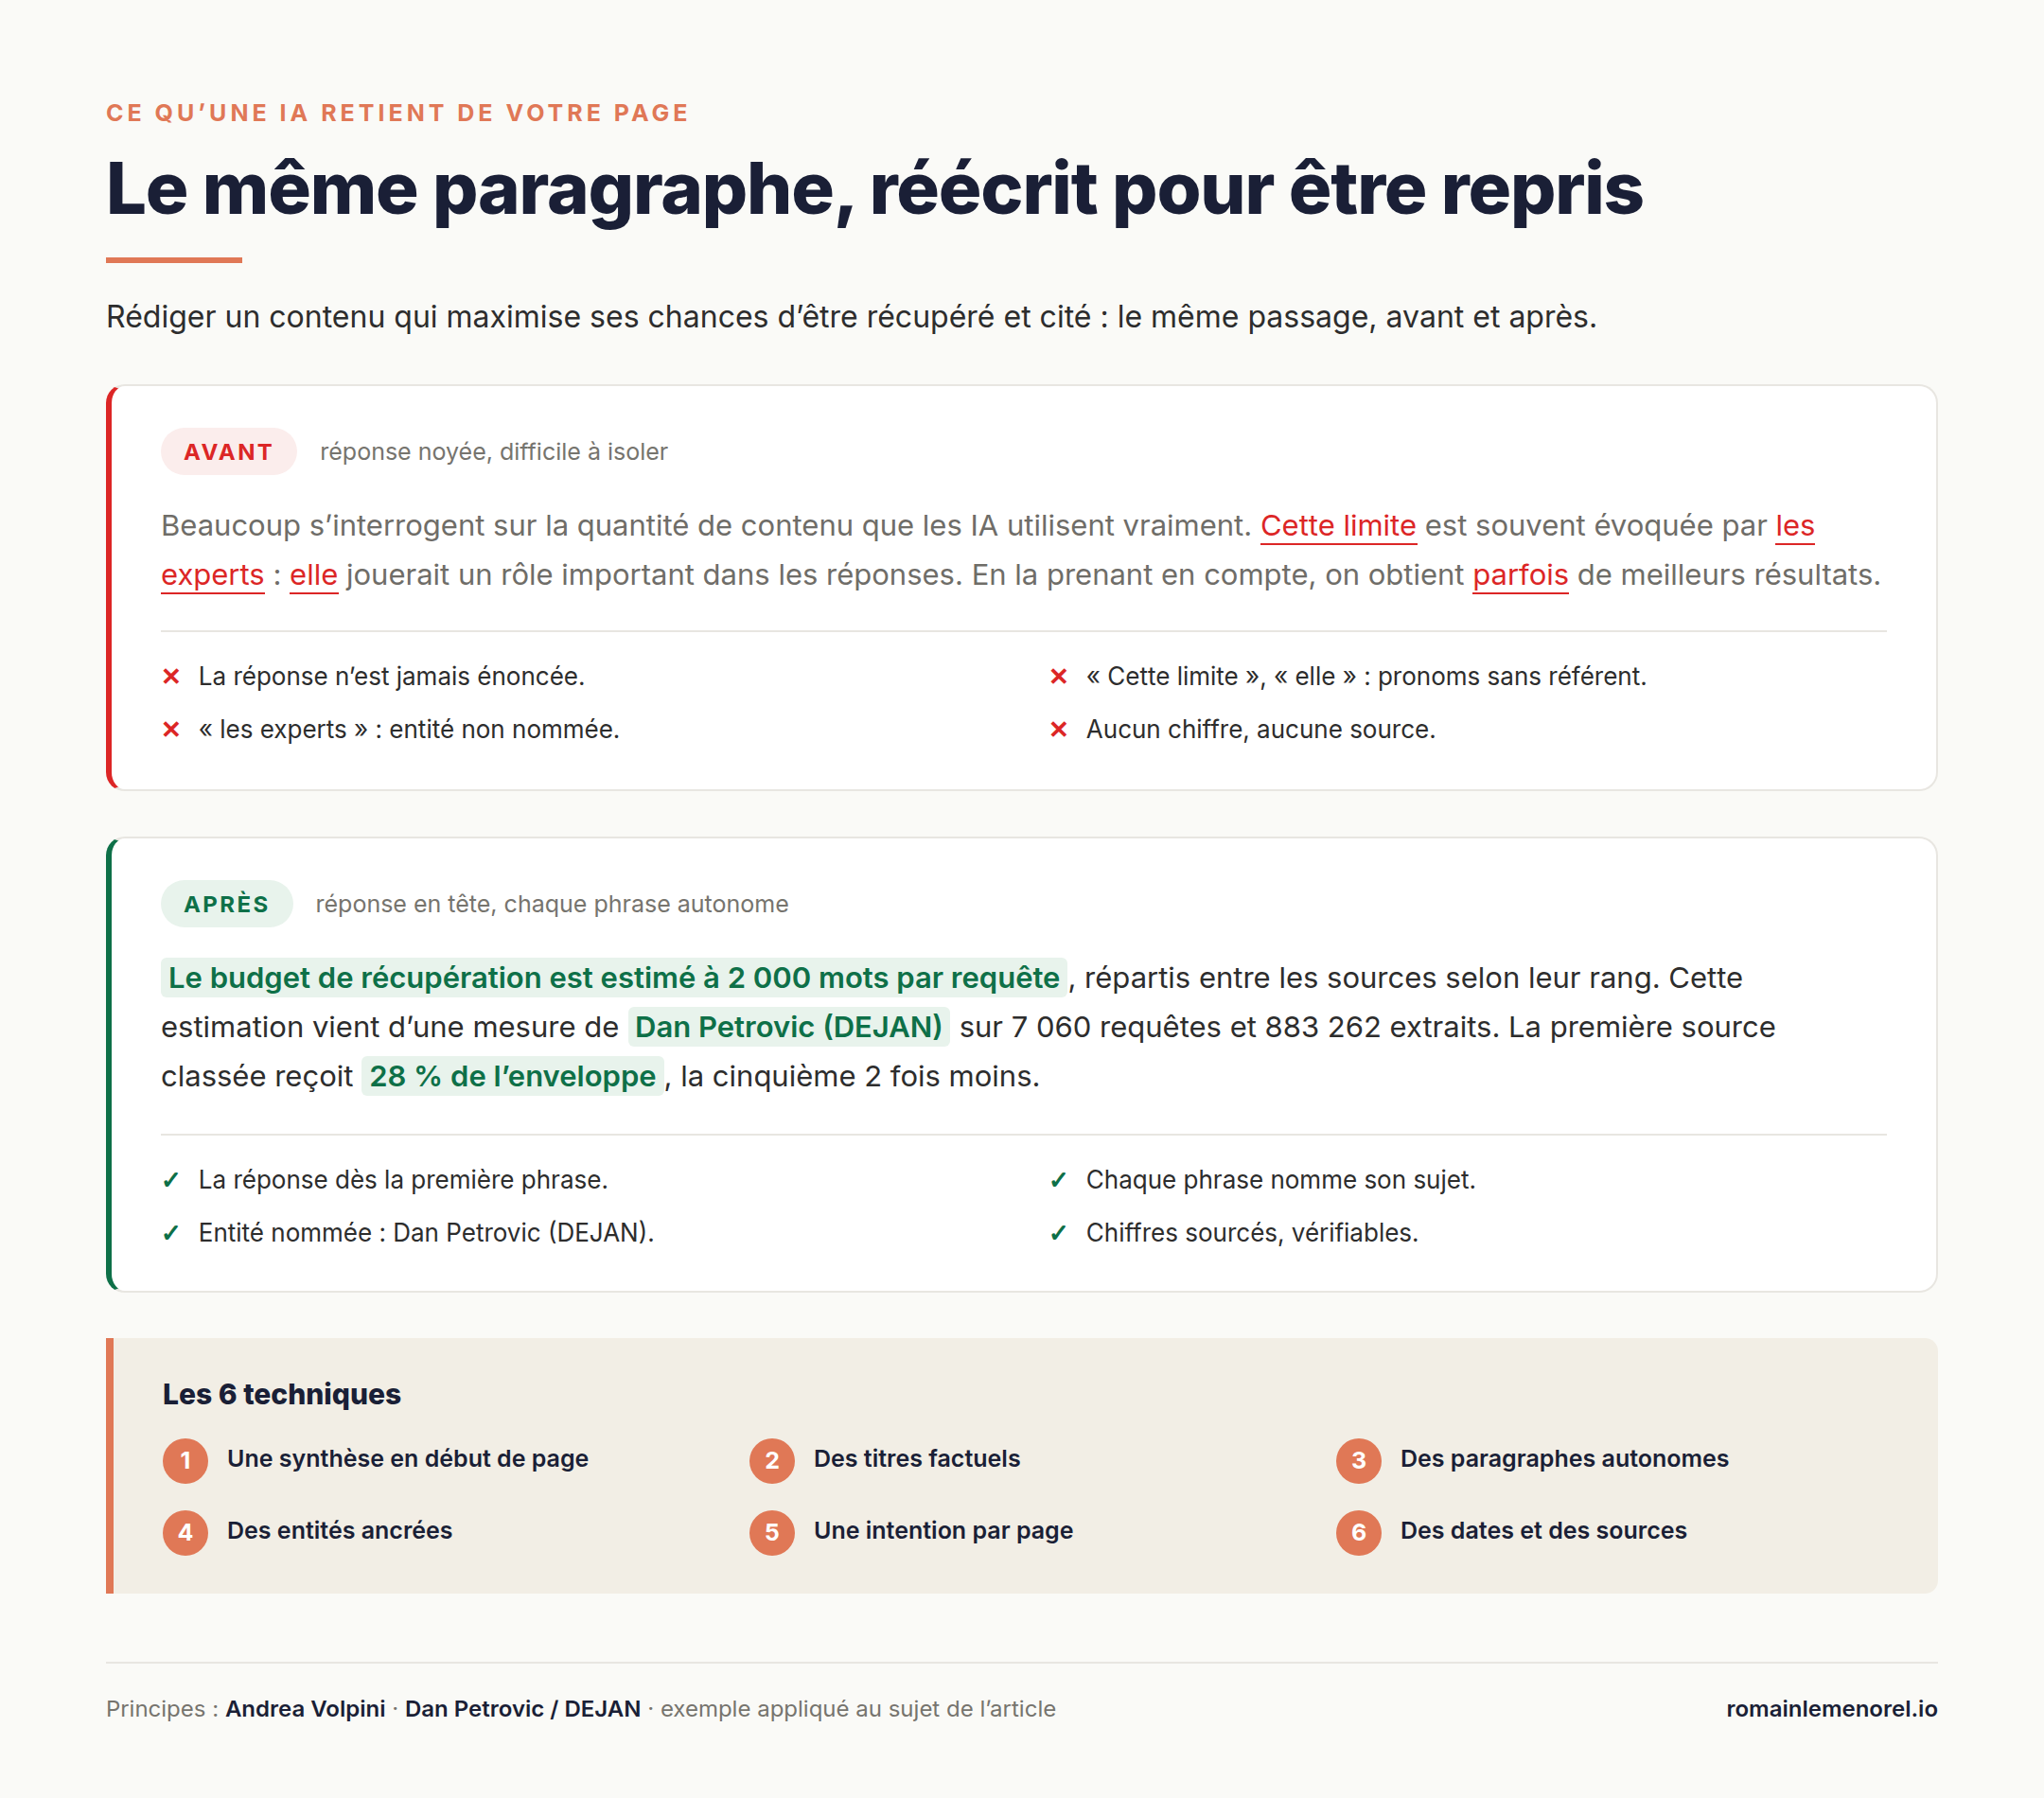
6 techniques indispensables :
- Proposer une synthèse en début de page :
Le début d'une page est la zone la plus lue par l'utilisateur et le modèle, c'est celle-ci qui annonce l'essentiel de ce que propose une page. C'est la section qui doit être le mieux travaillée selon vos requêtes ciblées.
Un résumé exécutif peut donc être un format de premier choix pour vos pages - Des titres de sections factuels
Il faut éviter les titres rhétoriques qui ont peu de sens sortis de leur contexte. La structure Hn de vos contenus doit tout dire. C'est la bonne pratique SEO que vous appliquez aussi en AI Search - Des paragraphes qui doivent être autonomes
Ce que dit un paragraphe doit tenir sur l'ensemble du paragraphe sans qu'il y ait de dépendance forte avec le reste du contenu. Sans cette règle les passages extraits par les modèles risquent d'être rejetés car ils ne seront pas réutilisables. - Des entités bien ancrées dans le contenu
Les entités explicitement nommées dans le contenu doivent être reconnaissables. Il faut donc privilégier des phrases qui appellent clairement les attributs qui décrivent un concept ou une entité. - Une intention claire pour chaque page
Chaque page traite d'un sujet spécifique et ce sujet est clairement mis en avant dans le titre et le début du contenu. - Des dates et des sources clairement mises en avant
Les dates et les sources donnent un appui sur la pertinence des contenus. Ce sont les critères EEAT qui favorisent la récupération.
Structurer un contenu sans le réécrire suffit à améliorer la similarité
Un test de Mike King a démontré que structurer un contenu sans réécrire le moindre mot suffit à rapprocher la similarité sémantique entre une requête et un passage. L'ajout d'intertitres peut l'augmenter encore plus.
Structurer aide la lecture de l'utilisateur et du moteur et cela favorise indirectement la récupération de vos contenus qui seront plus proches des requêtes ciblées par la page.
Ce que la recherche académique dit sur la récupération
La recherche académique relue par les pairs a proposé de nombreuses études en 2025 et 2026 et 3 d'entre elles méritent une attention sur ce sujet de la récupération.
Le paper fondateur Aggarwal et al. de 2024 qui étudie des réponses générées à partir de 5 sources concurrentes. Le principe était simple et une des sources bénéficiait ensuite d'une optimisation et celle-ci annonçait 30% à 40% de visibilité en plus face aux sources concurrentes.
Un recalcul a été proposé en juillet 2026 par Martinez. Les 5 sources d'une réponse se partagent un total fixe et la source qui bénéficie de l'optimisation prend donc une part plus importante du total qui ne bouge pas.
La métrique du paper fondateur somme à 1 (recalcul Martinez, juillet 2026)

  part de la réponse attribuée à chaque source

  avant  ┌──────┬──────┬────┬──────┬──────┐
         │  A   │  B   │ C  │  D   │  E   │
         └──────┴──────┴────┴──────┴──────┘
  après  ┌────┬─────┬────────┬─────┬─────┐
         │ A  │  B  │   C ▲  │  D  │  E  │
         └────┴─────┴────────┴─────┴─────┘
  C monte, les autres reculent, le total ne bouge pas :
  le « +30 à 40 % » mesure un déplacement de parts.
Une 2ème étude de Puerto et al. (NeurIPS 2025) vient contredire ce que la méthodologie recommande. Cette étude croise des méthodes d'optimisation avec des familles de requêtes et le résultat est qu'une majorité de ces croisements ne produisent pas de gains significatifs. Il en ressort que l'optimisation sans toucher le fond de la page n'apporte pas de gain
Une 3ème étude Wu et al publiée en 2026 s'intéresse aux résultats obtenus selon l'état initial de la page au départ.
Une page mal structurée dans un premier cas gagne avec une optimisation quand la seconde déjà calibrée pour la lecture machine perd quand on tente une réécriture similaire.
L'effet de régime

  départ : vraie page web,          départ : page de jeu d'essai,
  incomplète ou mal structurée      déjà calibrée pour la machine
        │  réécriture guidée              │  même réécriture
        ▼                                 ▼
  visibilité mesurée en hausse      sous la ligne de base : moins bien
  dans les réponses                 que la page laissée telle quelle
Il faut donc nuancer l'usage des méthodes d'optimisation avec le fond de votre contenu et l'état dans lequel il est proposé. L'optimisation faite uniquement sur la forme ne suffit pas à assurer une amélioration des performances. La forme du contenu ne doit donc pas être la seule préoccupation. Ses performances actuelles et son fond doivent entrer dans la mesure avant d'engager une réécriture.
Une page doit être récupérable
Le processus de récupération est exigeant mais aussi très rapide et une page candidate à une récupération doit donc répondre rapidement afin d'être retenue.
On parle ici de l'éligibilité d'une page qui précède le classement.
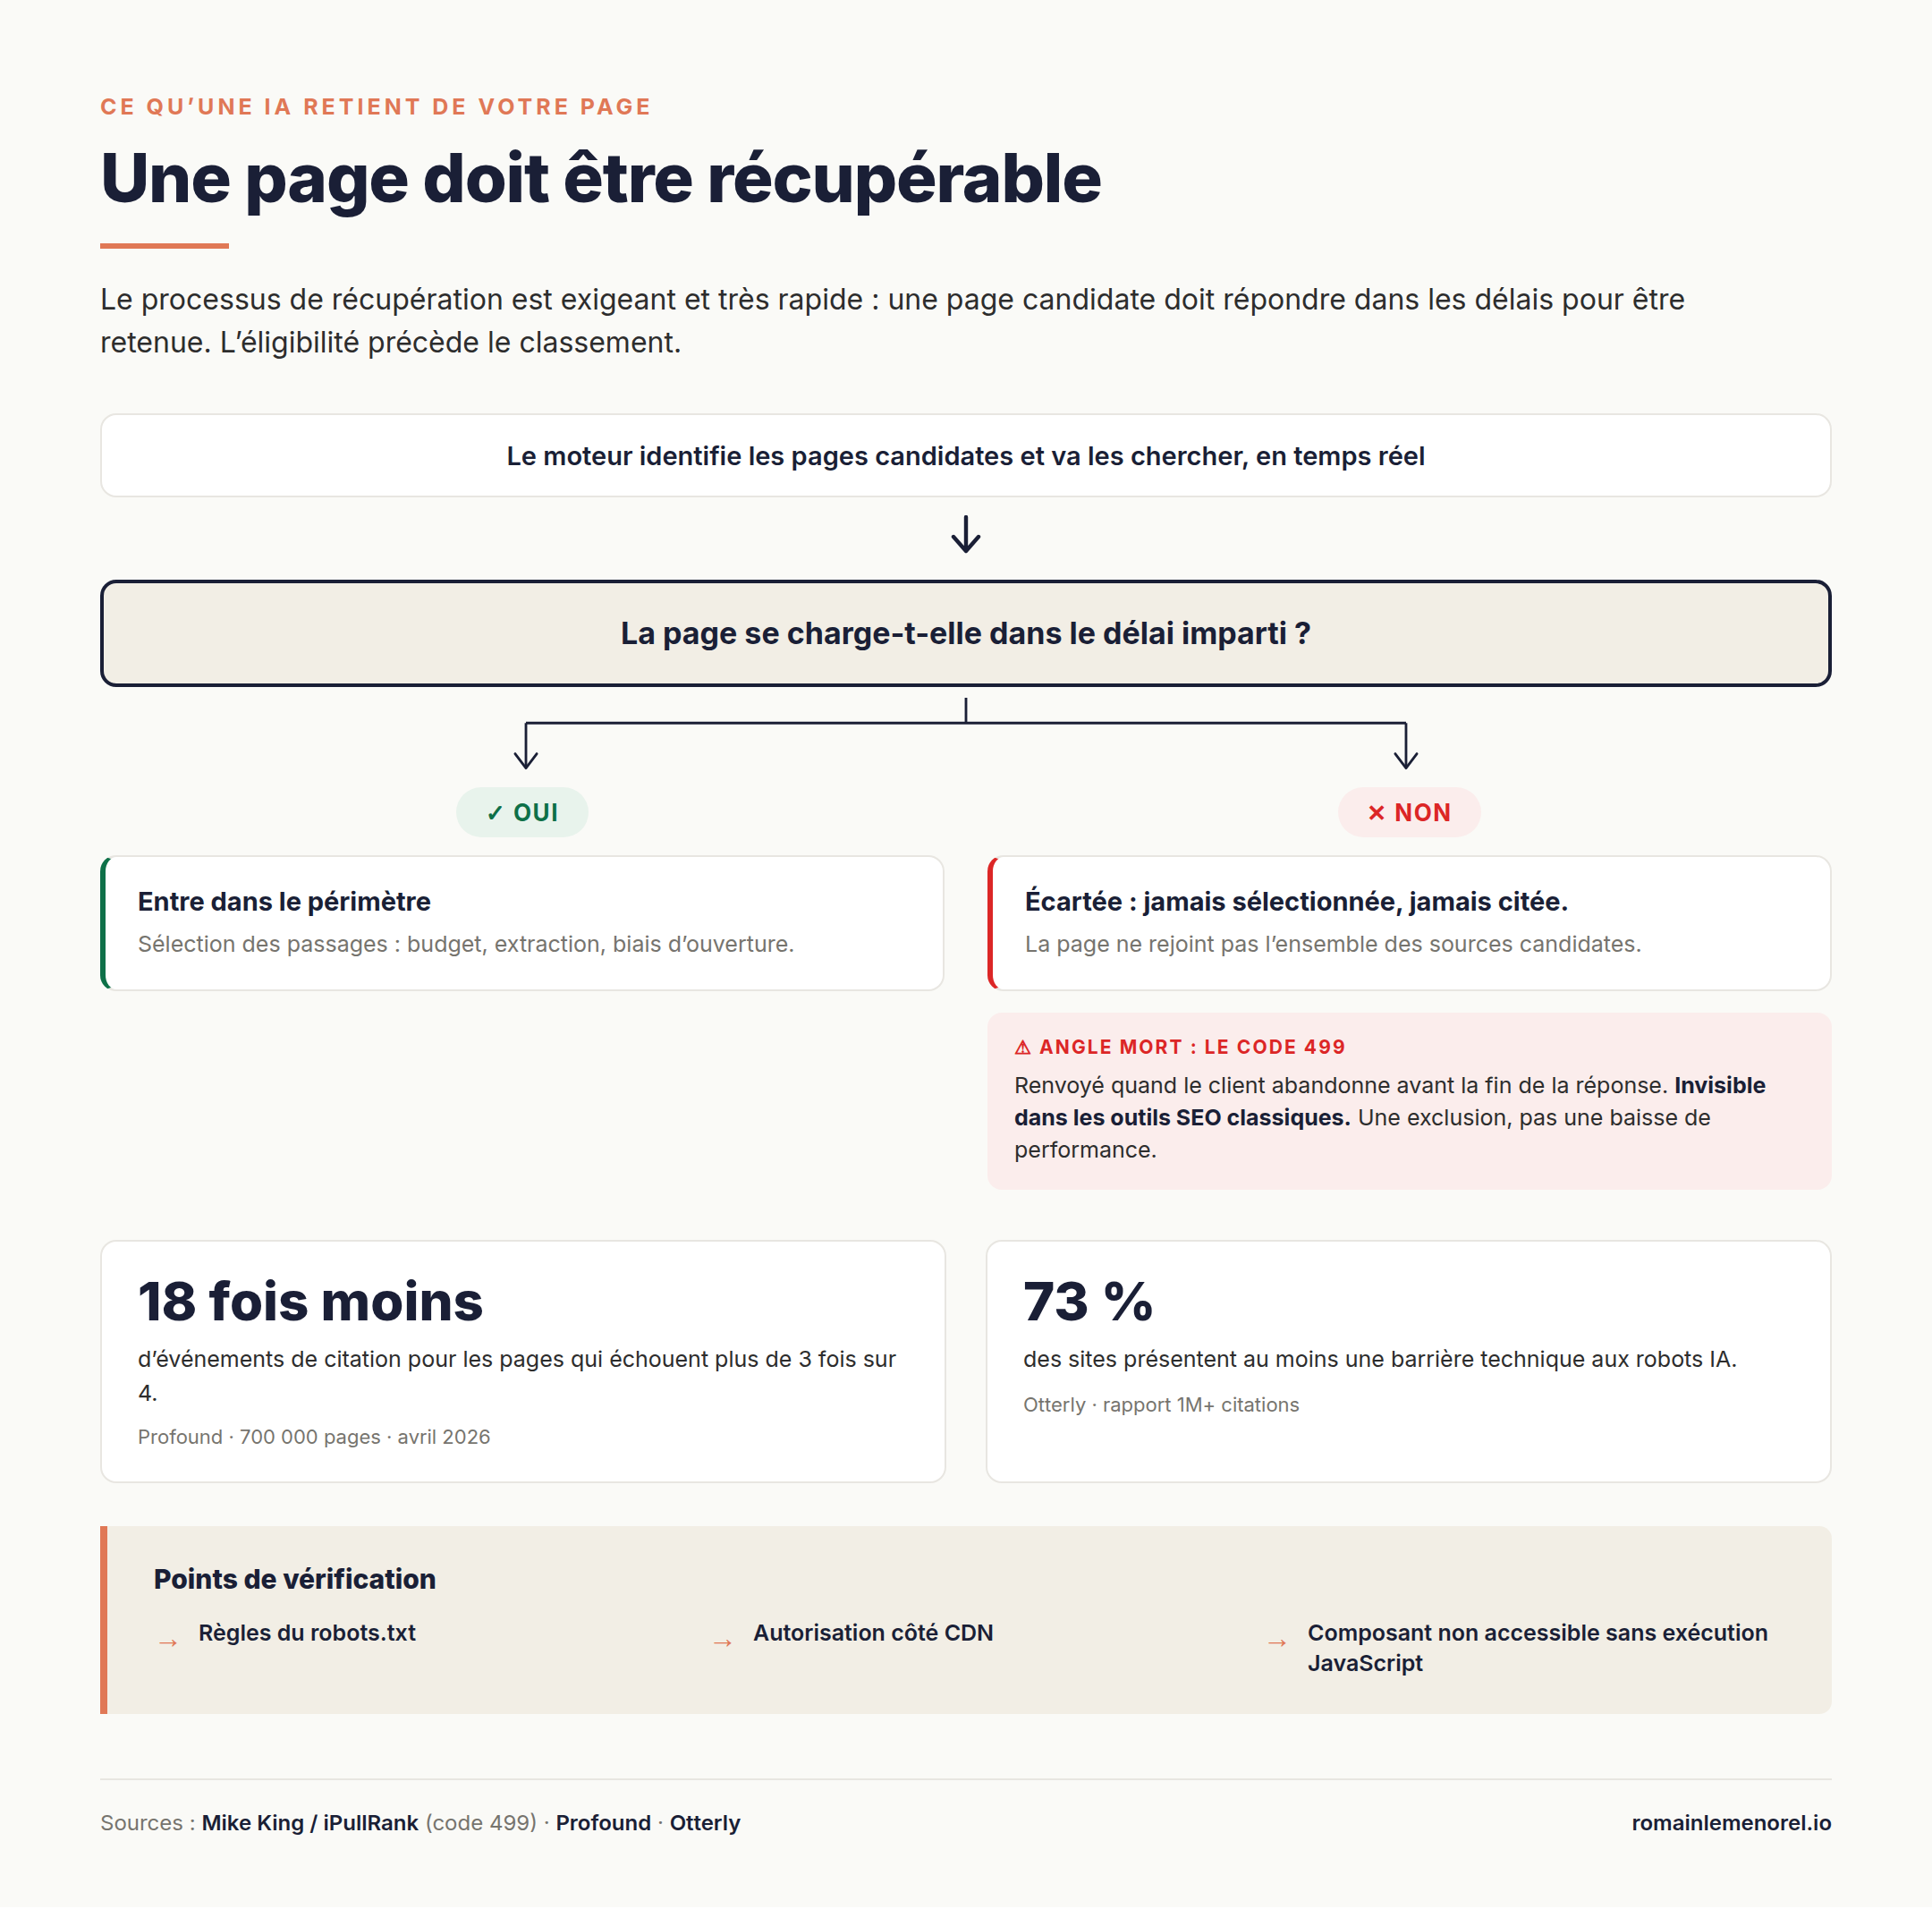
Qu'est-ce que le code 499 ?
Un agent qui ne parvient pas à lire une page dans les délais impartis causera un échec et la page ne sera pas retenue. Ce symptôme peut être identifié par le code 499 qui correspond au cas où le client cesse d'attendre avant la fin de la réponse. Ce code désigne exactement cette configuration où l'agent abandonne la lecture d'une page qu'il ne parvient à lire dans le laps de temps qu'il accorde à ce processus.
Profound a mesuré sur ce constat sur 700 000 pages en avril 2026. Les pages qui échouent plus de 3 fois sur 4 reçoivent en moyenne 18 fois moins d'évènements de citations.
Un autre sujet qui concerne beaucoup de sites, qui ne le savent pas tous. Les robots IA peuvent être bloqués sans qu'on le sache et les causes sont multiples :
- Règle robots.txt qui bloque les robots
- Protection CDN qui filtre les agents
- Contenu servi après exécution du JavaScript
Plusieurs points de vérification s'imposent lors de vos audits en AI Search :
- Règles du robots.txt
- Autorisation côté CDN
- Composant non accessible sans exécution JavaScript
Ce que la récupération ne permet pas d'obtenir
Il faut bien retenir que cette étape de récupération qui conditionne votre entrée dans le classement ne suffit pas à assurer une citation ou une mention.
Le cycle de vie d'une récupération
Le premier point confirmé par Petrovic concerne le cycle de vie d'une récupération lorsque celle-ci est soumise à plusieurs tours de conversation. Le modèle ne conserve pas les extraits qui sont à la base d'une réponse lorsqu'une conversation avance. Une conversation interrompue puis reprise plus tard peut se voir perdre la source des extraits où seules les notes restent.
Le cycle de vie d'un extrait de grounding

  tour 1 : question ──► recherche ──► vos phrases entrent
           au contexte ──► réponse rédigée
                               │
                               ▼  purge : les extraits sont jetés
  tour 2 : relance ──► le modèle ne relit rien ; il travaille
           sur le résumé qu'il a écrit au tour 1
La récupération n'assure pas une réponse exacte
Une récupération n'assure pas que le contenu récupéré donne une information exacte et une information récente ou encore peu répandue peut être omise après récupération.
Un cas fréquent que je constate souvent est sur la version des outils qui font l'objet des questions. Le système IA répond souvent sur une base qui est obsolète et ceci malgré ses efforts de récupération.
Ce phénomène se constate selon le niveau de propagation d'une information.
Pour une marque, un changement de positionnement ou un chiffre clé doit être explicitement mis à jour mais aussi répandu sur un maximum de sources.
Si des informations différentes sont accessibles, la plus répandue et pas nécessairement la plus pertinente peut remonter dans les réponses.
C'est un point d'attention majeur et qui fait le pont avec la notion de mémoire de marque que nous allons voir dans un article dédié.
En conclusion
Notre analyse de la récupération pose plusieurs constats qu'il faut bien retenir :
- La récupération part d'un budget (2000 mots environ)
- Le nombre de mots n'influence pas la récupération
- La densité de faits et d'entités compte plus que le nombre de mots
- Le début du contenu compte plus que le reste
- La citation ne découle pas nécessairement d'une récupération
- La précision de la question utilisateur influence la récupération sur le contenu
- Les Query fan out sont longues et précises
- Les systèmes IA reformulent les prompts différemment selon les modèles
Ces constats nous aident à mieux comprendre ce processus de récupération qui reste le mécanisme le plus important à comprendre en GEO.
Les recherches académiques permettent de nuancer la limite de ces pratiques qui ne suffisent pas à assurer un gain. L'état du contenu et ses performances avant toute réécriture influencent beaucoup le résultat.
Enfin, un point essentiel est l'accessibilité d'une page et de son contenu aux moteurs.
Le code 499 mais aussi l'usage du JavaScript peuvent remettre en question ce processus de récupération.
Une dernière question qui ouvre sur un autre article, que se passe-t-il si le modèle répond sans faire de récupération ? La réponse est dans l'article qui suit sur la mémoire de marque.
Sources :
 Mike King
 Thomas Peham