Markdown : pourquoi c'est le format pivot d'un projet IA
Après s'être intéressé à la knowledge base qui porte tout le référentiel de votre projet, nous allons nous intéresser ici au format qui le compose. On parle évidemment du format Markdown qui est assez peu connu dans l'usage courant. On est en effet plus familier avec un Google Docs ou encore un PDF.
On n'utilise pas ce format pour échanger des informations ou transmettre un livrable. Ce format prend tout son sens quand il s'agit d'optimiser la lisibilité d'un document pour les machines. On verra donc ce qui le rend aussi spécifique par rapport aux autres et comment on l'exploite.
Ma méthode d'audit en 10 étapes qui alimente une knowledge base de constats et de recommandations et qui devient un référentiel documentaire utilisable sur le moyen et long terme. Le choix du format compte donc pour beaucoup pour structurer l'information avec une lecture pour les robots qui doit être optimisée.
Après donc la méthode, puis le référentiel, intéressons-nous maintenant au format qui les porte avec comme objectif : optimisation et productivité.
Nous verrons enfin l'Open Knowledge Format (OKF), qui a été publié par Google Cloud en juin 2026. Cette nouvelle spécification met en avant un dossier de fichiers en Markdown à destination des agents IA. Contrairement à ce qu'on a pu entendre au sein de la communauté SEO et GEO, le format OKF ne joue aucun rôle dans la visibilité de votre site.
Un format adapté pour les modèles de langage
Il y a beaucoup de raisons qui expliquent pourquoi ce format est nativement adapté aux LLM et cela commence dès leur apprentissage. Le web regorge de documents au format Markdown sur des plateformes telles que GitHub, Reddit ou encore Stack Overflow, je ne vais pas tous les citer, l'idée est de retenir que la connaissance des LLM est très souvent passée par ce format.
On le verra juste après : ce qui fait la différence avec un format tel que le PDF qui inonde aussi le web, c'est son poids et ce n'est pas un détail.
Il faut bien retenir qu'un modèle de langage reste en mesure de lire de nombreux formats de documents. Le choix du Markdown n'est donc pas pour une raison de capacité mais pour une raison de coût et d'optimisation. C'est sur ce point que le Markdown surpasse les autres formats.
Le poids du format est l'argument clé pour le Markdown
Face à la majorité des formats, le Markdown l'emporte sur ce critère.
Cloudflare a d'ailleurs pu en faire une démonstration en février 2026 sur l'un de ses articles de blog. Le même contenu pèse cinq fois moins lourd au format Markdown par rapport au HTML.
80% de tokens en moins avec le Markdown face au HTML :
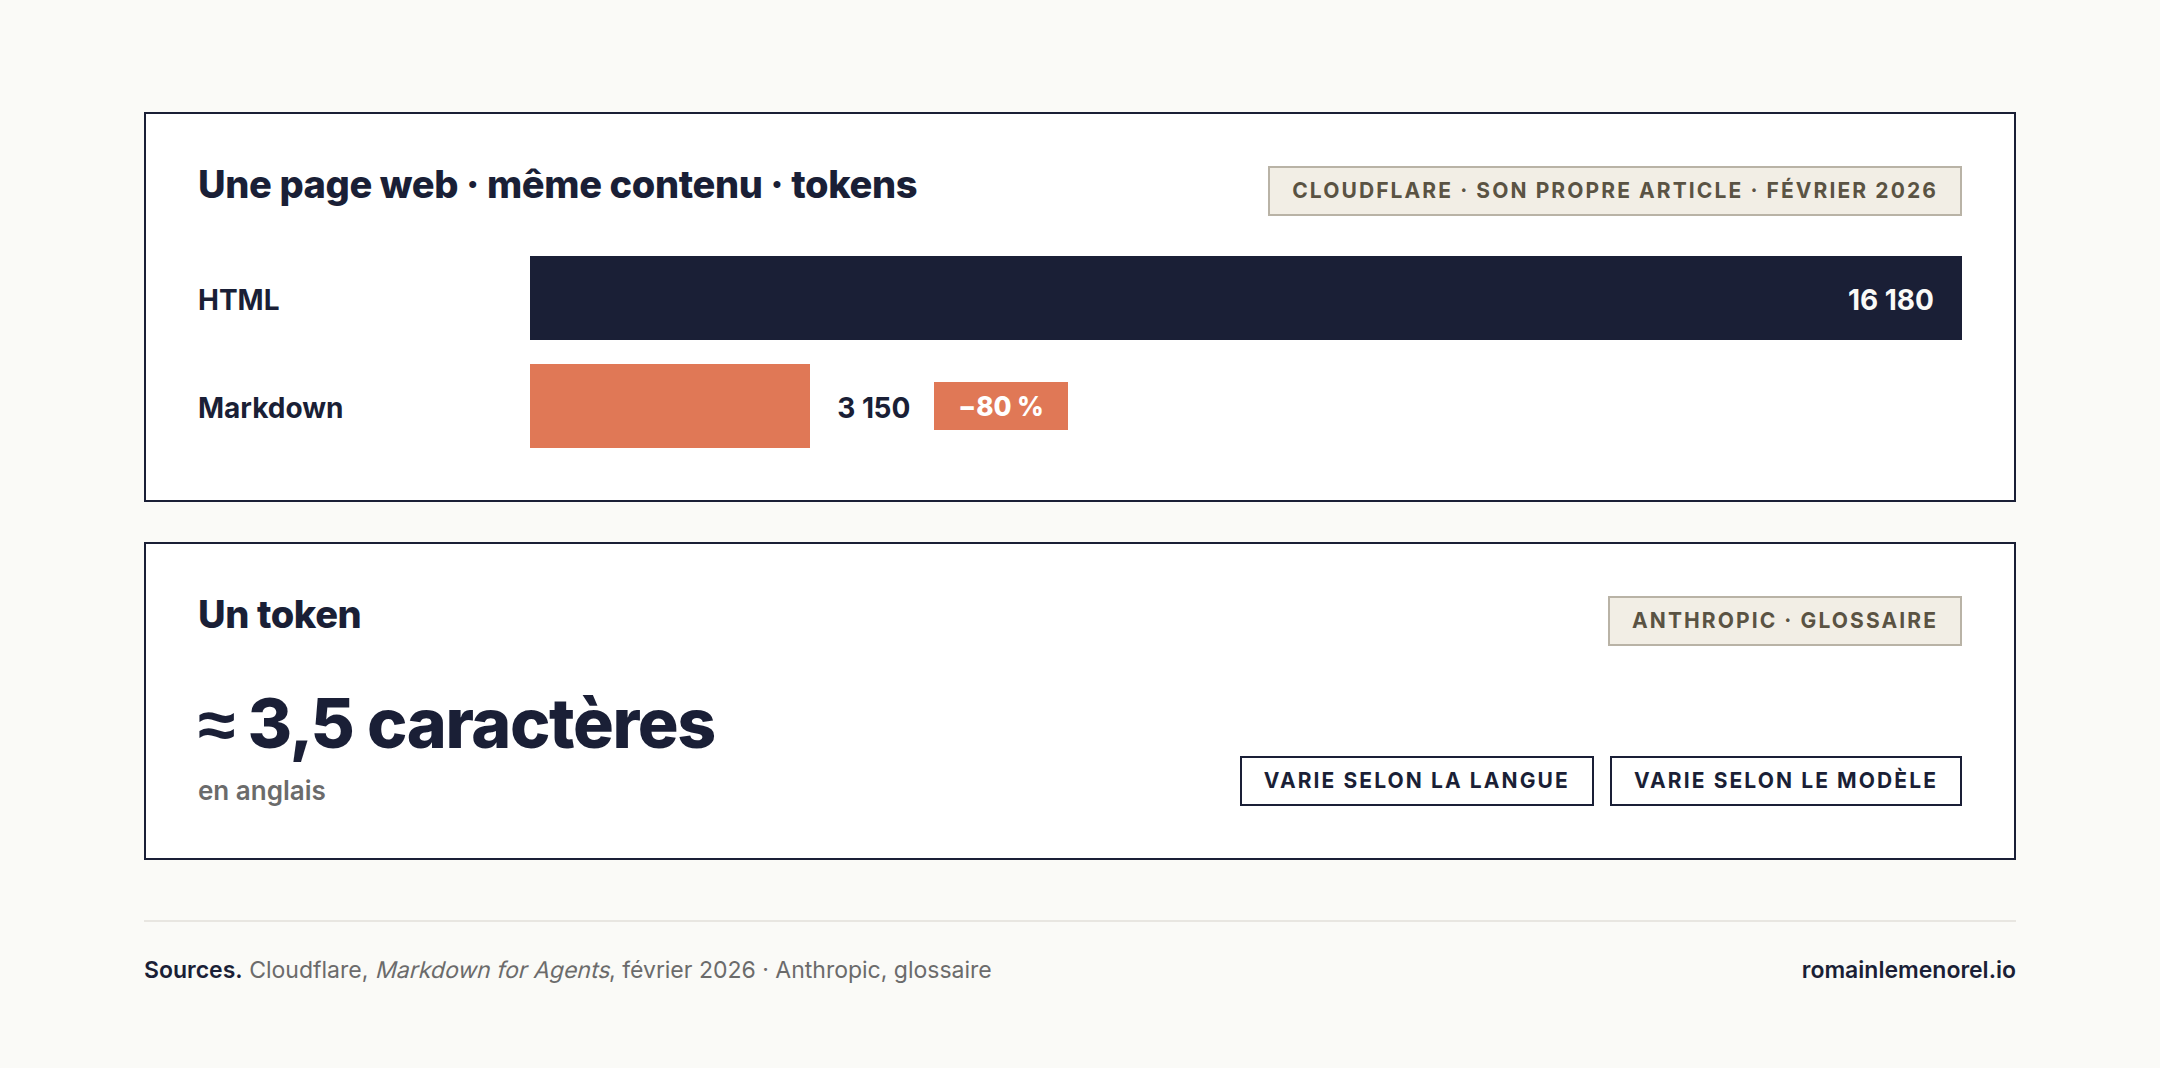
Si vous n'êtes pas familier avec cette notion de token, elle est fréquemment utilisée dans le secteur et désigne une suite de caractères. La confusion fréquente est de penser en nombre de mots. La documentation officielle d'Anthropic indique qu'un token correspond à environ 4 caractères soit 0,75 mot en anglais. Cette correspondance varie selon la langue.
Par définition, le Markdown, et vous le comprendrez un peu plus loin, minimise l'usage des caractères hors texte, cela le rend économique en termes de tokens.
Cela joue sur la fenêtre de contexte du LLM limitée par des tokens.
Pour toutes ces raisons, le format Markdown permet un gain sur le coût et le délai de traitement de l'ensemble de vos documents. La qualité de l'information contenue dans les documents reste bien entendu le point le plus important.
Un format initialement fait pour l'humain
Ce qui est surprenant, c'est que ce format existe depuis longtemps et bien avant même l'apparition de l'IA. C'est John Gruber en 2004 sur son blog qui publie ce format. Son objectif initial était de proposer un format facile à écrire et à lire et pouvant servir de base à un format plus complexe comme l'HTML.
Anatomie du format
Contrairement à du code, le format Markdown est lisible en format brut mais on verra qu'un outil bien connu et probablement celui que j'utilise le plus aujourd'hui permet une édition et une lecture plus facile du Markdown.
Je vous déconseille honnêtement d'ouvrir un Markdown sur Google Docs, les avantages de ce dernier passent par cette transformation.
Un fichier Markdown bien structuré se distingue à sept endroits spécifiques.
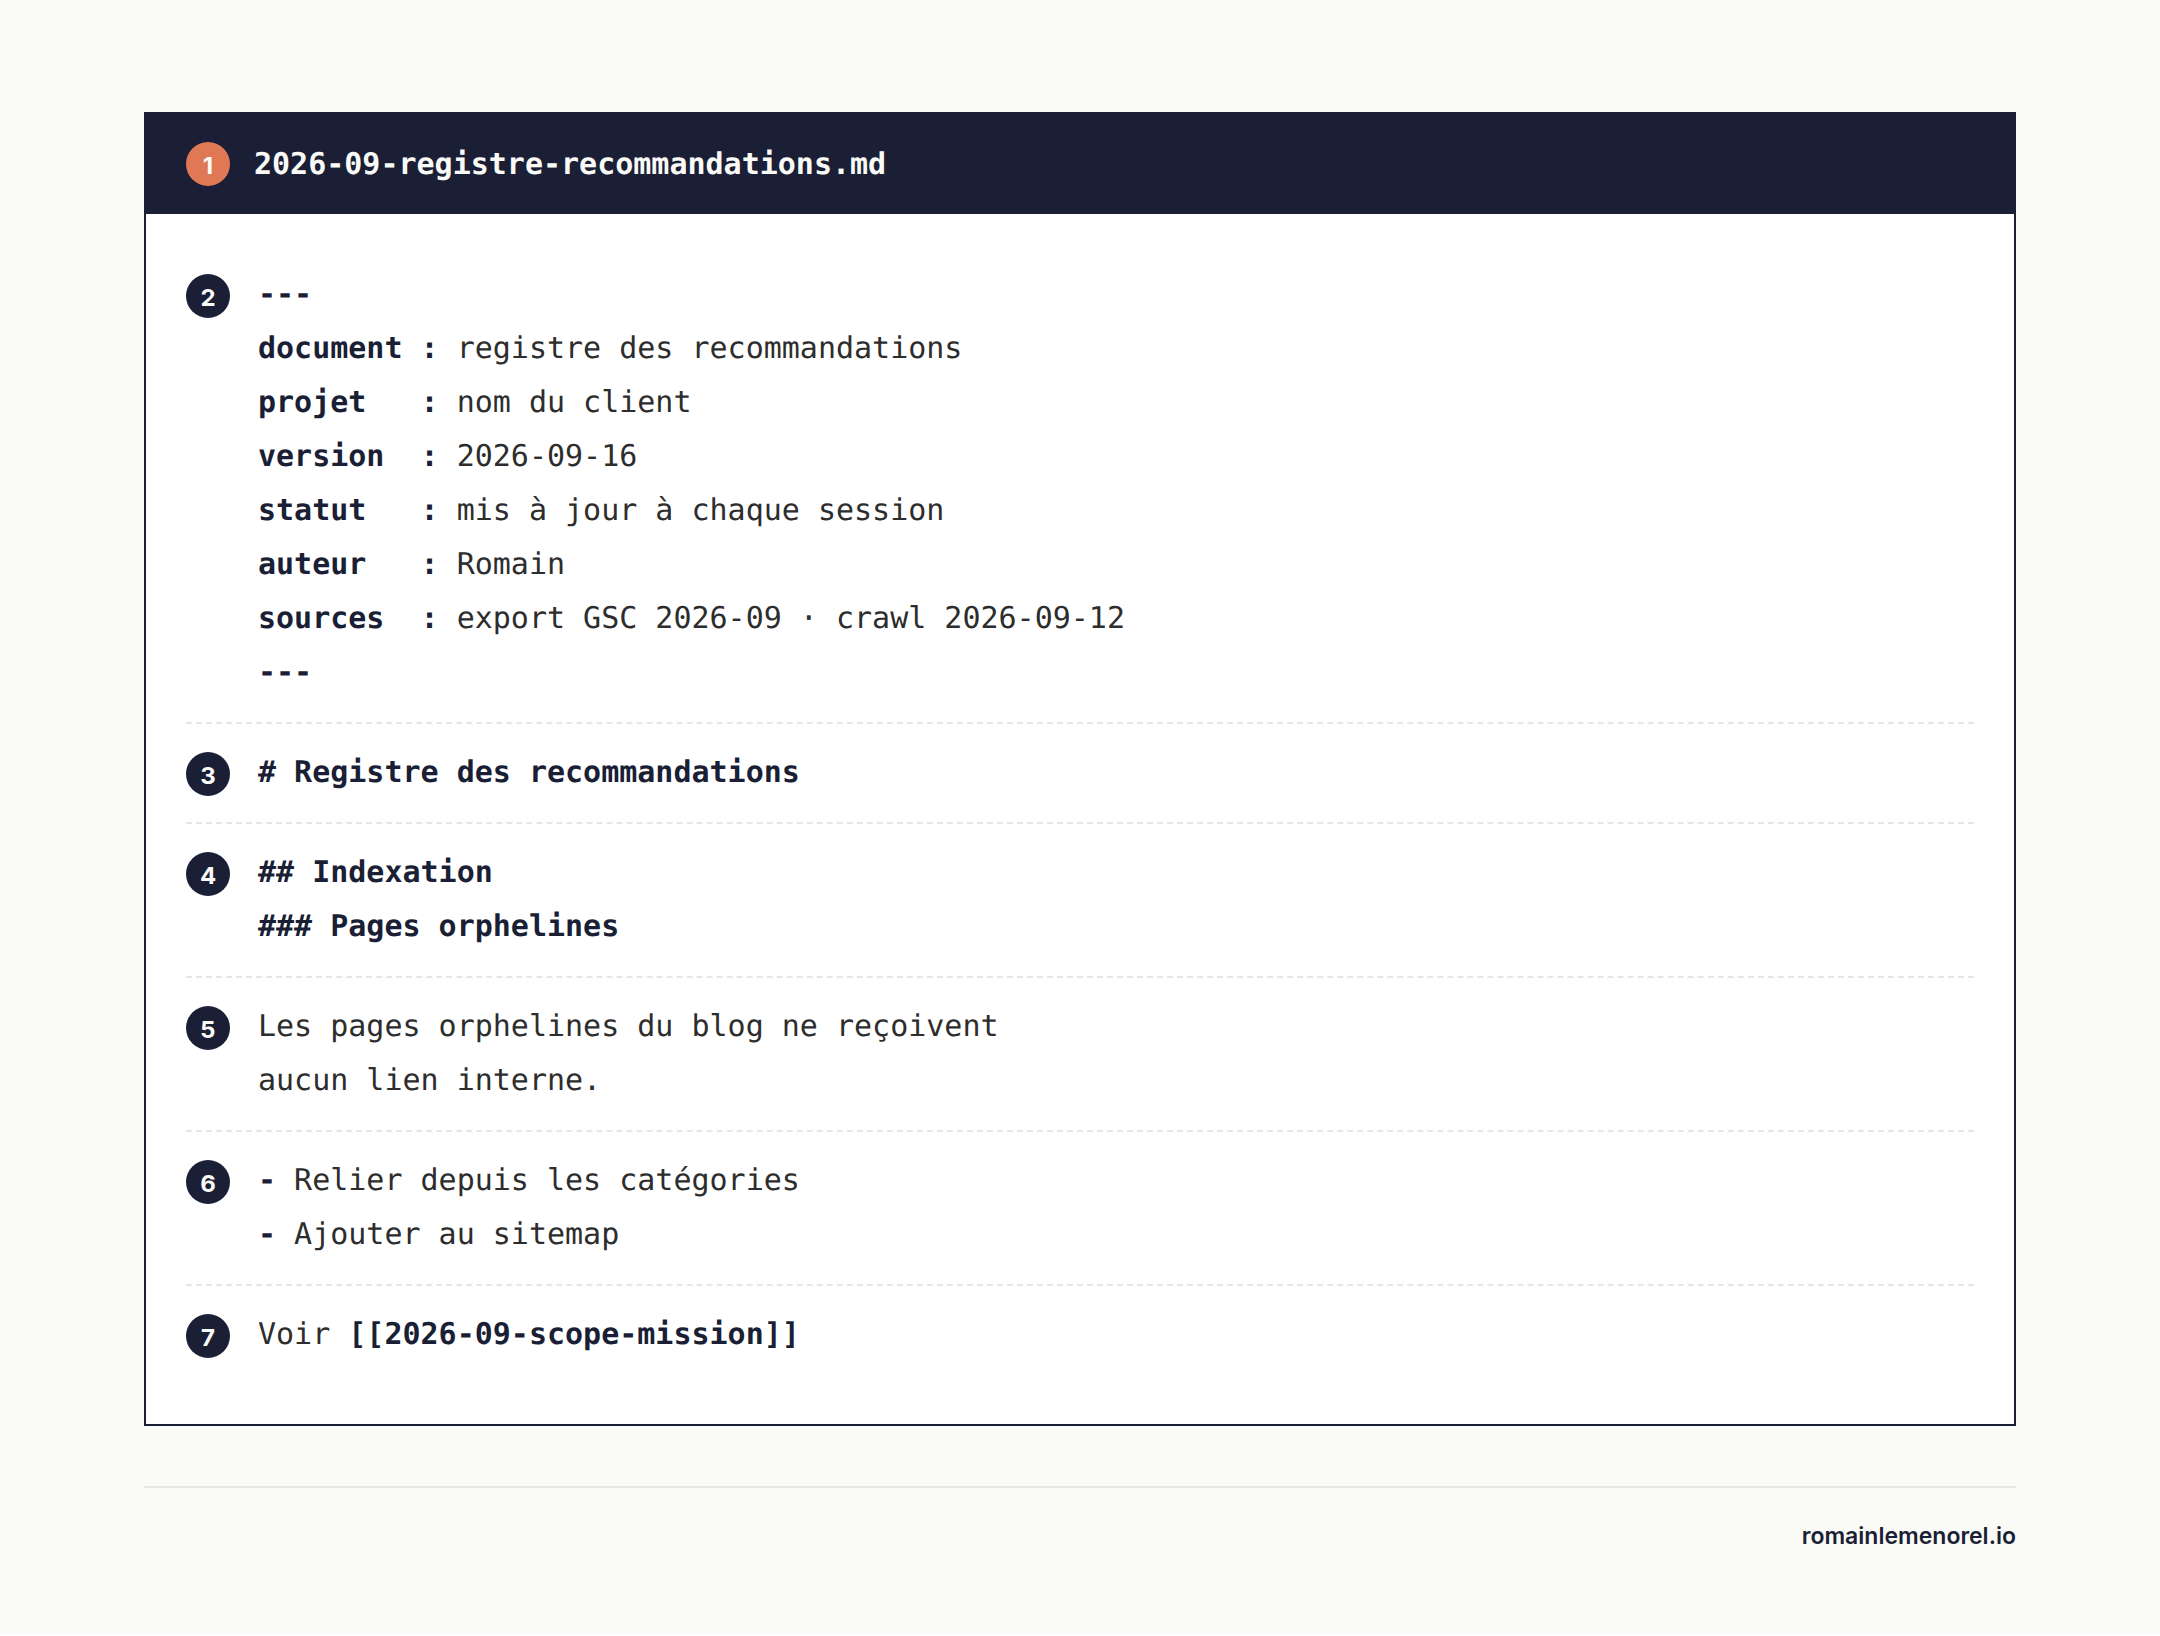
- Un nom clair et explicite avec une date car le document doit être reconnu dans un index. Une knowledge base de 10 documents ou plus doit impérativement respecter cette norme. La date lève le doute sur un risque d'obsolescence
- Un frontmatter au format YAML pour les documents qui évoluent régulièrement. Cet en-tête facilite leur classement.
- Un titre H1 unique comme pour vos pages web.
- Une hiérarchie de titres Hn explicite afin de permettre une lecture efficace du document.
- Des sections autonomes où chaque paragraphe est indépendant et où il n'y a jamais de doublon.
- Des listes à puces ou des tableaux pour les énumérations et les synthèses.
- Un maillage entre les fichiers.
On peut donc le voir : l'optimisation d'un fichier Markdown pour votre knowledge base doit respecter les mêmes règles que pour vos pages.
La raison est que le mécanisme de récupération d'une knowledge base est le même que pour les pages à une échelle plus locale bien entendu.
Le frontmatter, une section utile pour la lecture par les modèles
Le frontmatter, pour ceux qui ne connaissent pas, est un en-tête placé en haut du document. Le Markdown natif ne le prend pas en charge. Les outils ont fait évoluer le format pour l'intégrer et son usage s'est imposé. Chaque information d'une entête est servie en paire avec une donnée clé et sa valeur correspondante. La date en est un exemple très fréquent.
On peut le comprendre très vite, cet en-tête peut être très utile dans une base de données ou une knowledge base.
Voici un exemple d'entête que je place sur mes documents de la knowledge base. Le format de l'entête est en YAML avec ici 8 paires de clé-valeur.
---
document : registre des recommandations
projet   : nom du client
version  : 2026-09-16
session  : 14
statut   : mis à jour à chaque session
auteur   : Romain
sources  : export GSC 2026-09 · crawl 2026-09-12 · logs 2026-08
lire     : après le system prompt et le scope de la mission
---
Ce frontmatter est particulièrement efficace pour retrouver des informations sans lire l'intégralité du texte. Je ne reviens pas sur la mécanique de récupération que nous avons vue dans l'article sur la knowledge base mais l'intérêt ici est majeur.
Une autre fonctionnalité très utile est que cet en-tête peut être lu par la machine sans ouvrir le document. Les capacités de Claude permettent ce fonctionnement et facilitent le traitement de bases de données importantes (plusieurs centaines de Markdown). A cette échelle, l'entête peut devenir essentielle.
Le Markdown existe aussi avec une spécification standardisée, connue sous le nom de CommonMark ainsi que d'autres variantes dont celle de GitHub. Nous n'allons pas en parler ici car l'essentiel de ce qu'il faut savoir réside dans le format de base.
Que vaut le Markdown face aux autres formats ?
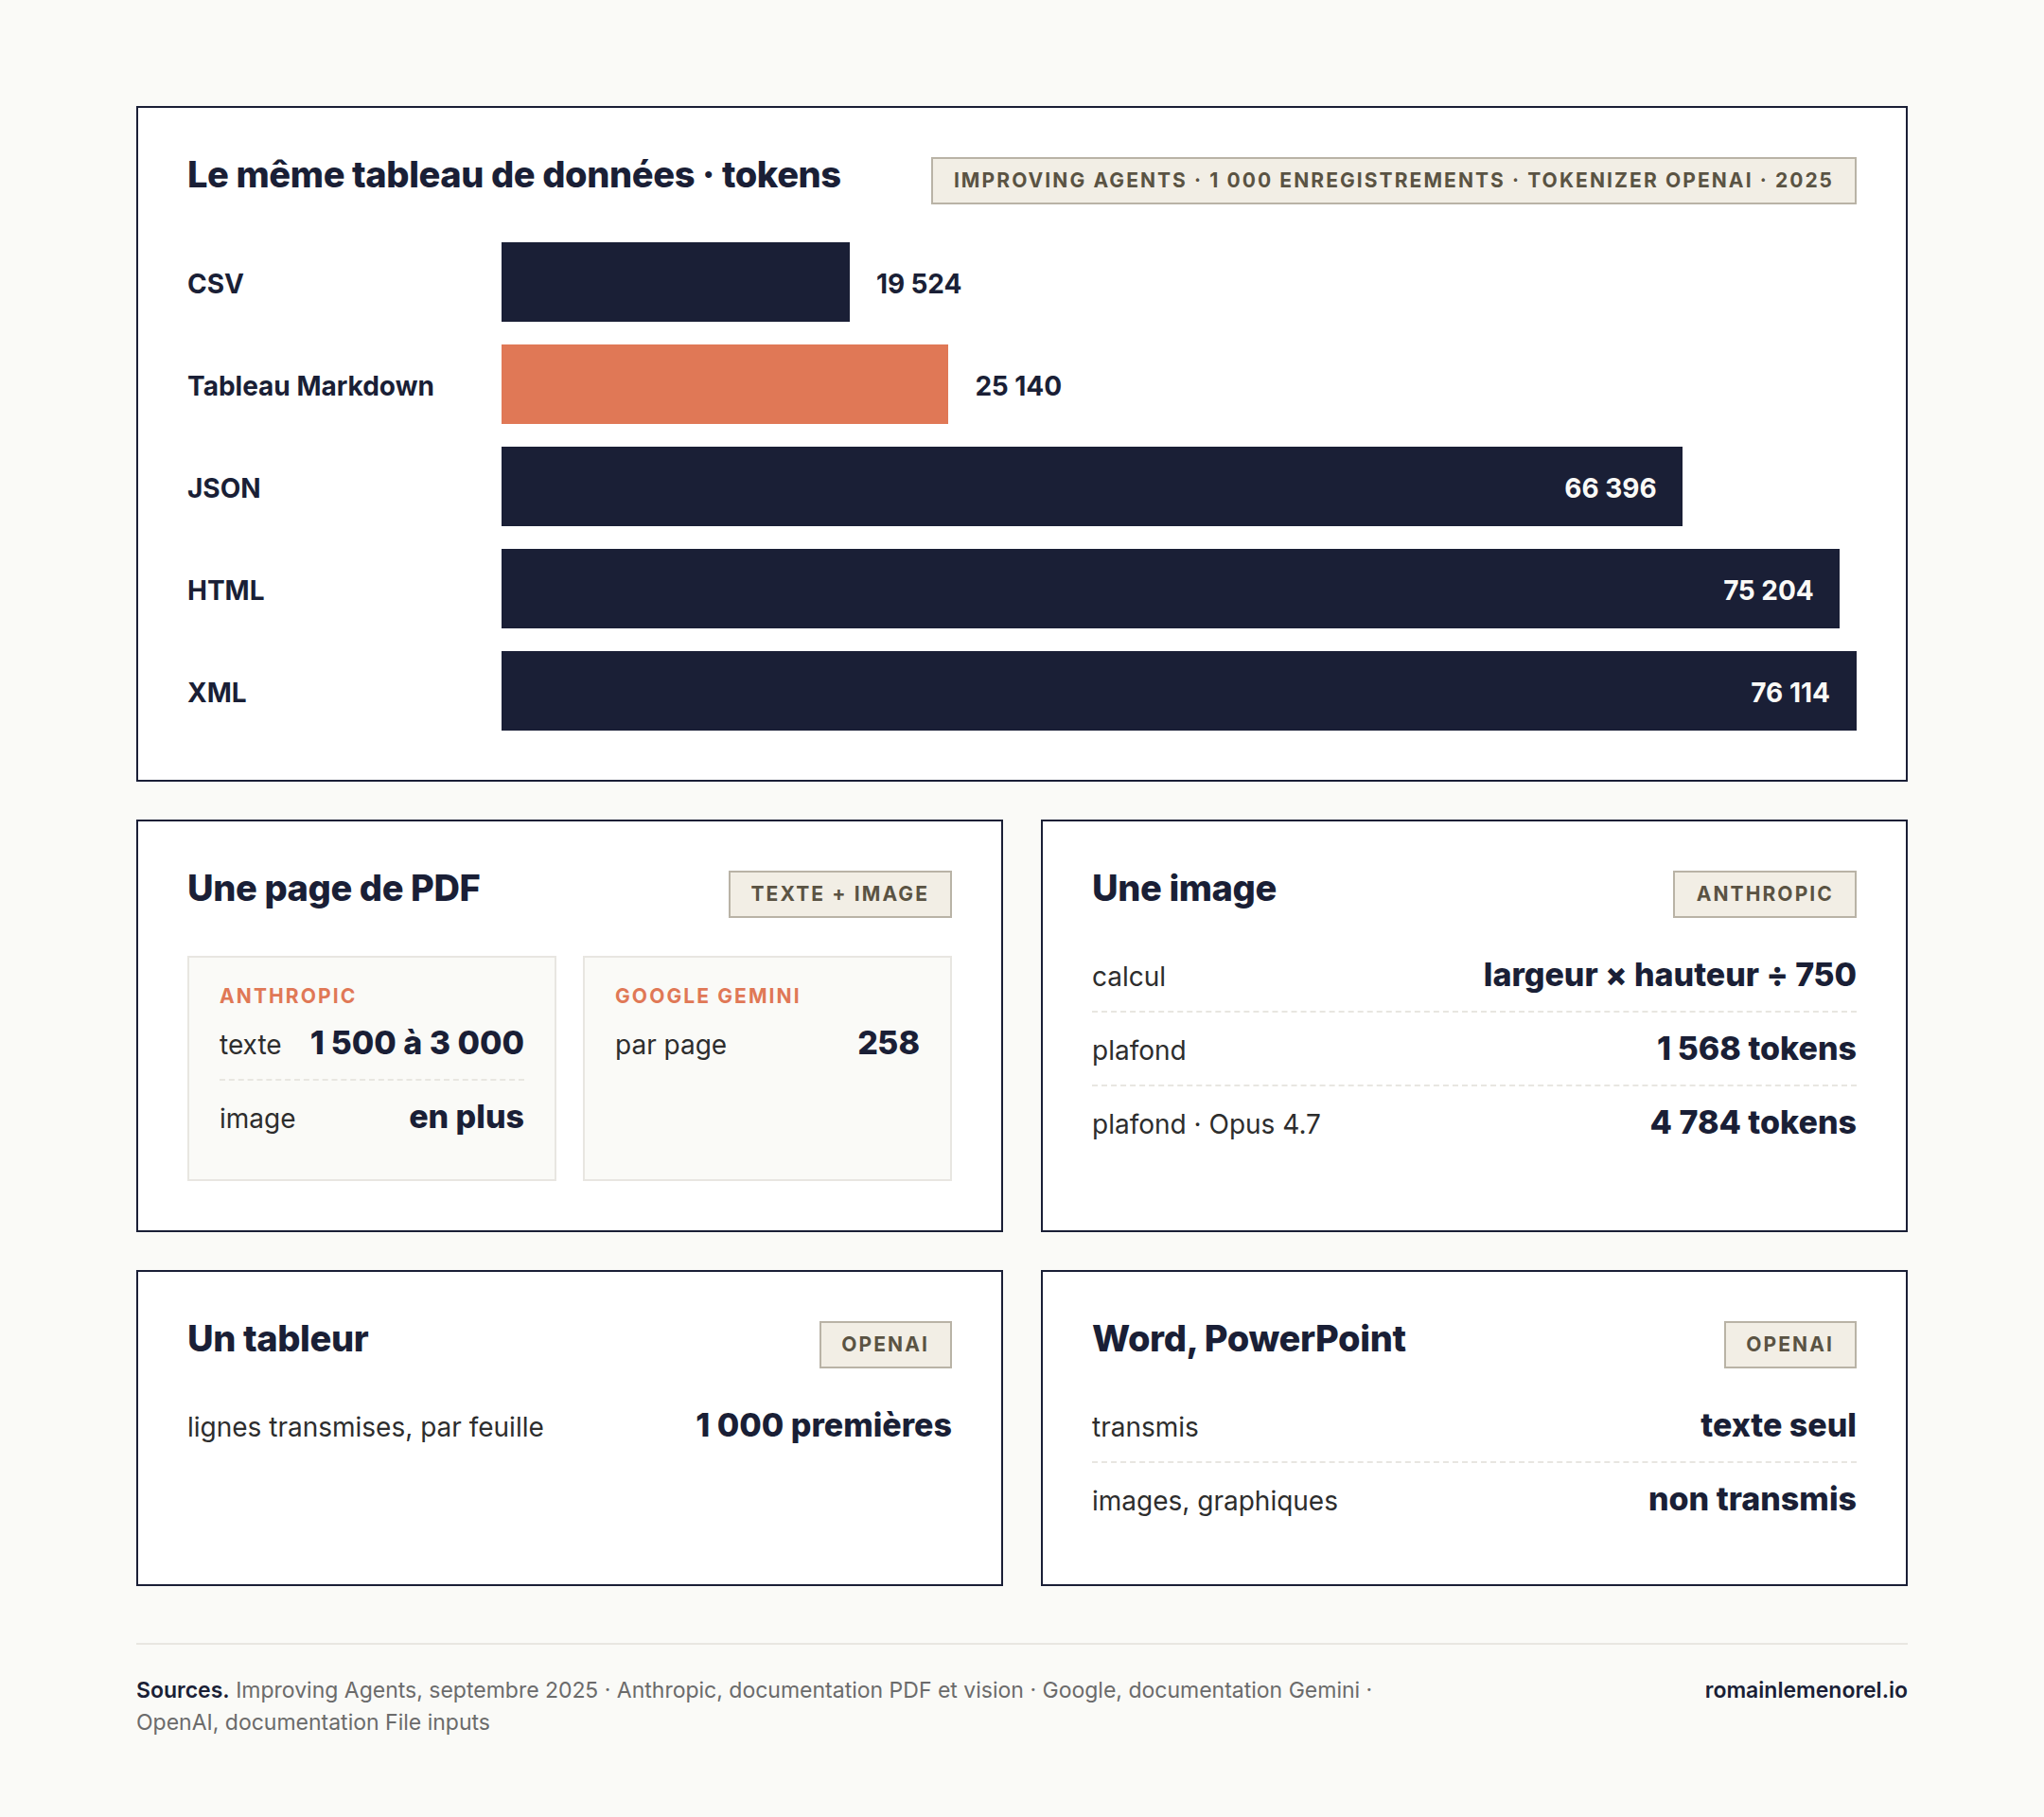
Les formats que nous pouvons servir aux LLM sont nombreux et il faut bien comprendre que les modèles ne lisent que du texte et des images. À ce sujet, les documentations d'Anthropic, Google et d'OpenAI se rejoignent avec un mécanisme commun qui dit qu'un fichier est soit lu comme il est présenté, soit converti en texte, soit transformé en image.
Bien entendu certains formats génèrent davantage de perte et c'est là que l'optimisation réside.
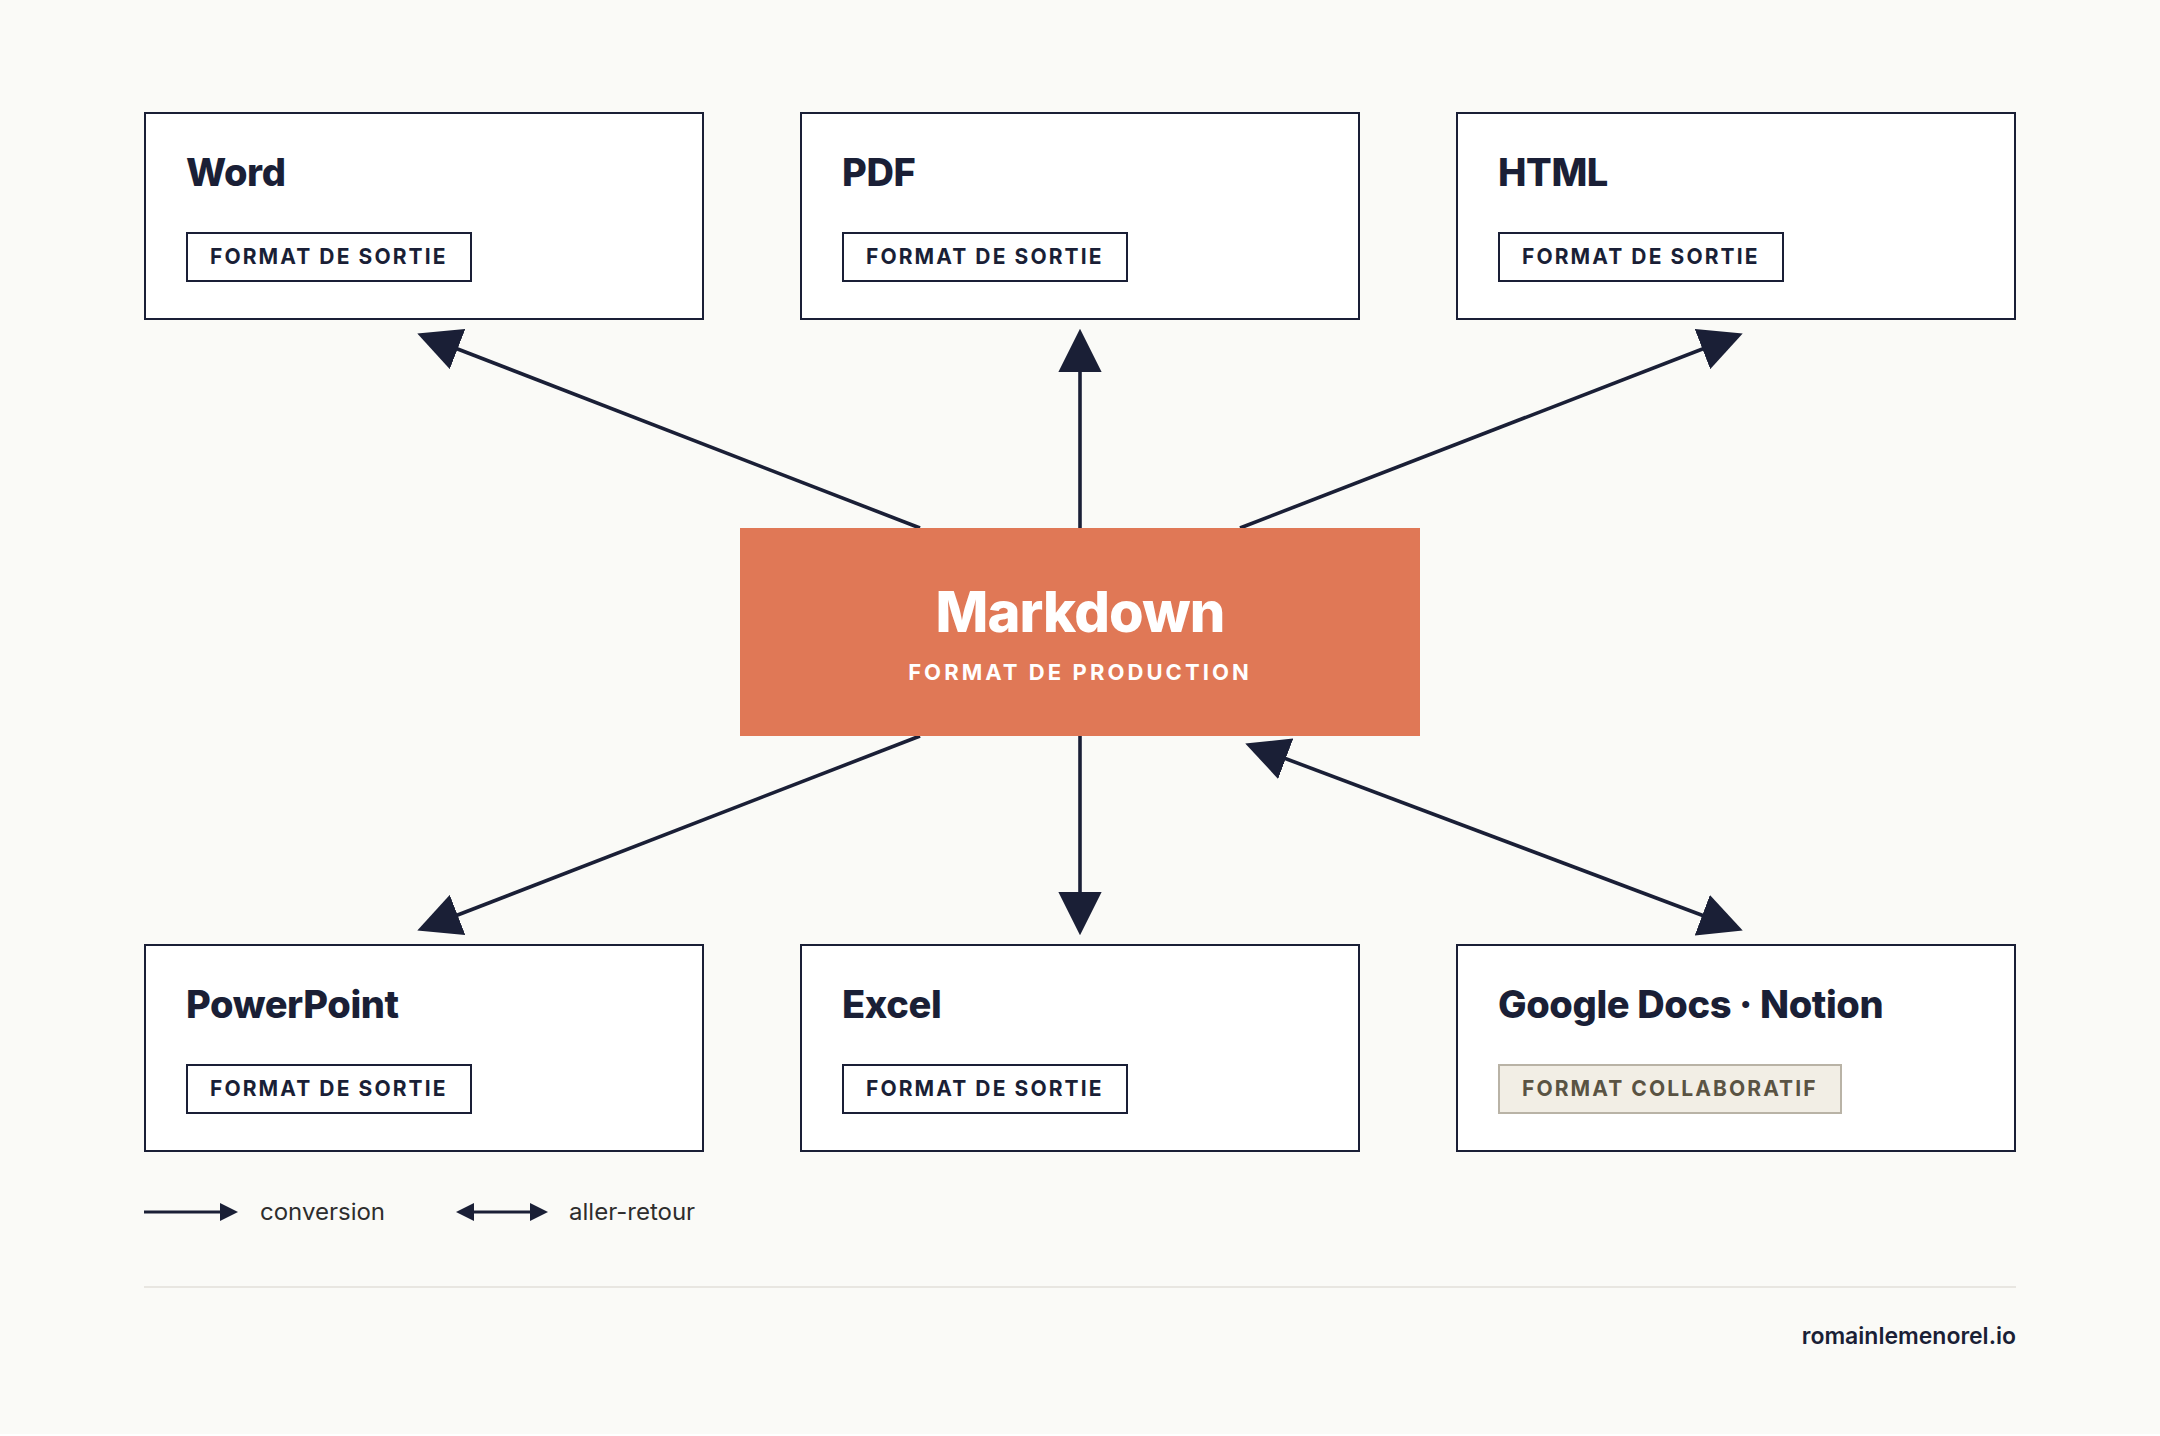
Voyons maintenant les principaux formats que l'on sert au LLM :
- Markdown et texte brut : C'est le format de production optimal car tous les caractères y portent du sens et où les titres y rendent la structure.
- HTML : Ce format est aussi lu en version brute mais chaque caractère dont le balisage, les attributs et les scripts pèse à cette lecture. C'est donc un bon format pour transmettre une information visuelle ou interactive mais beaucoup plus coûteux en tant que format de travail principal.
- CSS et JavaScript : Ces formats sont lus comme du code. Ils sont utiles quand ils font l'objet de l'analyse et du développement. Ils ne sont pas optimaux pour transmettre ou stocker une information.
- JSON, XML et YAML : Ce sont des formats d'échange entre applications. Comme pour le HTML, chaque caractère génère un coût en tokens.
- CSV : C'est le format de données tabulaires le plus léger car il n'est structuré que par ses colonnes. Ce format est parfait en tant qu'export mais pas en tant que document.
- Excel : Le format Excel ne peut être lu en direct, il est interrogé avec du code et seule une partie du document est lue par le modèle. C'est un format d'analyse ou de sortie exclusivement.
- Word, Google Docs et Notion : Ces formats subissent une conversion également mais en texte. Ce qui est du formatage disparait dont les visuels. C'est un format de sortie qui reste utile pour le travail collaboratif.
- PowerPoint : Le Powerpoint est également converti en texte, tout le reste se perd et génère malgré tout un coût en tokens. A réserver en format de sortie exclusivement.
- PDF : Ce format a la spécificité d'être lu deux fois, par le texte d'abord puis ensuite par les images. Ce double passage se paie en tokens bien entendu. Il est surtout utile en format de sortie quand la mise en page est attendue.
- Images et captures : Les images peuvent être lues par les LLM et leur coût en tokens dépend de leur taille en pixels.
Le format HTML face au Markdown
La question du Markdown face au HTML est revenue plusieurs fois comme sujet dans la communauté GEO.
Sur trois usages récurrents, le HTML l'emporte deux fois sur trois :
- Servir une page au public :
Le Markdown n'est jamais servi comme format de pages indexées contrairement au HTML ou même PDF. Il n'est pas un format de sortie à destination des utilisateurs. - Produire un artefact visuel ou interactif :
Les productions des développeurs nécessitent de la visualisation et de l'interactivité. Le Markdown aplatit cette structure et ne convient pas pour cet usage. - Travailler avec un LLM :
Pour le travail avec un LLM, le Markdown est le format le plus économique ne générant aucune perte et permettant de rester structuré (contrairement au fichier txt par exemple).
Le Markdown est le meilleur compromis entre économie d'usage et structuration du contenu.
Le Markdown dans la knowledge base
Dans une knowledge base et donc un projet Claude, le Markdown est le premier choix pour la constituer et la tenir dans la durée. Il faut voir chaque document comme une page web sur un site qui sert un usage.
Si vos documents d'origine sont dans un autre format, il faudra les convertir en passant par une synthèse. Cette conversion permettra un gain d'efficacité et de productivité par la suite. Chaque Powerpoint, PDF ou Excel qui sort de vos outils ou sources de données doit passer par cette phase de conversion.
Le LLM peut d'ailleurs vous aider à transformer ces documents en Markdown structuré.
Obsidian, au cœur de la pratique du Markdown
Obsidian est l'outil de référence pour la lecture et le traitement des fichiers au format Markdown. C'est sa vocation principale.
On peut se demander pourquoi cet outil fait la différence s'il ne gère que ce format. La réponse tient sur plusieurs critères sur lesquels il se démarque sans hésitation.
Le vault comme dossier de fichiers
Le vault est l'endroit où l'on va placer ses fichiers. Ce système est assez déroutant au début car on ne peut ouvrir un fichier Markdown hors d'un vault.
On peut se demander la raison de ce choix et on verra qu'elle est assez évidente quand on découvre les fonctionnalités d'Obsidian. Vous le verrez mais un vault sera potentiellement le miroir de votre knowledge base.
Les liens internes au vault pour mailler les fichiers
Le maillage comme sur des pages HTML d'un site est possible sur Obsidian et l'intérêt n'est pas juste pour le clic, il est utile pour le LLM qui l'explore sous condition qu'il ait accès au vault. Cela peut être le cas si vous autorisez le LLM à travailler sur votre bureau.
Ce maillage entre les documents peut être visualisé sous forme de graphe.
De nombreux plugins fournis par la communauté
Obsidian est enrichi par sa communauté de plugins dont certains sont des incontournables pour le formatage. Je ne vais pas les énumérer ici, on abordera Obsidian dans un article dédié.
Cet outil dévoile tout son potentiel quand on le connecte à un modèle de langage. C'est ce que fait Andrej Karpathy en avril 2026 qui publie LLM Wiki sur GitHub. Le modèle transforme des données brutes en documents Markdown structurés avec tout un réseau de liens qui les relie entre eux. Cela forme ensuite une knowledge base alimentée et mise à jour régulièrement. Cette technique est aussi appelée celle du "second cerveau" permettant un accès aux données les plus optimales.
Ce que Google vient de standardiser
Le 12 juin 2026, l'Open Knowledge Format fait son apparition sur le blog Google Cloud avec une version 0.2 qui est sortie le mois suivant.
Cette spécification propose un format de normalisation des données destinées aux agents IA. La raison pour laquelle on en parle ici est que le format choisi est le Markdown.
Il ne faut donc pas le confondre avec un format de flux produits. Ici on parle d'une spécification optimisée pour la lecture par les agents avec une entête YAML.
C'est une formalisation du LLM Wiki d'Andrej Karpathy.
À quoi ressemble l'OKF de Google ?
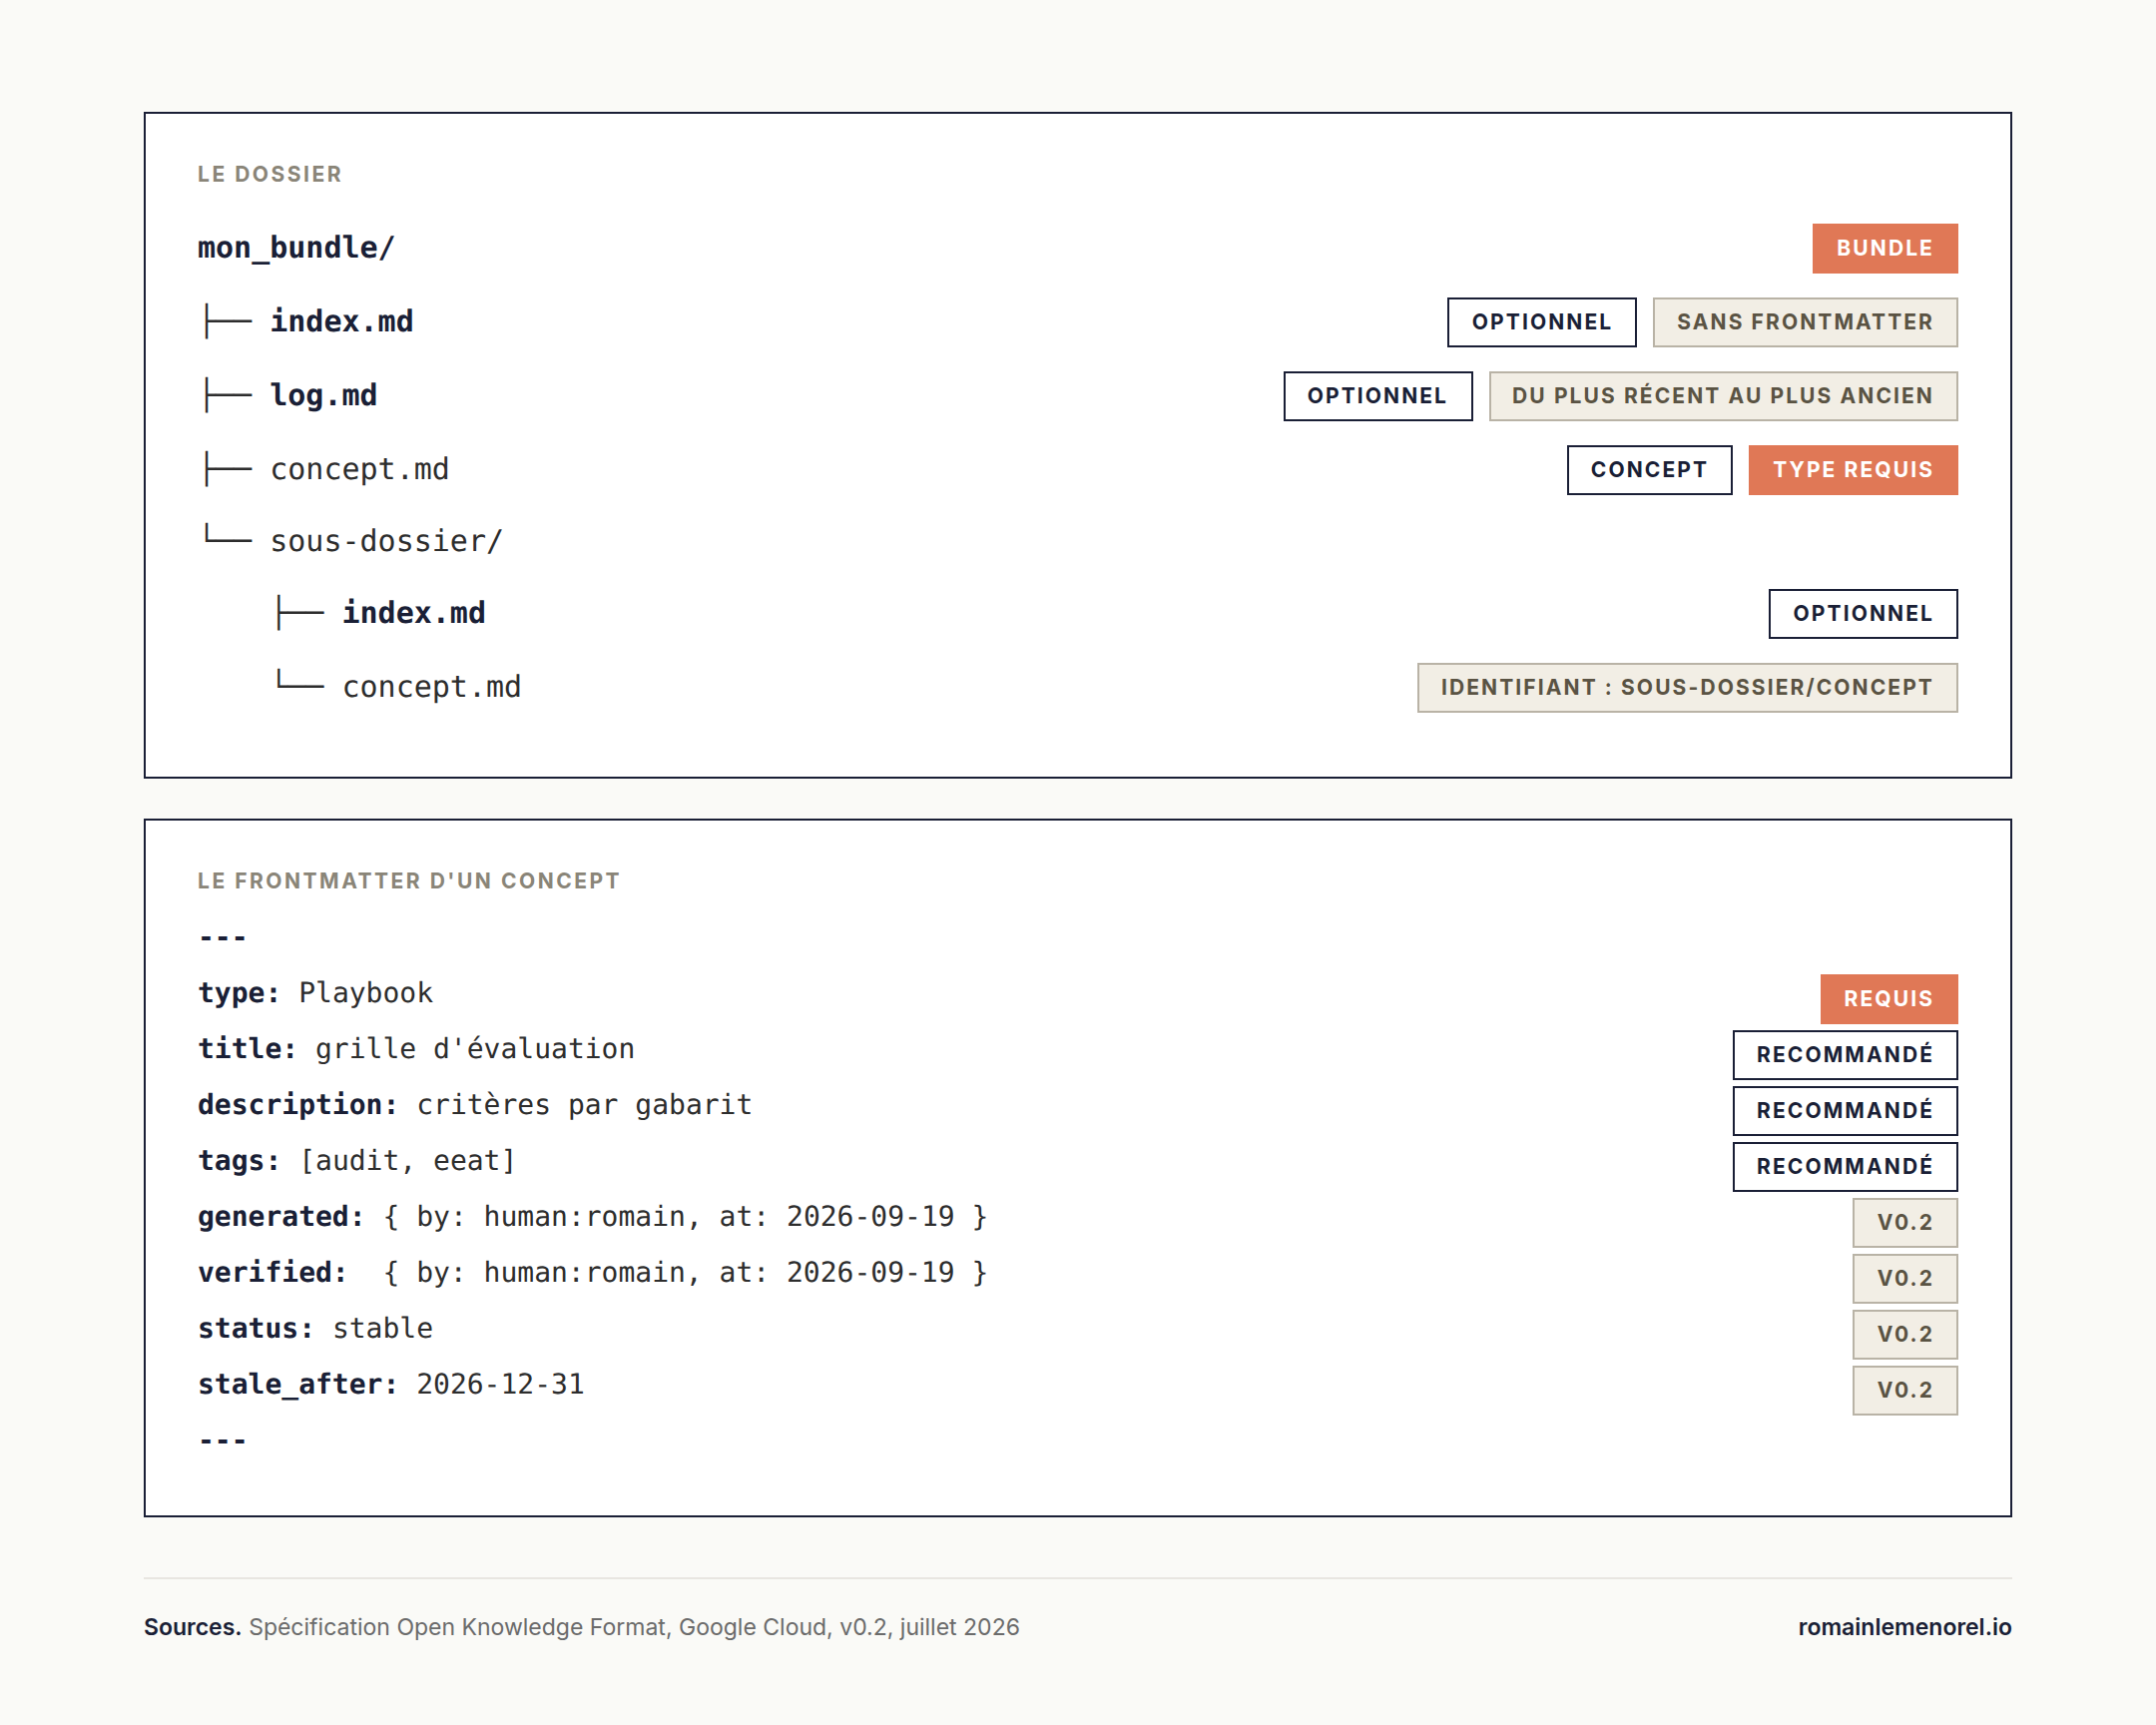
L'OKF se décrit en 5 notions distinctes :
- Le bundle : c'est le dossier complet qu'on distribue aux agents
- Le concept : désigne le fichier de connaissance
- L'identifiant : désigne le chemin du fichier
- Le frontmatter : chaque fichier comporte un en-tête dans lequel un seul champ est obligatoire (le champ type), les autres sont optionnels.
- Les liens Markdown : ce qui forme le graphe de l'ensemble du Bundle
On y retrouve 2 fichiers optionnels, l'index.md qui liste l'ensemble des contenus et qui sera le premier fichier ouvert par l'agent puis le log.md qui consigne tous les changements effectués sur le Bundle.
Le format OKF a été conçu pour partager des informations entre des équipes et leurs agents. Google rappelle bien dans sa documentation officielle qu'aucun fichier texte destiné aux robots n'est nécessaire pour être cité ou mentionné.
Ce qu'on peut retenir du format Markdown
Nous avons pu voir l'essentiel autour de ce format qui reste à ce jour le format que les LLM lisent et écrivent nativement. Son usage doit être confronté aux formats plus standardisés qui servent à la lecture, au travail collaboratif ou à des productions visuelles et interactives.
Ce format ne remplace pas les autres formats, il reste simplement le plus performant pour constituer une base documentaire que le modèle pourra utiliser comme référentiel.
Si on doit résumer ses forces :
- Le format le plus économique en tokens
- Entièrement administrable sans connaissance technique
- Dispose des options essentielles de balisage
- Format 100% texte sans perte à la lecture par un robot
Le choix du format doit donc être pensé à toute étape du projet. Le Markdown, lui, sera à privilégier pour votre knowledge base.