Knowledge base et LLM : la méthode complète
Dans l'article précédent sur ma méthodologie d'audit en dix étapes, nous avons vu la méthode dans son ensemble et le rôle du LLM à chacune de ces étapes. Le gain au niveau de l'analyse et de l'efficacité est important mais reste conditionné par le contexte posé par la knowledge base : c'est précisément ce que nous allons voir dans cet article.
La knowledge base repose sur une mécanique de fonctionnement des LLM que nous allons détailler ici. Comme je l'avais précisé, la compréhension du fonctionnement des LLM est la clé de la réussite de ce type de projet.
Quand nous parlons de « knowledge base », nous parlons bien du corpus de documents que vous placez dans un projet Claude et qui pose le référentiel du projet. Sans ce référentiel, vous travaillez sans contexte et la conséquence directe est une perte de temps et d'efficacité considérable.
Dans mon cas, je pratique la knowledge base depuis que j'ai intégré l'intelligence artificielle dans mes process et je dois avouer que je ne travaille plus sans aujourd'hui.
Nous n'allons donc pas revenir sur la méthodologie d'audit que nous avons déjà vue en détails. Nous allons nous intéresser à cette « knowledge base » pour mieux comprendre son rôle à chaque étape et voir comment exploiter au mieux ce fonctionnement propre des modèles de langage et cela va bien au-delà de l'audit.
Qu'est-ce qu'une knowledge base, mécaniquement ?
Avant de développer sur la pratique de la knowledge base, nous allons revenir sur son fonctionnement de base et ce qui la caractérise.
Un des fonctionnements de l'intelligence artificielle qui peut nous aider à mieux comprendre le rôle de la knowledge base est la récupération ancrée (grounded retrieval), qui désigne l'action par laquelle l'intelligence artificielle va récupérer des passages issus d'un corpus de texte pour formuler sa réponse.
Ce mécanisme est par définition mesurable et maîtrisable car nous avons l'entière maîtrise sur celui-ci en respectant des critères d'éligibilité que nous verrons un peu plus loin, ce sont d'ailleurs des critères que nous connaissons assez bien du SEO classique.
Ce processus de récupération ancrée s'oppose à la génération probabiliste (probabilistic generation), procédé par lequel le LLM génère une réponse à partir des connaissances issues de son entraînement sans faire appel à un contenu récupéré. On dit que cette génération est probabiliste car la réponse suit des distributions de probabilités calculées par le modèle. De ce fait, on ne peut pas garantir qu'une réponse sera reproduite et la source de l'information ne remonte pas.
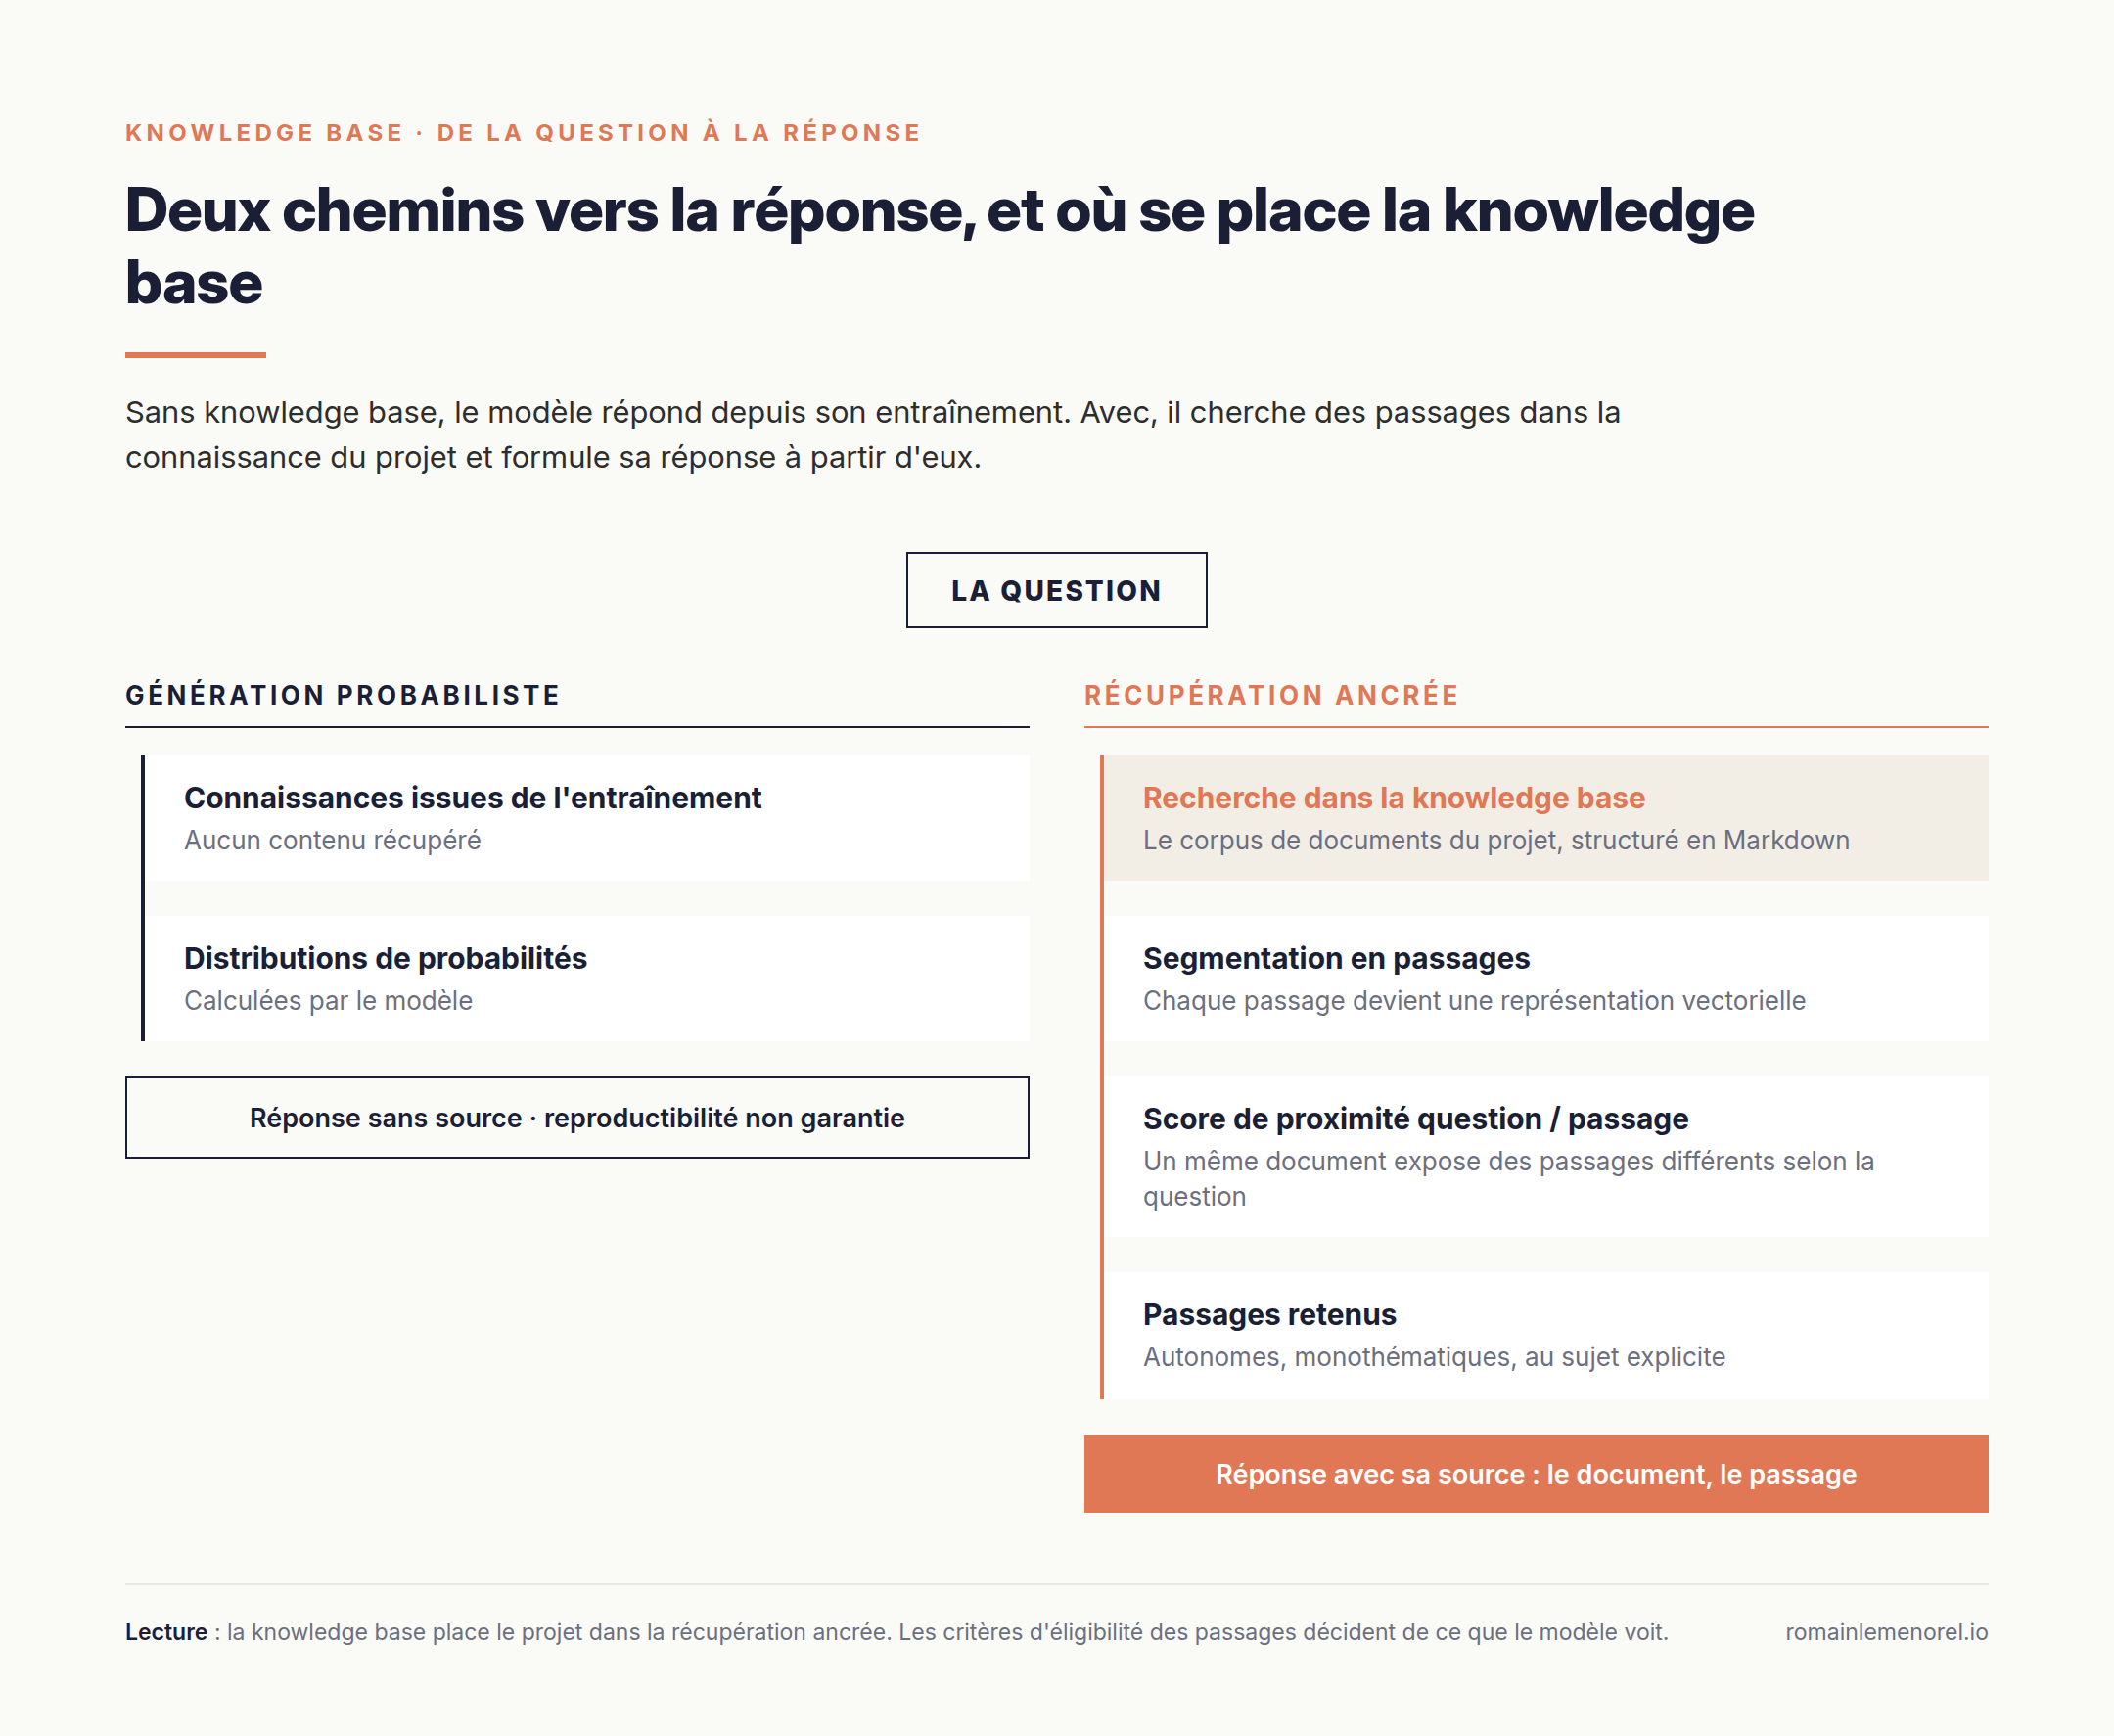
Vous l'aurez compris, la knowledge base correspond bien au premier cas présenté, à savoir la récupération ancrée. C'est l'ensemble du contenu que vous servirez au LLM pour qu'il y retrouve les réponses dont il la besoin pour répondre correctement et qualitativement aux problématiques soumises. Plus votre knowledge base est complète et bien structurée, plus le LLM pourra améliorer son efficacité globale à vous répondre.
Il faut savoir que la knowledge base agit directement sur la capacité du projet du LLM, qui désigne sa capacité maximale à traiter de l'information et selon Anthropic, cette capacité du projet est multipliée par 10 quand le seuil est atteint, pour les utilisateurs ayant un compte payant. Vous l'aurez probablement compris, elle requiert une optimisation pour que son impact soit augmenté et nous verrons justement comment y arriver.
Les deux régimes du projet
Pour mieux comprendre ce fonctionnement des projets sur Claude, il faut bien distinguer les deux régimes qu'il propose. Le poids de votre knowledge base décide du régime.
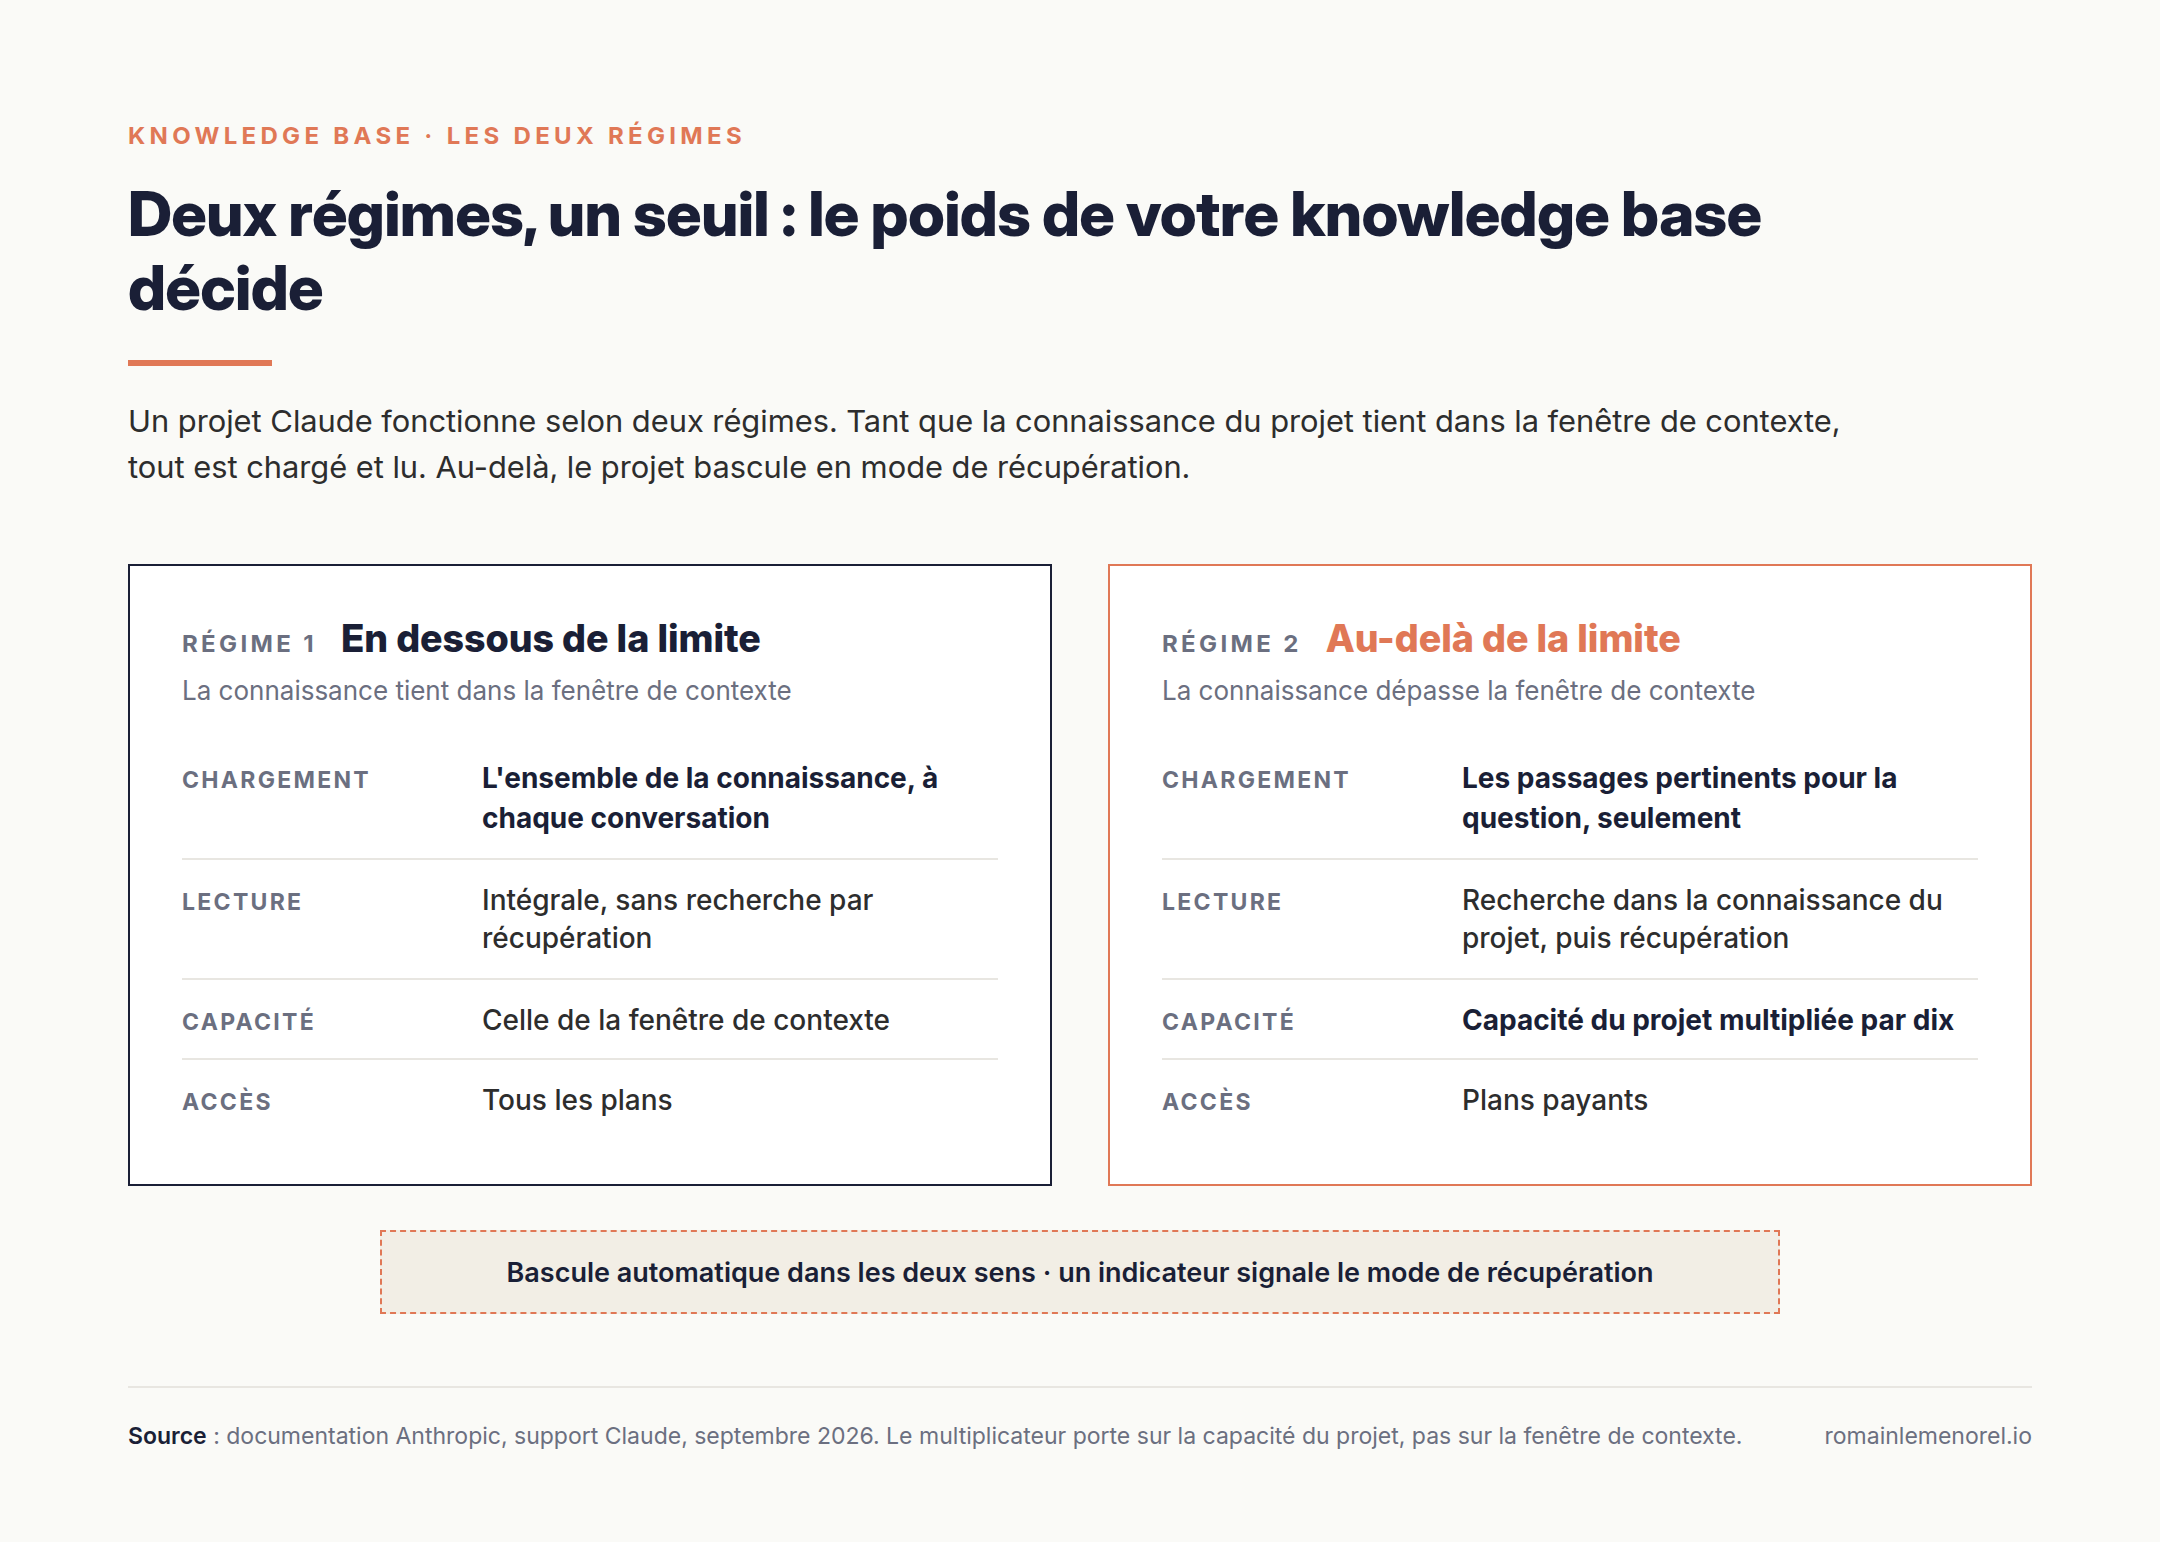
En dessous de la limite, la connaissance du projet tient dans la fenêtre de contexte et l'ensemble de la connaissance du projet est chargé à chaque conversation. Le modèle peut donc lire l'ensemble sans procéder à une recherche par récupération.
Quand la limite est dépassée, le second régime est lancé sur les plans payants et le projet ouvre un mode de récupération permettant au LLM de chercher de l'information sur le principe expliqué plus haut. De cette façon le projet dispose d'une capacité multipliée par dix et peut accueillir des projets de plus grand envergure.
On ne va pas se mentir : les projets d'audit peuvent être conséquents et la limite sera souvent atteinte. C'est la raison pour laquelle l'accès à l'information doit être optimisé car quand le modèle doit chercher, la knowledge base s'optimise au même titre que vos pages web.
On peut enfin constater que ce fonctionnement se rapproche fortement de la recherche classique avec plusieurs phases successives : indexation, recherche et score de pertinence.
Les 4 contextes de récupération
Pedro Dias, dans son article Filed Under Marketing. Sitting in the Wrong Room, distingue 4 contextes de récupération et la knowledge base appartient à l'un d'entre eux.
- Les crawlers classiques tels que Googlebot qui indexent pour la recherche organique
- Les pipelines RAG, la catégorie que je propose de voir ici
- Les agents, la nouvelle catégorie de bots qui simule la navigation d'un utilisateur
- Les bots d'entraînement, ceux qui parcourent le web pour alimenter la connaissance globale des modèles LLM
C'est la catégorie des pipelines RAG (« génération augmentée par la recherche ») qui nous intéresse ici car ce qui définit le pipeline RAG, c'est l'analyse de contenus pour répondre à une question en temps réel. Un mécanisme de récupération sur des contenus s'opère et sert à formuler la réponse. On est donc bien à l'opposé de la réponse instantanée, tirée de l'entraînement, sans phase de récupération.
La knowledge base est donc un pipeline RAG mais à l'échelle d'un projet, en local, et non à celle du web. Le principe est le même à la simple différence que vous avez la main sur votre projet. L'optimisation dépend donc entièrement de votre structure de knowledge base et de la façon dont vous placez les informations clés.
Qu'est-ce que la mémoire de projet ?
Au sein d'un même projet, Claude dispose aussi d'une mémoire qui survit entre les différentes conversations d'un projet. Cette mémoire est totalement indépendante de la knowledge base et représente ce que le modèle a retenu des échanges. Elle est spontanée, sans validation ni structure imposée par l'utilisateur. La knowledge base, par opposition, contient l'ensemble des informations qui nécessitent d'être récupérées quand elles ne sont plus dans la mémoire du modèle.
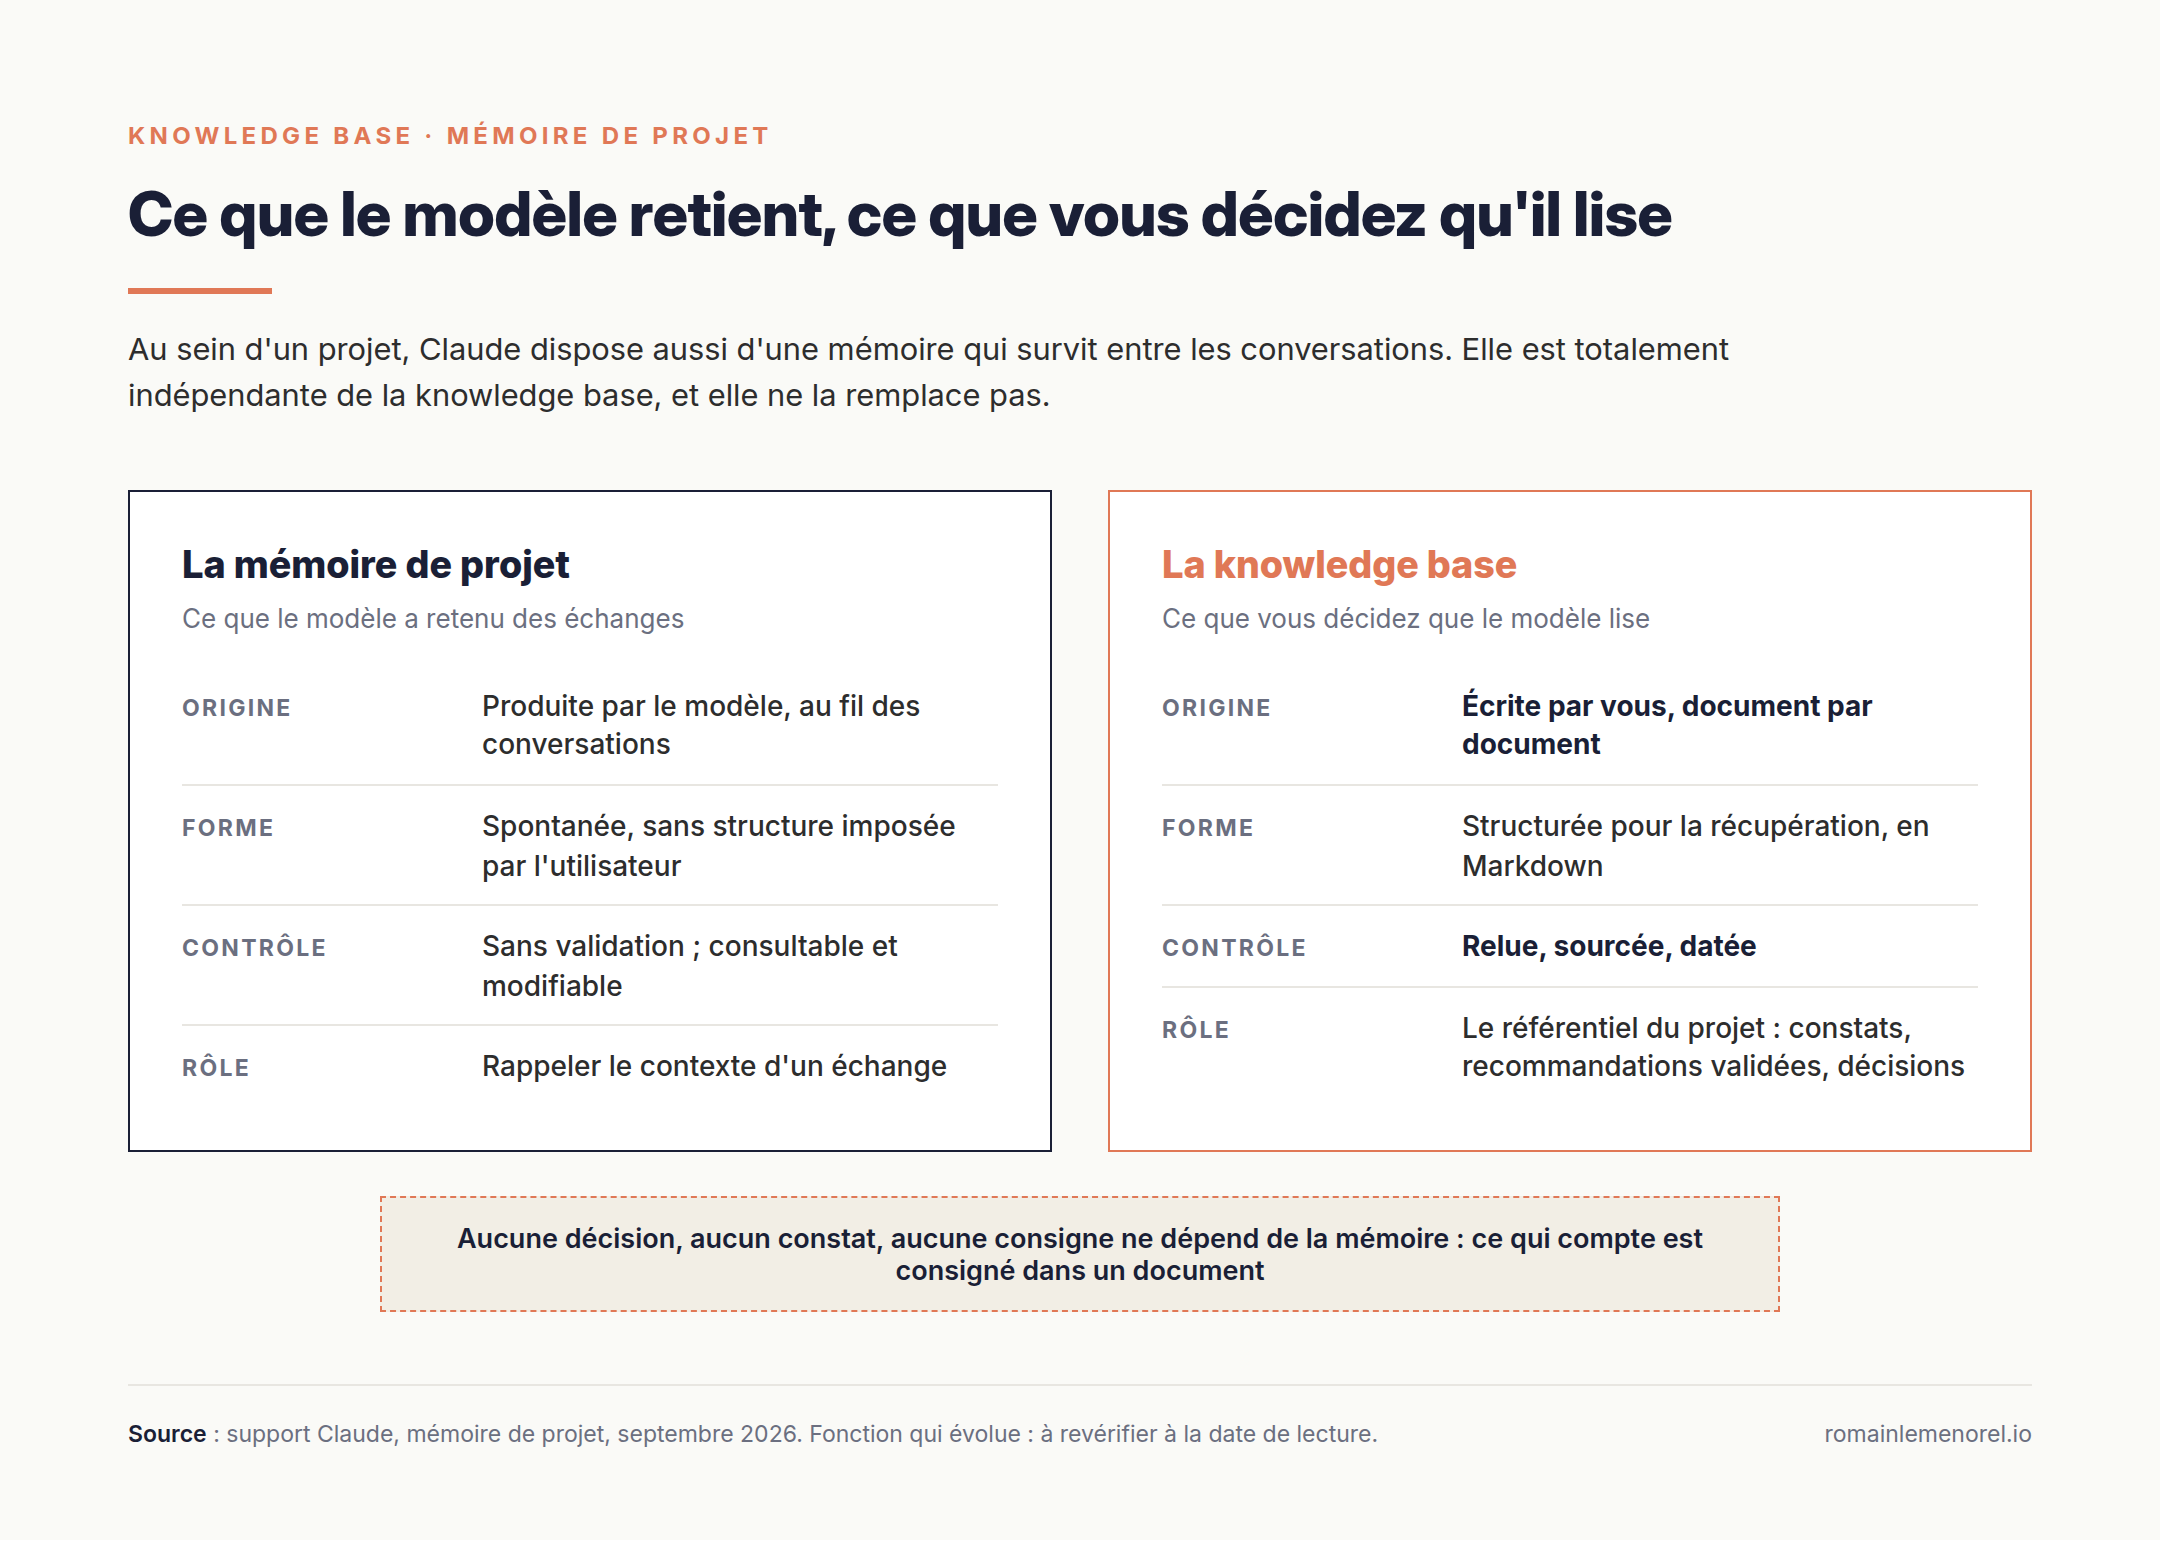
La knowledge base est donc l'endroit où vous placez les informations clés issues de vos échanges et analyses. Dans le cadre de l'audit stratégique, vous y placerez les principaux constats, les recommandations validées ou encore les décisions prises à chaque étape du projet.
Que doit-on mettre dans la knowledge base ?
La question qui peut se poser dès le départ est que mettre dans cette knowledge base au lancement d'un projet.
Ce qu'il faut bien comprendre, c'est que le LLM a accès aux données publiques sur lesquelles son crawl est permis, il peut donc récupérer l'ensemble des données publiques à tout moment.
Ce que la knowledge base doit contenir n'est donc pas d'abord la donnée publique mais la donnée qui n'est pas disponible sur le web. C'est le cas également de la donnée issue d'expérience personnelle ou de l'expertise acquise. Aucune de ces informations n'est disponible par une recherche web et c'est là qu'entre en jeu la knowledge base.
On peut distinguer 3 types de données :
- Les informations non publiques : toutes les sources que l'on ne peut retrouver sur le web et auxquelles le LLM n'aura pas accès dans son entraînement ou lors d'une recherche en direct.
- L'expertise métier : on parle ici de toutes les informations qui couvrent la spécialisation liée au projet, on y inclut aussi tous les apprentissages que l'on ne peut retrouver sur le web.
- Les choix et les décisions prises : il s'agit de vos choix stratégiques qui ne sont pas des données partagées publiquement.
Ce qui caractérise la knowledge base est donc la donnée spécifique qu'elle contient face aux données publiques du web et de la connaissance des modèles de langage.
C'est cette connaissance accumulée qui est la base de la performance de ces projets.
Un point important est que chaque information posée dans la knowledge base doit l'être en contenu extrait et non sous forme de bibliographie de liens externes. La récupération depuis un lien placé dans la knowledge base ne permet pas d'en récupérer l'intégralité, la page serait lue comme un texte aplati sans structure ni scripts.
Enfin, la source des informations doit rester précisée sur chaque document afin que celle-ci soit confirmée au moment de son usage. Sans ce réflexe, une information peut devenir obsolète car une information sans source ne peut plus être revalidée. Ce sont des détails d'écriture qui comptent.
Pour mieux comprendre, voici un schéma récapitulatif de la question à la réponse et où se place la knowledge base dans ce processus.
La mécanique de la récupération
Nous avons vu ce qu'est la knowledge base et je propose maintenant d'approfondir la notion de récupération. L'idée est de comprendre comment le LLM interagit avec votre knowledge base, cela peut vous aider à mieux appréhender comment celle-ci doit être structurée. Tout sera plus clair au moment où l'on définira une structure type pour votre projet que je vous propose en onze documents clés.

Parmi ces étapes clés de la récupération, on y retrouve la segmentation (chunking), où le système de récupération découpe le contenu en passages, car on peut s'en douter, le texte n'est pas conservé dans son intégralité et celui-ci finit en extraits où chacun de ces passages devient une représentation vectorielle, c'est la phase d'embedding.
Chaque embedding est analysé et les plus proches de la question de l'utilisateur servent à former la réponse. Ce score mesure un niveau de proximité entre une question et un passage et un document peut exposer plusieurs passages. Le passage qui parvient à répondre seul à la question gagne en pertinence. C'est la raison pour laquelle l'autonomie d'un passage compte beaucoup.
3 critères d'éligibilité d'un passage influencent sa récupération par les modèles :
- Le passage doit être autonome : il doit pouvoir être compréhensible sans le reste du contenu
- Le sujet représenté par le passage doit être clairement identifié et explicité
- Le passage doit rester monothématique
On déduit de ces trois critères d'éligibilité liés à la structure du contenu. La récupération est fortement influencée par la hiérarchie du contenu, les marqueurs de priorité que l'on attribue aux passages importants du texte.
Ces règles assez simples facilitent la récupération du passage par le LLM.
Pour en revenir à la knowledge base, il faut savoir que cette récupération fera l'objet des mêmes exigences mais la spécificité est qu'elle se fera par le format Markdown. On reviendra sur ce format dans un article dédié et qui est l'un des pivots de fonctionnement d'une knowledge base. Ce format n'est pas imposé, c'est celui que je recommande dans la pratique et celui qu'un projet Claude porte le plus facilement.
Le Markdown propose justement un système de balisage simple et structuré qui favorise la hiérarchisation des informations. C'est précisément ce qu'on recherche : faciliter la récupération des informations clés.
La structure type d'une knowledge base
Je vous propose maintenant une structure type de knowledge base en onze documents. Bien entendu cette structure peut être ajustée selon la nature de votre projet, je l'ai réfléchie pour qu'elle soit complète, facile à maintenir tout au long du projet et enfin pour qu'elle soit optimale pour la récupération par le LLM.
Cette structure doit être pensée selon votre projet, il ne faut surtout pas noyer votre knowledge base de documents inutiles ou obsolètes.
J'illustre ci-dessous une structure d'exemple de knowledge base :
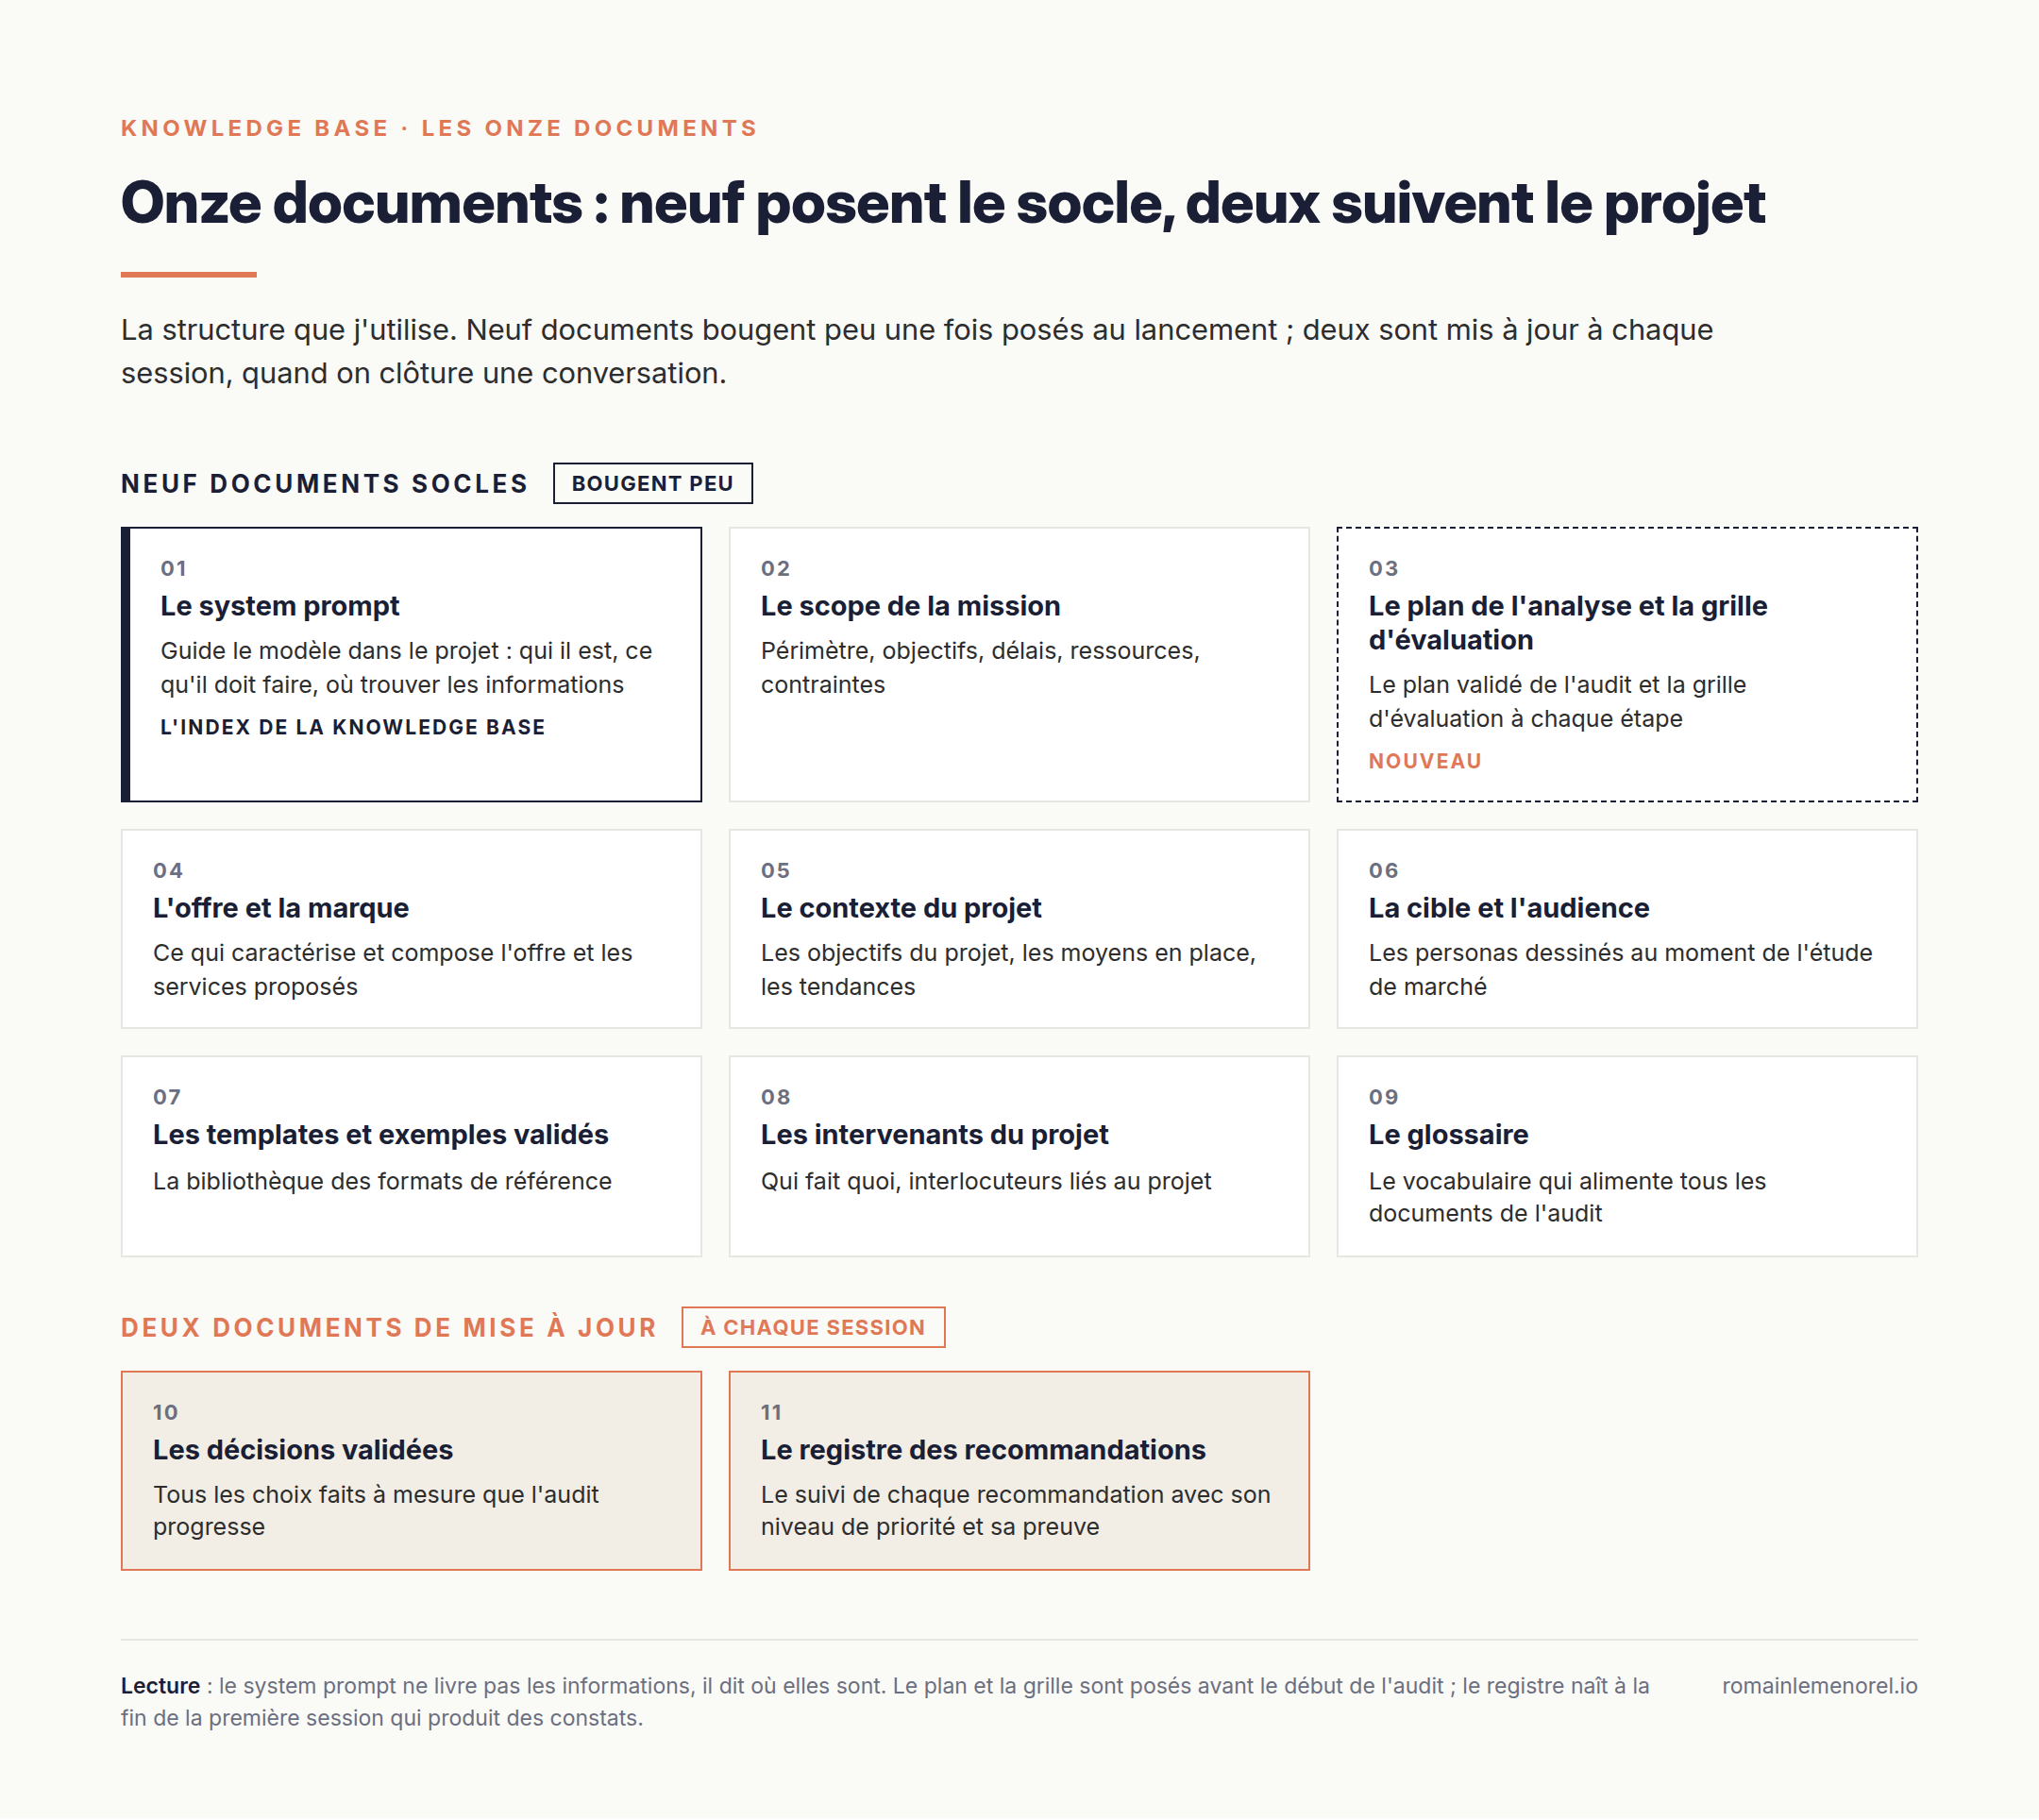
Dans cette série de documents, neuf documents bougent peu une fois bien documentés au lancement. Ils servent de socle au projet. Deux sont réservés à une mise à jour fréquente généralement en fin de session de travail, quand on clôture une conversation.
Les neuf documents socles :
- Le system prompt
- Le scope de la mission
- Le plan de l'analyse et la grille d'évaluation
- L'offre et la marque
- Le contexte du projet
- La cible et l'audience
- Les templates et exemples validés
- Les intervenants du projet
- Le glossaire
Et les deux documents de mise à jour :
- Les décisions validées
- Le registre des recommandations
Ce qui est essentiel dans cet exemple et qui revient dans chaque cas, c'est le « system prompt » qui cadre l'ensemble du projet. Ce document est rarement mis à jour et fournit les consignes globales de la knowledge base, c'est un peu comme un index de sitemaps, il ne livre pas lui-même les informations mais sert à dire où elles sont. Il oriente le LLM au bon endroit, son rôle est probablement le plus important.
Les instructions du projet dans Claude
Ce qu'il faut savoir sur le system prompt, c'est qu'il doit se placer dans le champ instructions du projet Claude. Cette section est ce que le modèle va lire avant toute récupération dans la knowledge base. Il peut être doublé d'un fichier d'index placé dans la knowledge base. Le rôle de chaque document y est précisé afin que le modèle détermine quel document doit être consulté selon les besoins.
C'est par ce biais que la grille d'évaluation et la méthode à chaque pilier sont transmises.
Les instructions précisent simplement où se trouve l'information dans la knowledge base et cette grille s'impose au modèle dans le déroulement de l'audit.
C'est précisément dans ce sens que la knowledge base joue un rôle majeur dans la procédure appliquée. Sans ces conditions, le cadrage serait manqué et vos analyses ne porteraient plus votre expertise.
Cette structure est donc pensée pour proposer un socle de fichiers stables qui bougent peu et des fichiers servant davantage à consigner les avancements du projet.
Le scope de la mission
Le cadrage de la mission qui précède les dix étapes de l'audit stratégique passe par ce document qui définit les contours du projet sur plusieurs aspects :
- Le périmètre de la mission, à savoir les domaines, les marchés cibles, les langues ou encore les leviers qui portent la priorité du projet.
- Les objectifs qui donnent les indicateurs de succès de la mission
- Les délais qui posent un jalon et une date de restitution au projet
- Les ressources qui définissent les équipes opérationnelles, les outils à disposition et les moyens du projet pour mener sa mission à bien.
- Les contraintes en dernier qui rappellent les limites connues et assumées du projet aussi bien sur le plan technique, légales, éditoriales ou même business que le projet met à l'écart dès le lancement du projet.
Ce document se prépare dès le début du projet et change que rarement si le projet l'impose ou si une évolution survient après le lancement.
Le plan de l'analyse et la grille d'évaluation
Je fais un focus sur ce document qui se construit aussi au lancement avant le lancement de l'audit. Ce document pose le plan de l'audit et la grille d'évaluation à chaque étape.
On y place le plan validé qui peut suivre une structure générique ou bien plus personnalisée si le projet pose un périmètre plus resserré.
On y valide donc les piliers d'analyse dont ceux qu'on a présentés dans l'audit :
- JavaScript et accessibilité
- Arborescence et maillage
- Contenu et fan-out
- UX et conversions
- EEAT et autorité
- Autorité off-site
À ces piliers peuvent s'ajouter des leviers moins systématiques :
- Stratégie internationale (traduction, approche marché, duplication)
- Stratégie locale (store locator, annonces en ligne, emploi)
- Flux shopping (pour tous les sites e-commerce éligibles)
A chaque levier d'analyse validé, on y valide une grille d'évaluation qui reprend vos critères par défaut (c'est ici que votre expertise se pose) et les spécificités en regard du projet.
En effet, selon la thématique du projet certains critères ne s'abordent pas de la même façon.
Au dernier niveau, vous définissez la méthodologie exacte pour les éléments de la grille les plus complexes à approcher.
Le registre des recommandations
Le registre des recommandations peut arriver plus tard et sa création arrive à la fin d'une première session ayant abouti à des tâches. C'est ici que vous positionnez les entrées et le but de ce document est de ne perdre aucune trace des constats et analyses que vous avez faits.
Chaque constat et recommandation y entrent, et restent soumis à validation avant la roadmap définitive.
Dix champs sont attribués à chaque entrée : constat, preuve, pilier, gabarit, verbe d'action, priorité, effort, horizon, dépendance et état.
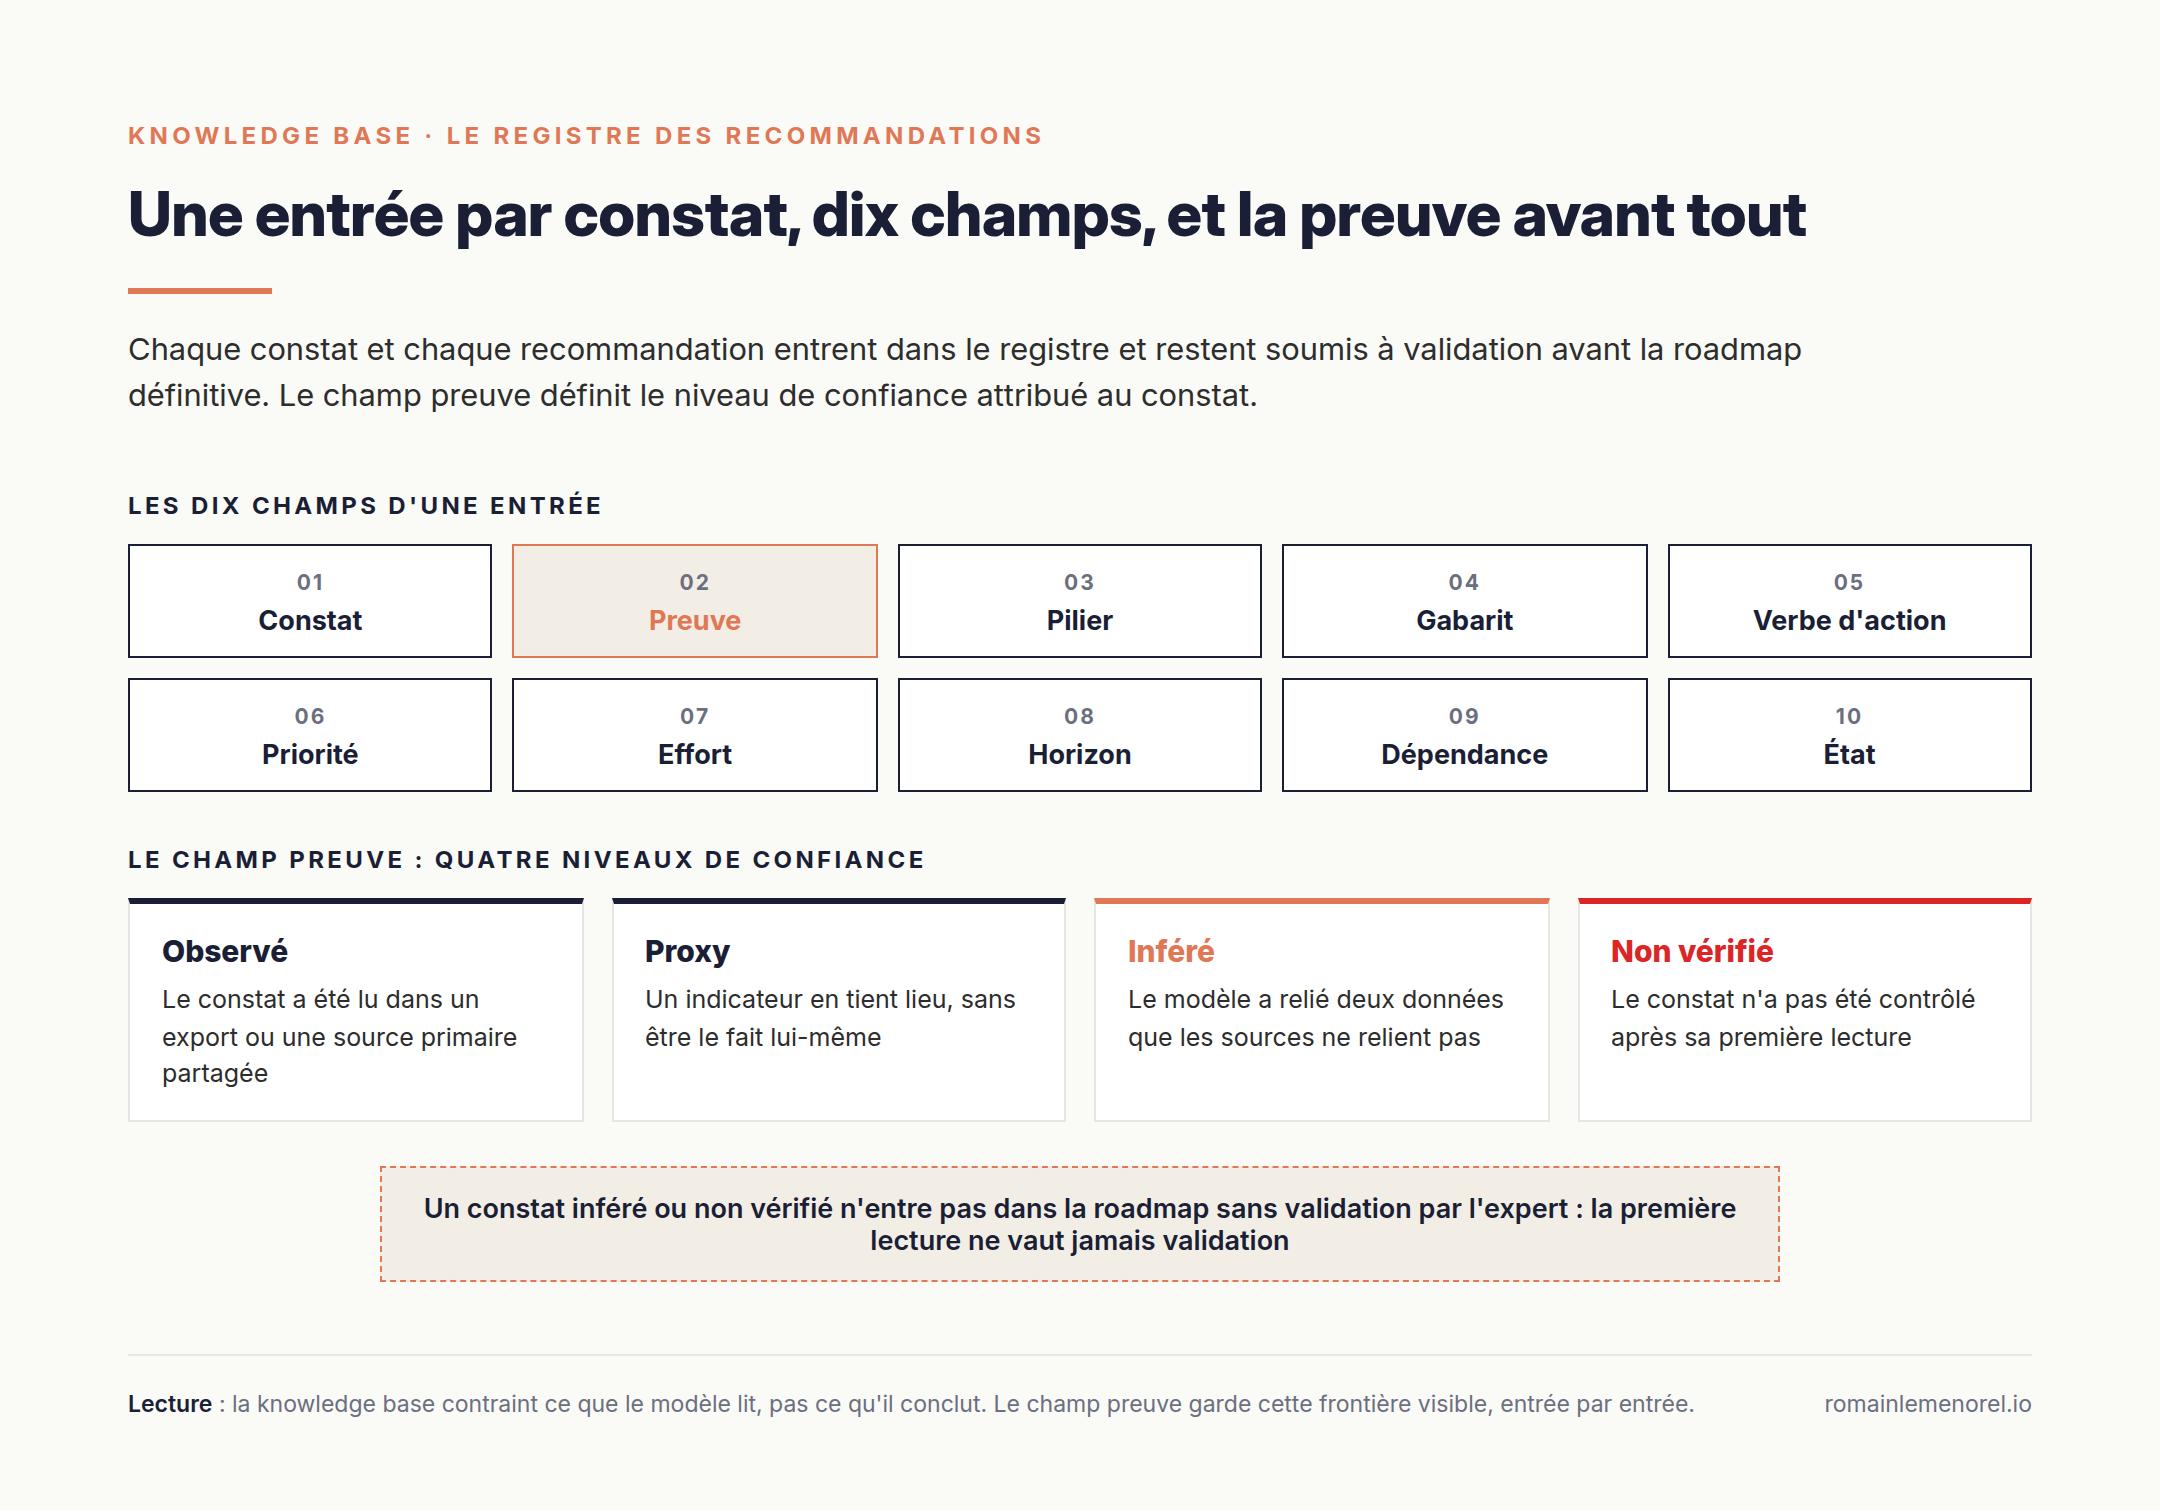
Le plus important est la preuve qui définit le niveau de confiance attribué au constat :
- Observé : le constat a été lu dans un export ou une source primaire partagée
- Proxy : un indicateur clé a posé le constat
- Inféré : un lien a été établi entre deux données des sources d'analyses
- Non vérifié : le constat n'a pas été contrôlé après sa première lecture
Cette méthode appliquée rigoureusement assure une roadmap pertinente et maîtrisée. Elle permet aussi de ne rien perdre pendant le déroulement de l'audit et de mieux prioriser sa roadmap finalisée.
Le cycle de la knowledge base
Une knowledge base évolue avec le projet. Elle ne se construit pas en une seule session et doit faire l'objet d'un travail sur le moyen et le long terme. C'est à cette échelle que celle-ci prend tout son sens.
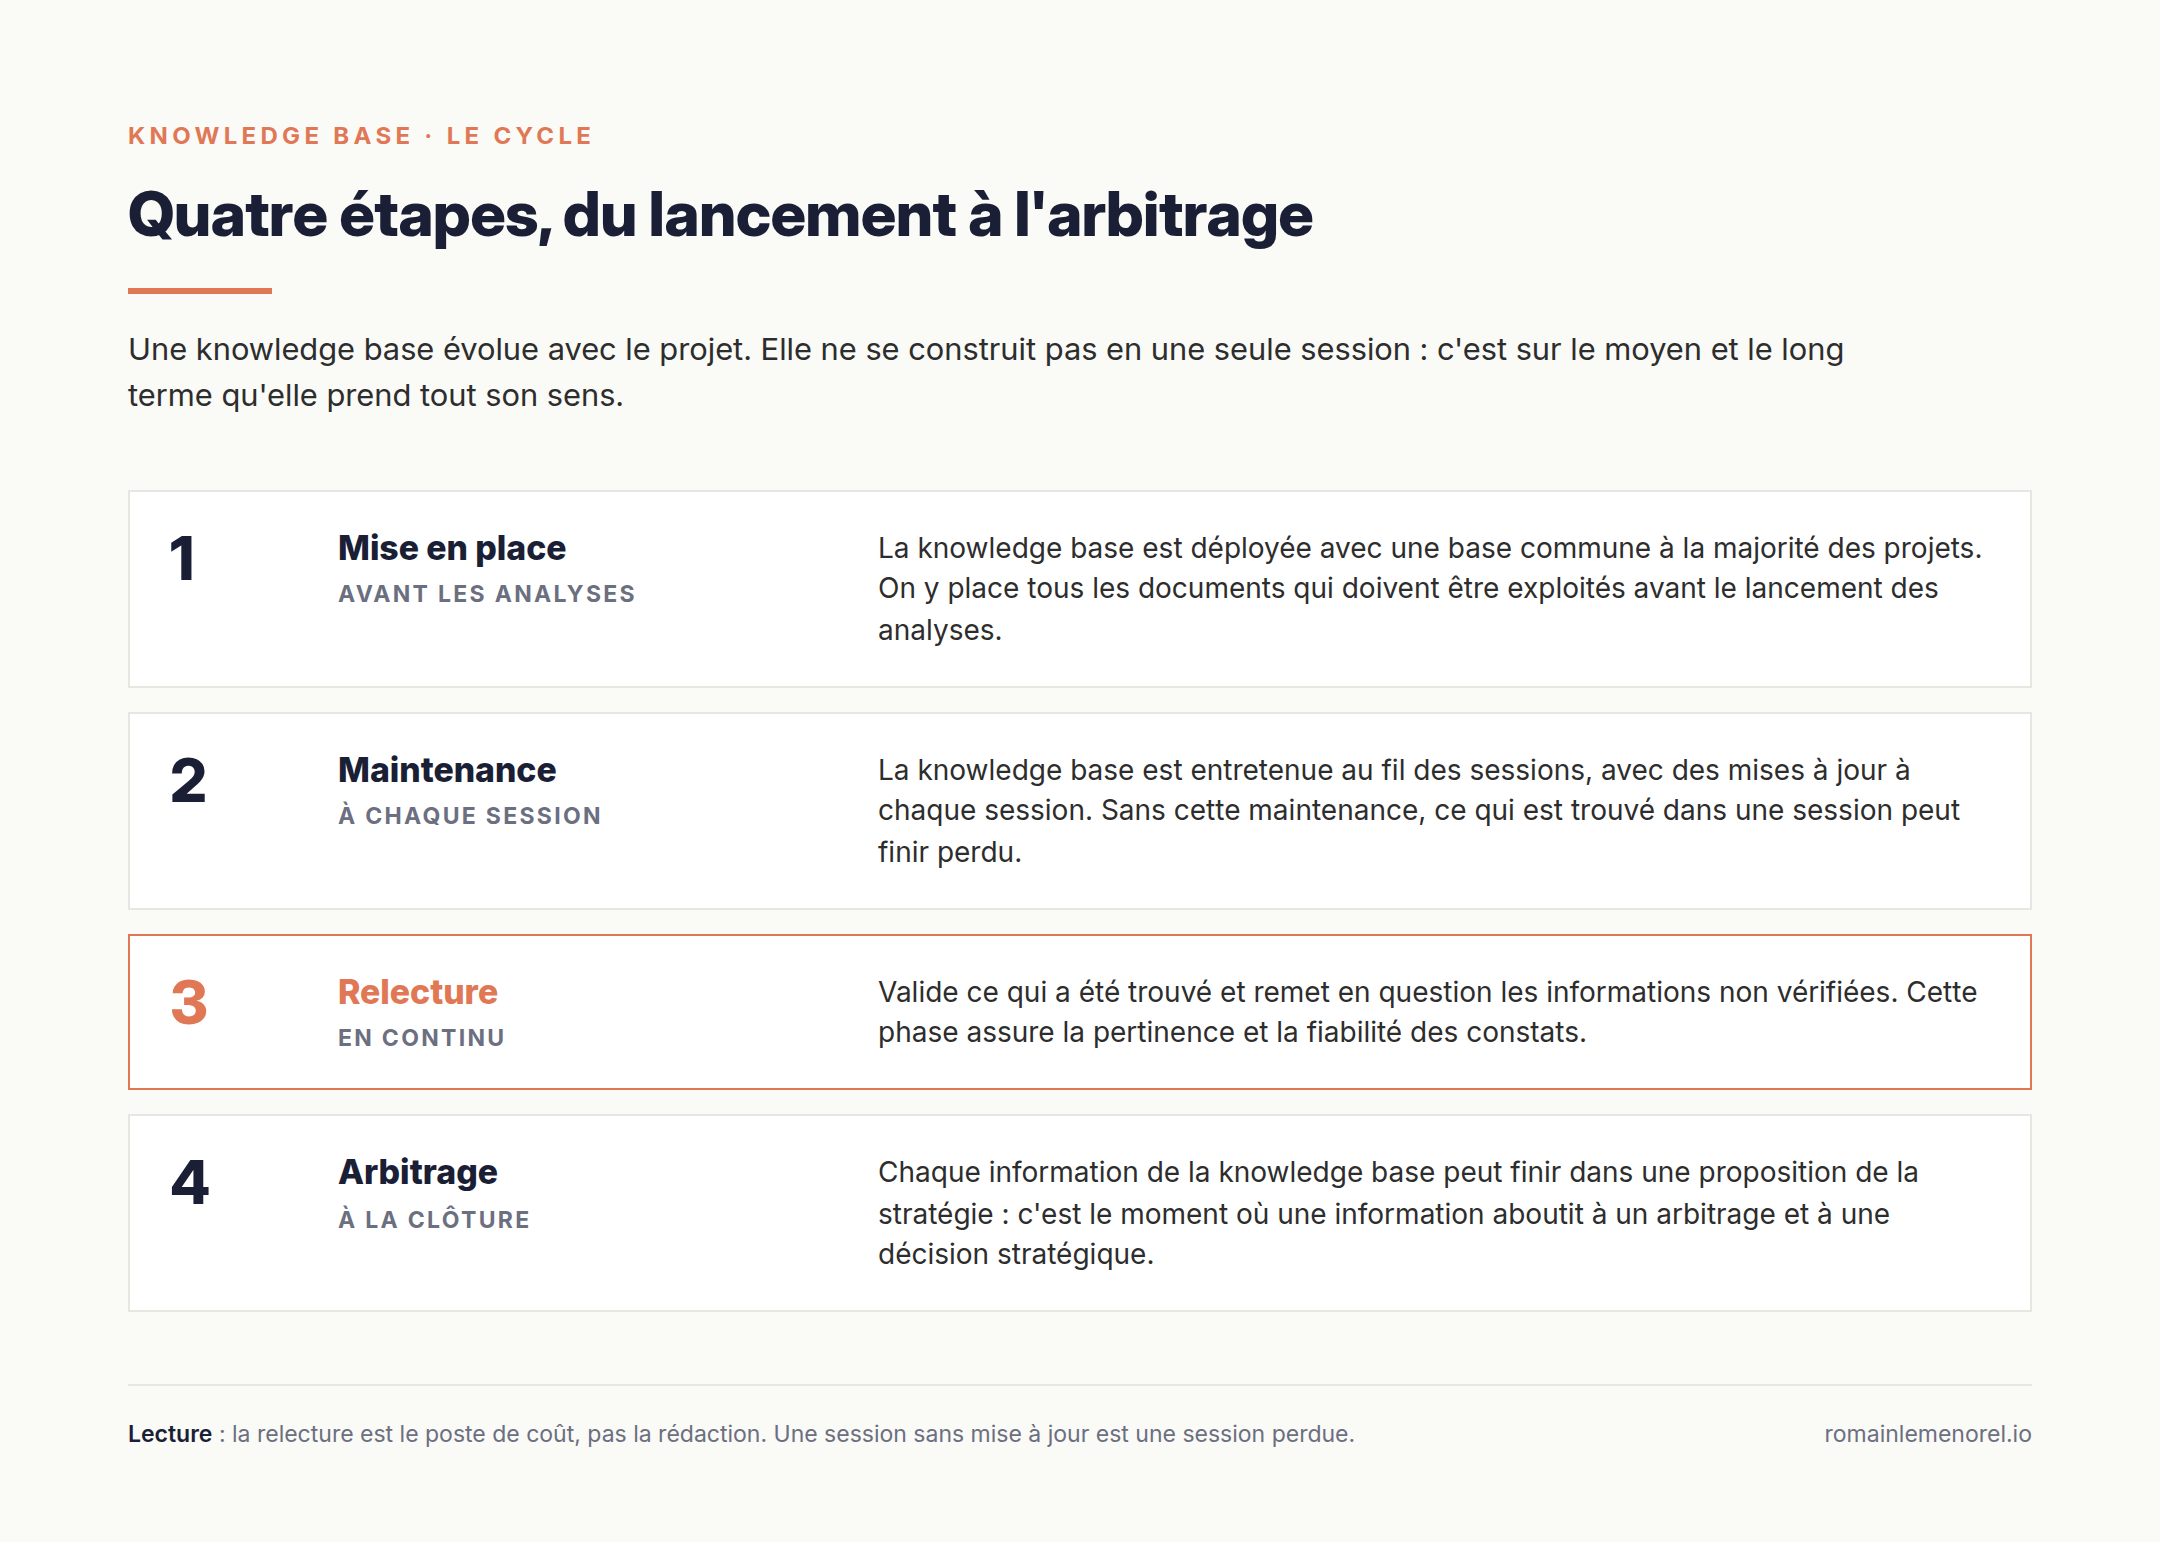
Je découpe ce mécanisme en 4 étapes :
- Mise en place : la knowledge base est d'abord déployée avec une base commune pour une majorité des projets. On va y placer tous les documents qui doivent être exploités avant le lancement des analyses.
- La maintenance : la knowledge base doit ensuite être entretenue au fil des sessions avec des mises à jour à chaque session. Sans cette maintenance, ce qui est trouvé dans une session peut finir perdu.
- La relecture : valide ce qui a été trouvé et remet en question les informations non vérifiées. Cette phase assure la pertinence et la fiabilité de vos constats.
- L'arbitrage : chaque information de la knowledge base pourra finir dans une proposition de la stratégie et c'est précisément à ce moment qu'une information abouti à un arbitrage et une prise de décision stratégique.
La maintenance en phase d'audit
En phase d'audit, on travaille la knowledge en trois temps :
- Le premier lot préparatoire qui forme le socle du projet
- Le placement des recommandations à chaque étape de l'analyse par pilier
- La phase de clôture et de validation
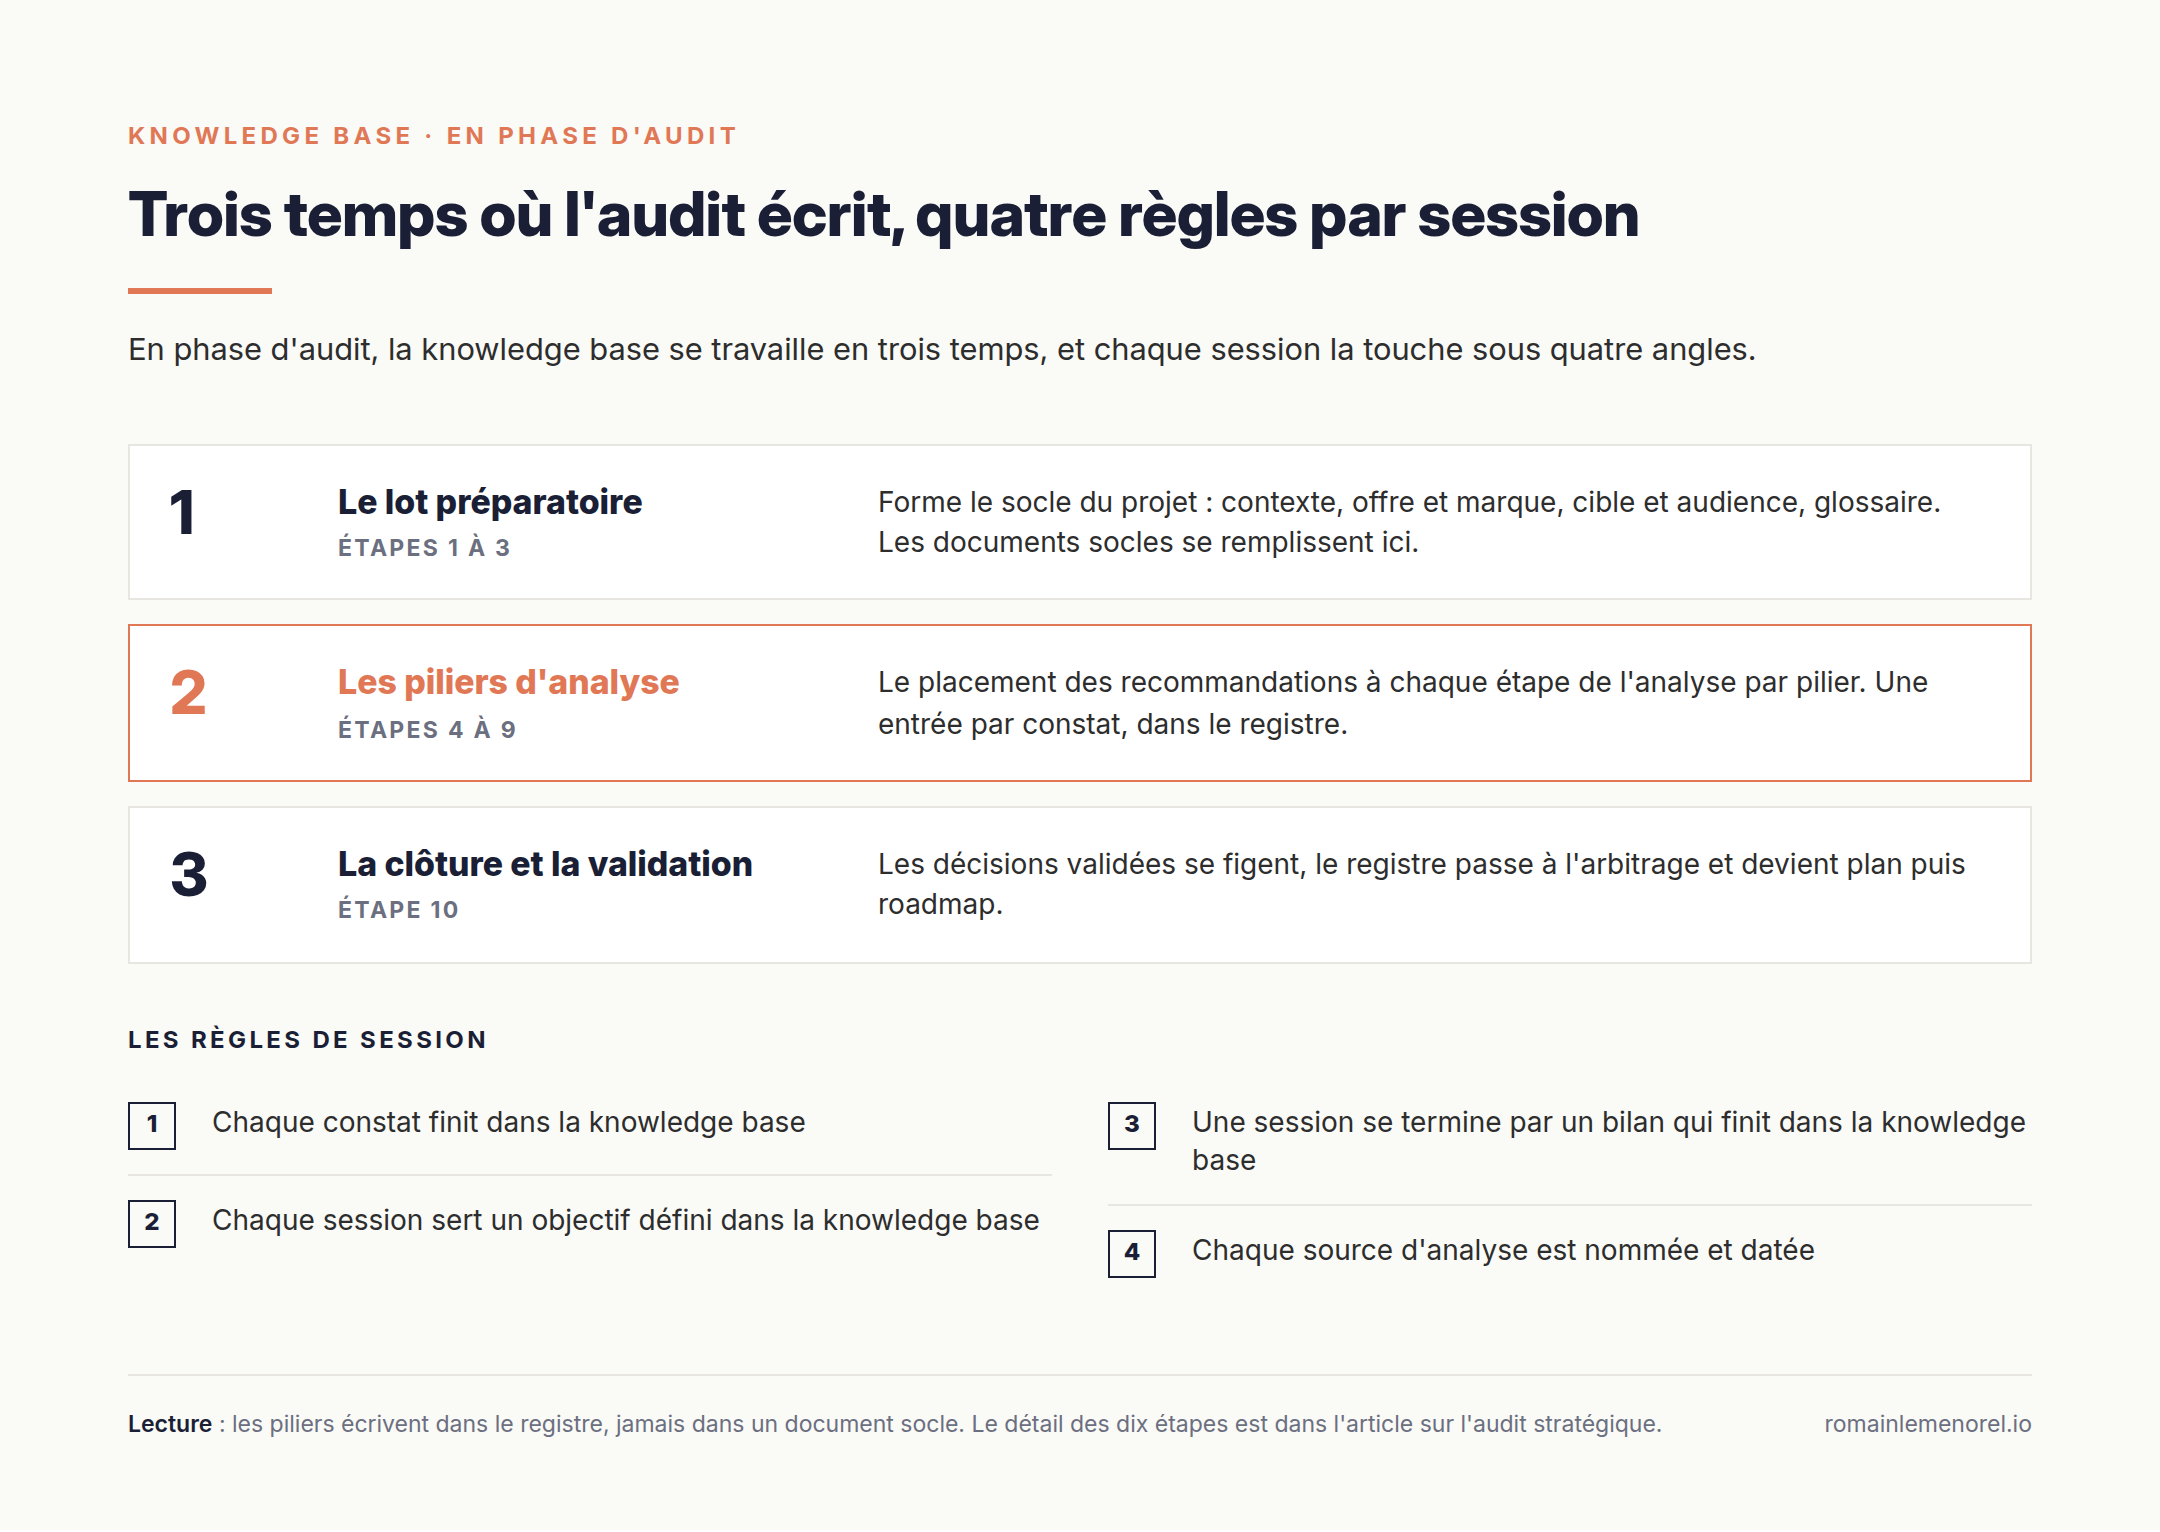
Les règles de session à maîtriser
Chaque session d'analyse affectera la knowledge base sous différents angles :
- Chaque constat finit dans la knowledge base
- Chaque session sert un objectif défini dans la knowledge base
- Une session se termine par un bilan qui finit dans la knowledge base
- Chaque source d'analyse est nommée et datée
Les cinq principes de formatage
Quelle que soit la structure mise en place et le nombre de fichiers que vous utiliserez, je propose 5 principes de formatage à respecter pour chacun des fichiers.
Ces principes font le pont avec les critères de récupération que nous avons vus précédemment.
- Des phrases et paragraphes autonomes : chacun porte son propre contexte et ne dépend pas du reste.
- Une hiérarchie Hn rigoureuse : même principe que l'on connaît bien en SEO classique appliqué ici dans un contexte assez proche.
- Des mises en avant explicites de priorités : les impératifs et interdits du projet doivent être bien mis en avant car ce sont les consignes à ne pas manquer.
- Utilisation des verbes d'action pour l'ensemble des instructions envoyées.
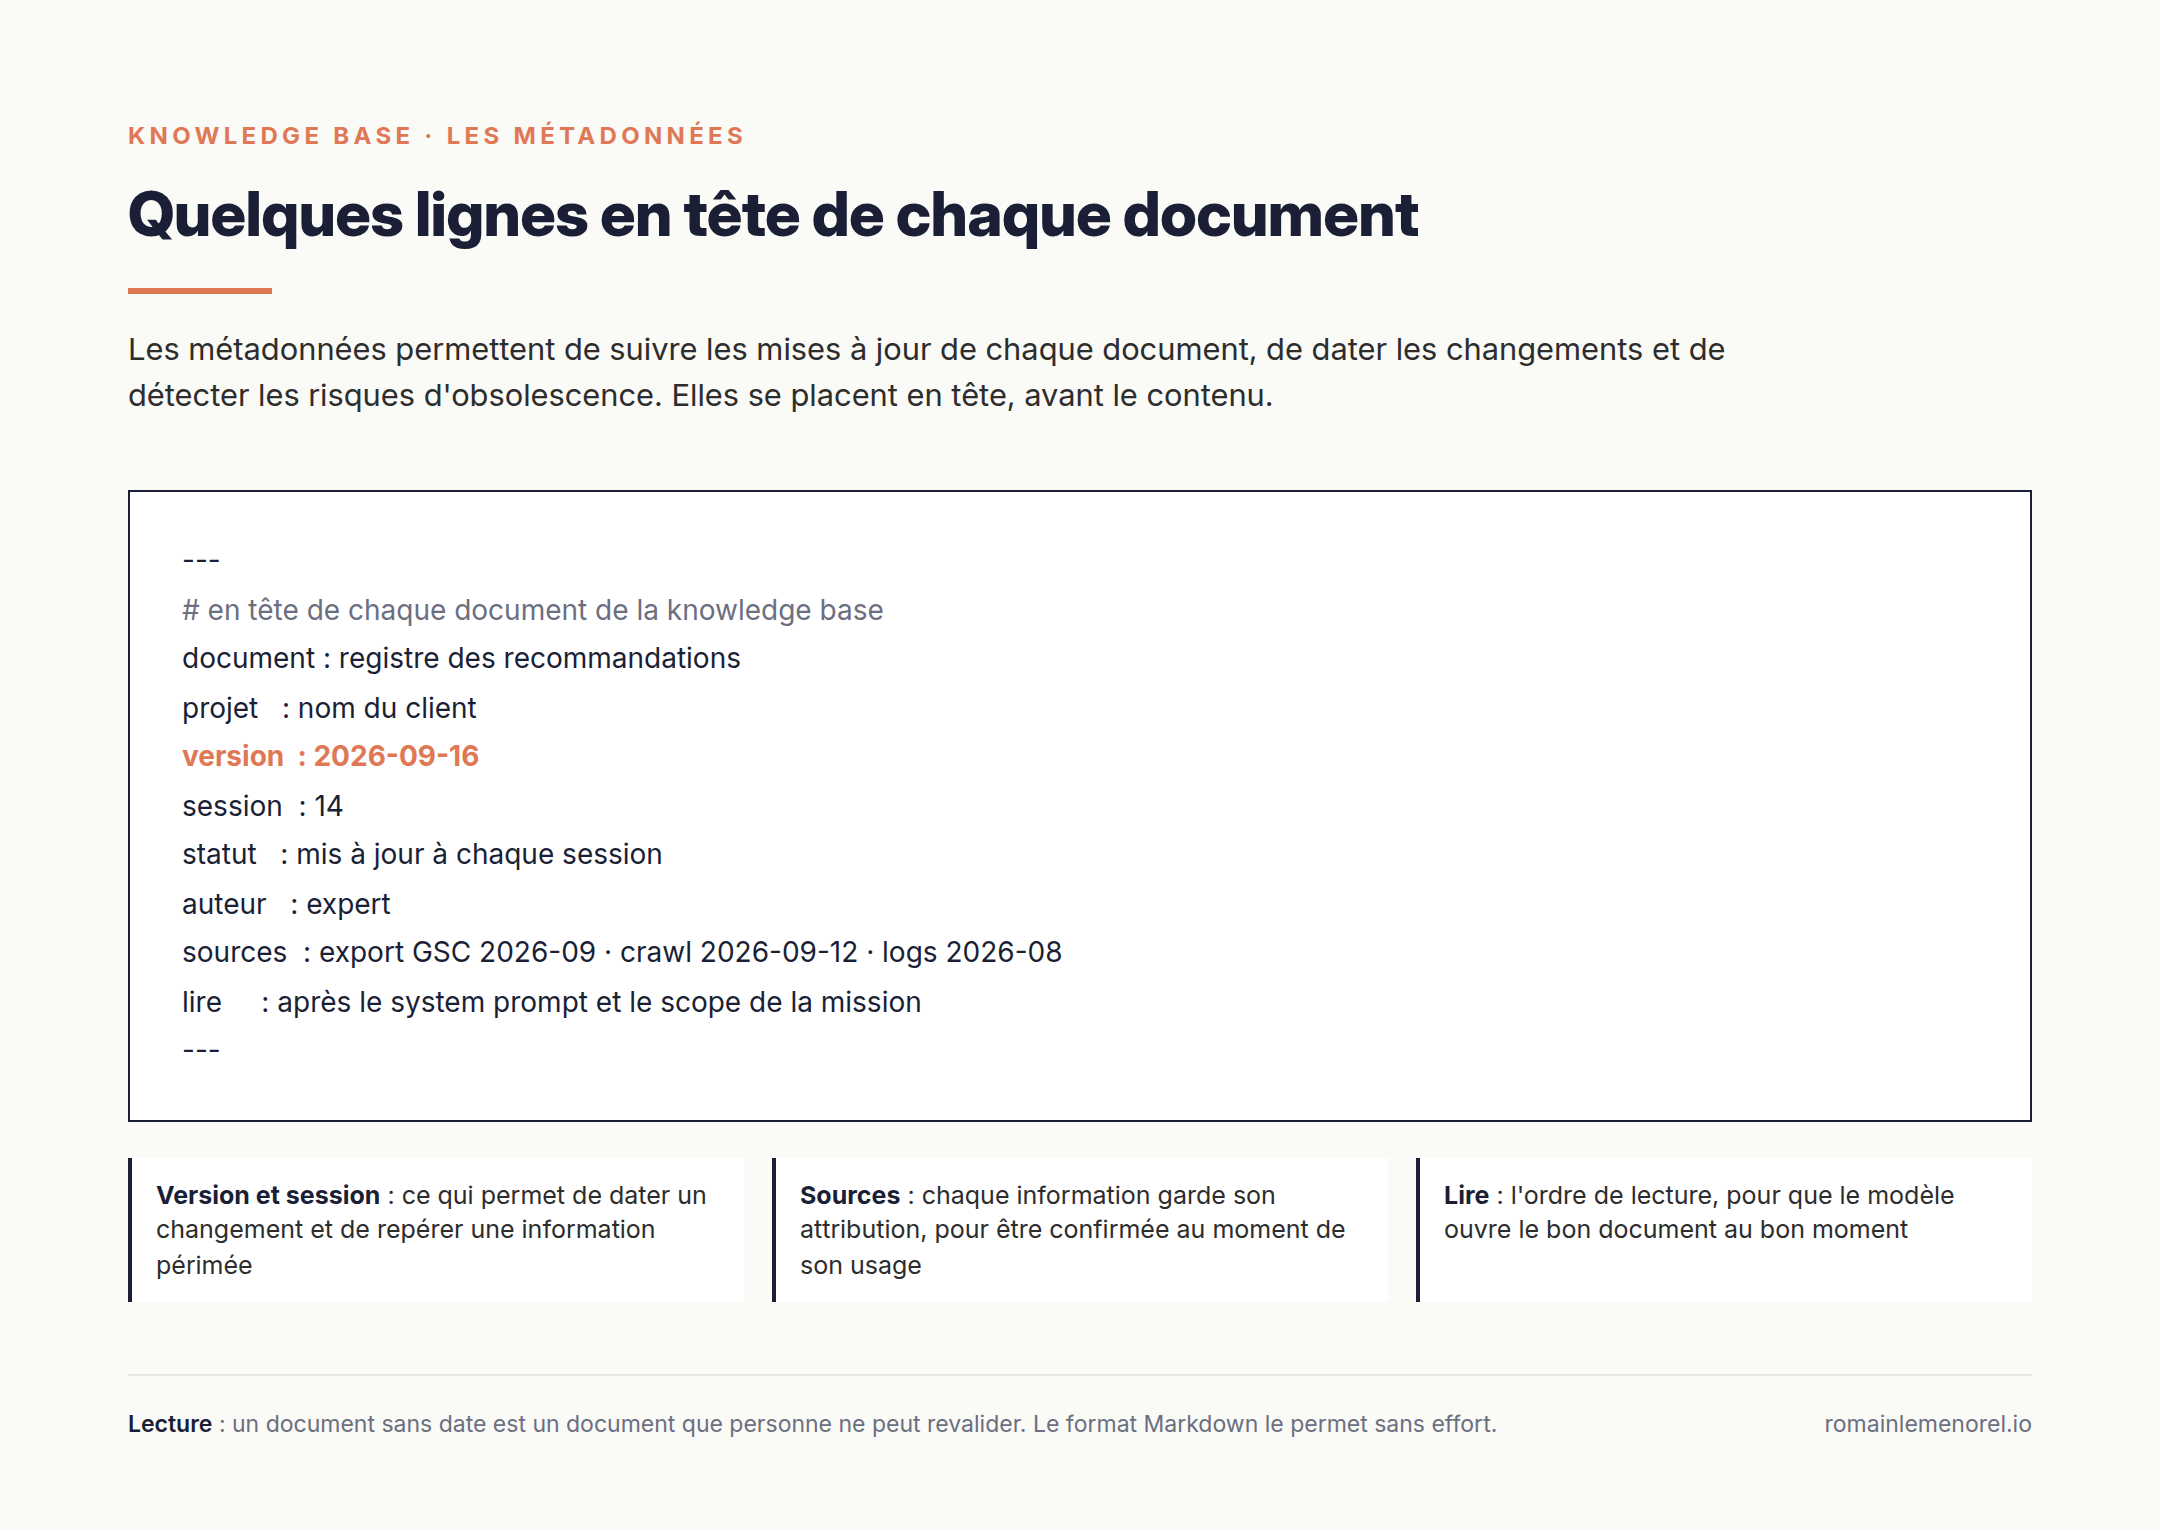
- Des métadonnées pour suivre les mises à jour de chaque document permettant de dater les changements effectués et de détecter les risques d'obsolescence.
Mes conseils sur l'optimisation de la knowledge base
Une optimisation faite pour l'IA avant tout
Le contenu de la knowledge base présente des directives à usage exclusivement interne à un projet, ils peuvent donc être alimenté de données non publiques et sa structure doit être pensée pour une lecture par une IA.
Attention à l'obsolescence des données
Si un projet dure plusieurs mois ou années, il doit être mis à jour. Placez des dates en tête de document pour annoter les dernières mises à jour. C'est à faire à chaque fin de session.
Il faut se rappeler que la knowledge base s'oppose sur ce point à la recherche sur le web, il faut donc être attentif au contrôle des informations qu'elle propose que le LLM peut utiliser sans vérifier la bonne conformité.
Aucune donnée ne peut être inventée par un modèle de langage, il peut simplement manquer ce qui a bougé et ne pas le remonter. Une information obsolète dans la knowledge base reste donc un risque d'erreur auquel on reste exposé.
Pour limiter ce risque, plusieurs méthodes à mettre en place :
- Dater chaque document et surtout chaque version
- Valider les changements apportés en fin de session
- Vérifier en priorité les données à risque fort d'obsolescence (tarif, taux, versions, offre)
Documenter ce qui est négatif
Ce qu'il ne faut pas faire est la consigne prioritaire. Je dirais même que cette consigne passe avant les impératifs.
Chaque erreur identifiée doit être documentée et consignée dans le fichier le plus approprié, généralement celui que le LLM doit impérativement lire avant toute exécution.
Le placement de cette information dépend de la nature de cette instruction selon la fonction de chaque document. Chaque document est lu dans un contexte spécifique et il faut donc anticiper dans quelle situation elle le sera.
La knowledge base se construit progressivement
Ne cherchez pas à proposer la knowledge base parfaite dès le début, c'est pratiquement impossible, ce sont les allers-retours et les sessions qui se cumulent qui forment la knowledge base.
On avance donc par étapes et on la développe à l'issue de chaque session de travail.
La knowledge base doit être constamment relue
Un article de Lily Ray intitulé The AI Slop Loop explique une mécanique dans laquelle l'intelligence artificielle récupère une information fausse provoquant des republications de cette même erreur sur diverses sources et quand cette information se répand suffisamment, elle finit par faire consensus et provoque une hallucination de l'IA.
Ce phénomène qui se produit massivement à l'échelle du web peut se produire aussi dans votre knowledge base.
3 règles très simples peuvent réduire ces risques :
- Chaque information doit être relue
- La source et la date des informations sont précisées
- Chaque source doit être validée en amont
Le rythme des mises à jour doit être régulier :
- En fin de session de travail afin d'en extraire tous les apprentissages
- Après chaque décision prise ou étape franchie sur le projet
- En période de révision (mensuelle ou trimestrielle)
Que peut-on retenir sur l'usage de la knowledge base ?
La knowledge base ouvre donc de nombreuses possibilités dans le travail avec l'intelligence artificielle.
C'est l'endroit du projet où toutes les informations et tous les apprentissages doivent être consignés.
Avec une rigueur d'optimisation, de structuration et de maintenance, la knowledge base vous permet de réaliser un travail de suivi très poussé que les outils classiques ne permettent pas.
Elle représente aussi ce sur quoi l'audit stratégique repose à chaque étape et même bien au-delà de ce dernier. On va poursuivre ensuite par le format Markdown que j'utilise pour alimenter la knowledge base avec un objectif d'optimisation et de productivité.
Ce n'est pas une pratique sans effort, elle requiert beaucoup de rigueur et de méthodologie mais les résultats qu'elle permet d'obtenir méritent qu'on s'y intéresse.