Context rot : gérer la fenêtre de contexte de vos projets IA
Vous travaillez sur des projets complexes et longs nécessitant de nombreux échanges. Vos conversations peuvent s'étendre sans parvenir à se conclure rapidement.
Quand cette situation arrive, l'interface de conversation peut le signaler et même effectuer un compactage qui apparait comme un simple chargement. Ce mécanisme traduit un autre problème que l'on ne perçoit pas toujours et qui affecte fortement la qualité du travail fait avec les assistants IA, on parle ici de la fenêtre de contexte.
La conséquence est simple, le modèle peut oublier des consignes importantes et répondre à côté. Votre projet est donc compromis par ce mécanisme qu'il faut gérer à chaque étape.
Je fais le lien avec l'audit stratégique que je réalise sur des projets Claude et qui nécessite des échanges longs et où les enjeux peuvent être importants.
Nous allons donc essayer de mieux comprendre ce mécanisme propre aux différents modèles de langage avec lesquels vous pouvez travailler et voir comment travailler sur vos projets avec la knowledge base en support pour éviter de subir cette limite qui peut compromettre la qualité du travail réalisé.
Résumé exécutif
- La fenêtre de contexte représente l'ensemble du contenu que le modèle lit afin de produire sa réponse. Cette fenêtre comprend l'ensemble des messages et des annexes partagés.
- À chaque message, le modèle relit l'intégralité de la conversation depuis son début. Un modèle ne mémorise pas un message précédent, il le relit.
- Avant même la limite atteinte, la qualité des réponses se dégrade. Ce phénomène entraine ce qu'on appelle le context rot qui est un mécanisme documenté depuis 2025.
- Une conversation mal optimisée favorise fortement ce dépassement et il peut survenir rapidement si des annexes lourdes sont transmises dès le début.
- Les différents modèles du marché ne gèrent pas cette fenêtre de la même façon et il est important de savoir comment elle fonctionne pour l'assistant que vous utilisez pour vos travaux.
- Gérer la fenêtre de contexte est une des pratiques qui s'intègre à ce travail de la knowledge base. De bonnes pratiques doivent être mises en place à chaque étape.
Sommaire
- Qu'est-ce que la fenêtre de contexte ?
- Comment la fenêtre de contexte se remplit à chaque tour ?
- Le context rot quand la limite de la fenêtre est atteinte
- La dérive du modèle sur les conversations longues
- La fenêtre de contexte sur les quatre systèmes IA du marché
- Quel impact sur votre routine de travail ?
- Ce qu'il faut retenir de la fenêtre de contexte
Qu'est-ce que la fenêtre de contexte ?
Avant de formuler une réponse à la question de l'utilisateur, le modèle lit, mais cette lecture ne se résume pas au prompt initial envoyé, elle intègre l'ensemble des annexes envoyées, des documents racine de la knowledge base, mais aussi des échanges qui se succèdent à chaque tour de conversation.
Vous l'aurez compris, la fenêtre de contexte représente précisément ce que le modèle est en mesure de lire à chaque tour de conversation.
Le comptage se fait en tokens
Pour délimiter la fenêtre de contexte, il faut compter en tokens, qui désignent des suites de caractères. Un token représente environ quatre caractères soit environ trois quarts d'un mot en anglais selon la documentation officielle d'Anthropic. Chaque contenu et même les annexes et les images se comptent à partir de cette unité de mesure.
La fenêtre de contexte est donc exactement une limite en token que le modèle est capable de consommer à chaque tour de conversation.
L'ensemble des échanges, y compris les réponses, comptent dans cette limite. La documentation d'Anthropic considère cette fenêtre comme la mémoire de travail de l'assistant.
Il ne faut pas la confondre avec l'entraînement du modèle.
Les trois types de mémoires qu'il ne faut pas confondre
Un modèle peut retrouver une information sur trois types de mémoire, ce qui joue, bien entendu, sur la fenêtre de contexte.
- La mémoire d'entraînement : c'est la mémoire que vous ne contrôlez pas et qui dépend de l'entraînement du modèle que vous utilisez. Les robots d'entraînement constituent ce corpus sur lequel les modèles font leur apprentissage
- La fenêtre de contexte : elle désigne ce que le modèle peut lire d'une conversation depuis le début. Quand la limite est atteinte, des informations peuvent se perdre et nous y reviendrons.
- La mémoire externe : c'est la mémoire qui est portée par la knowledge base ou le projet Claude que vous avez préparé. Elle est accessible au modèle, mais pas nécessairement lue à chaque tour de conversation.
Cette distinction situe donc bien la place de la fenêtre de contexte qu'il ne faut pas confondre avec ce que le modèle a appris dans son entraînement ou ce que votre projet lui apporte comme information en support.
À noter, la knowledge base dans Claude définit une limite qui évite de saturer la fenêtre. De cette façon, les projets Claude de taille importante ne sont pas lus entièrement à chaque tour.
Ce qui compte dans la fenêtre à chaque tour
La fenêtre de contexte comprend un ensemble d'éléments qui s'additionnent :
- Les instructions du système de l'éditeur
- Les instructions du projet
- La mémoire issue de vos conversations passées
- Les documents d'entrée du projet, chargés à chaque conversation
- Les recherches sur le web et les outils utilisés
- La phase de raisonnement du modèle
- Les réponses du modèle
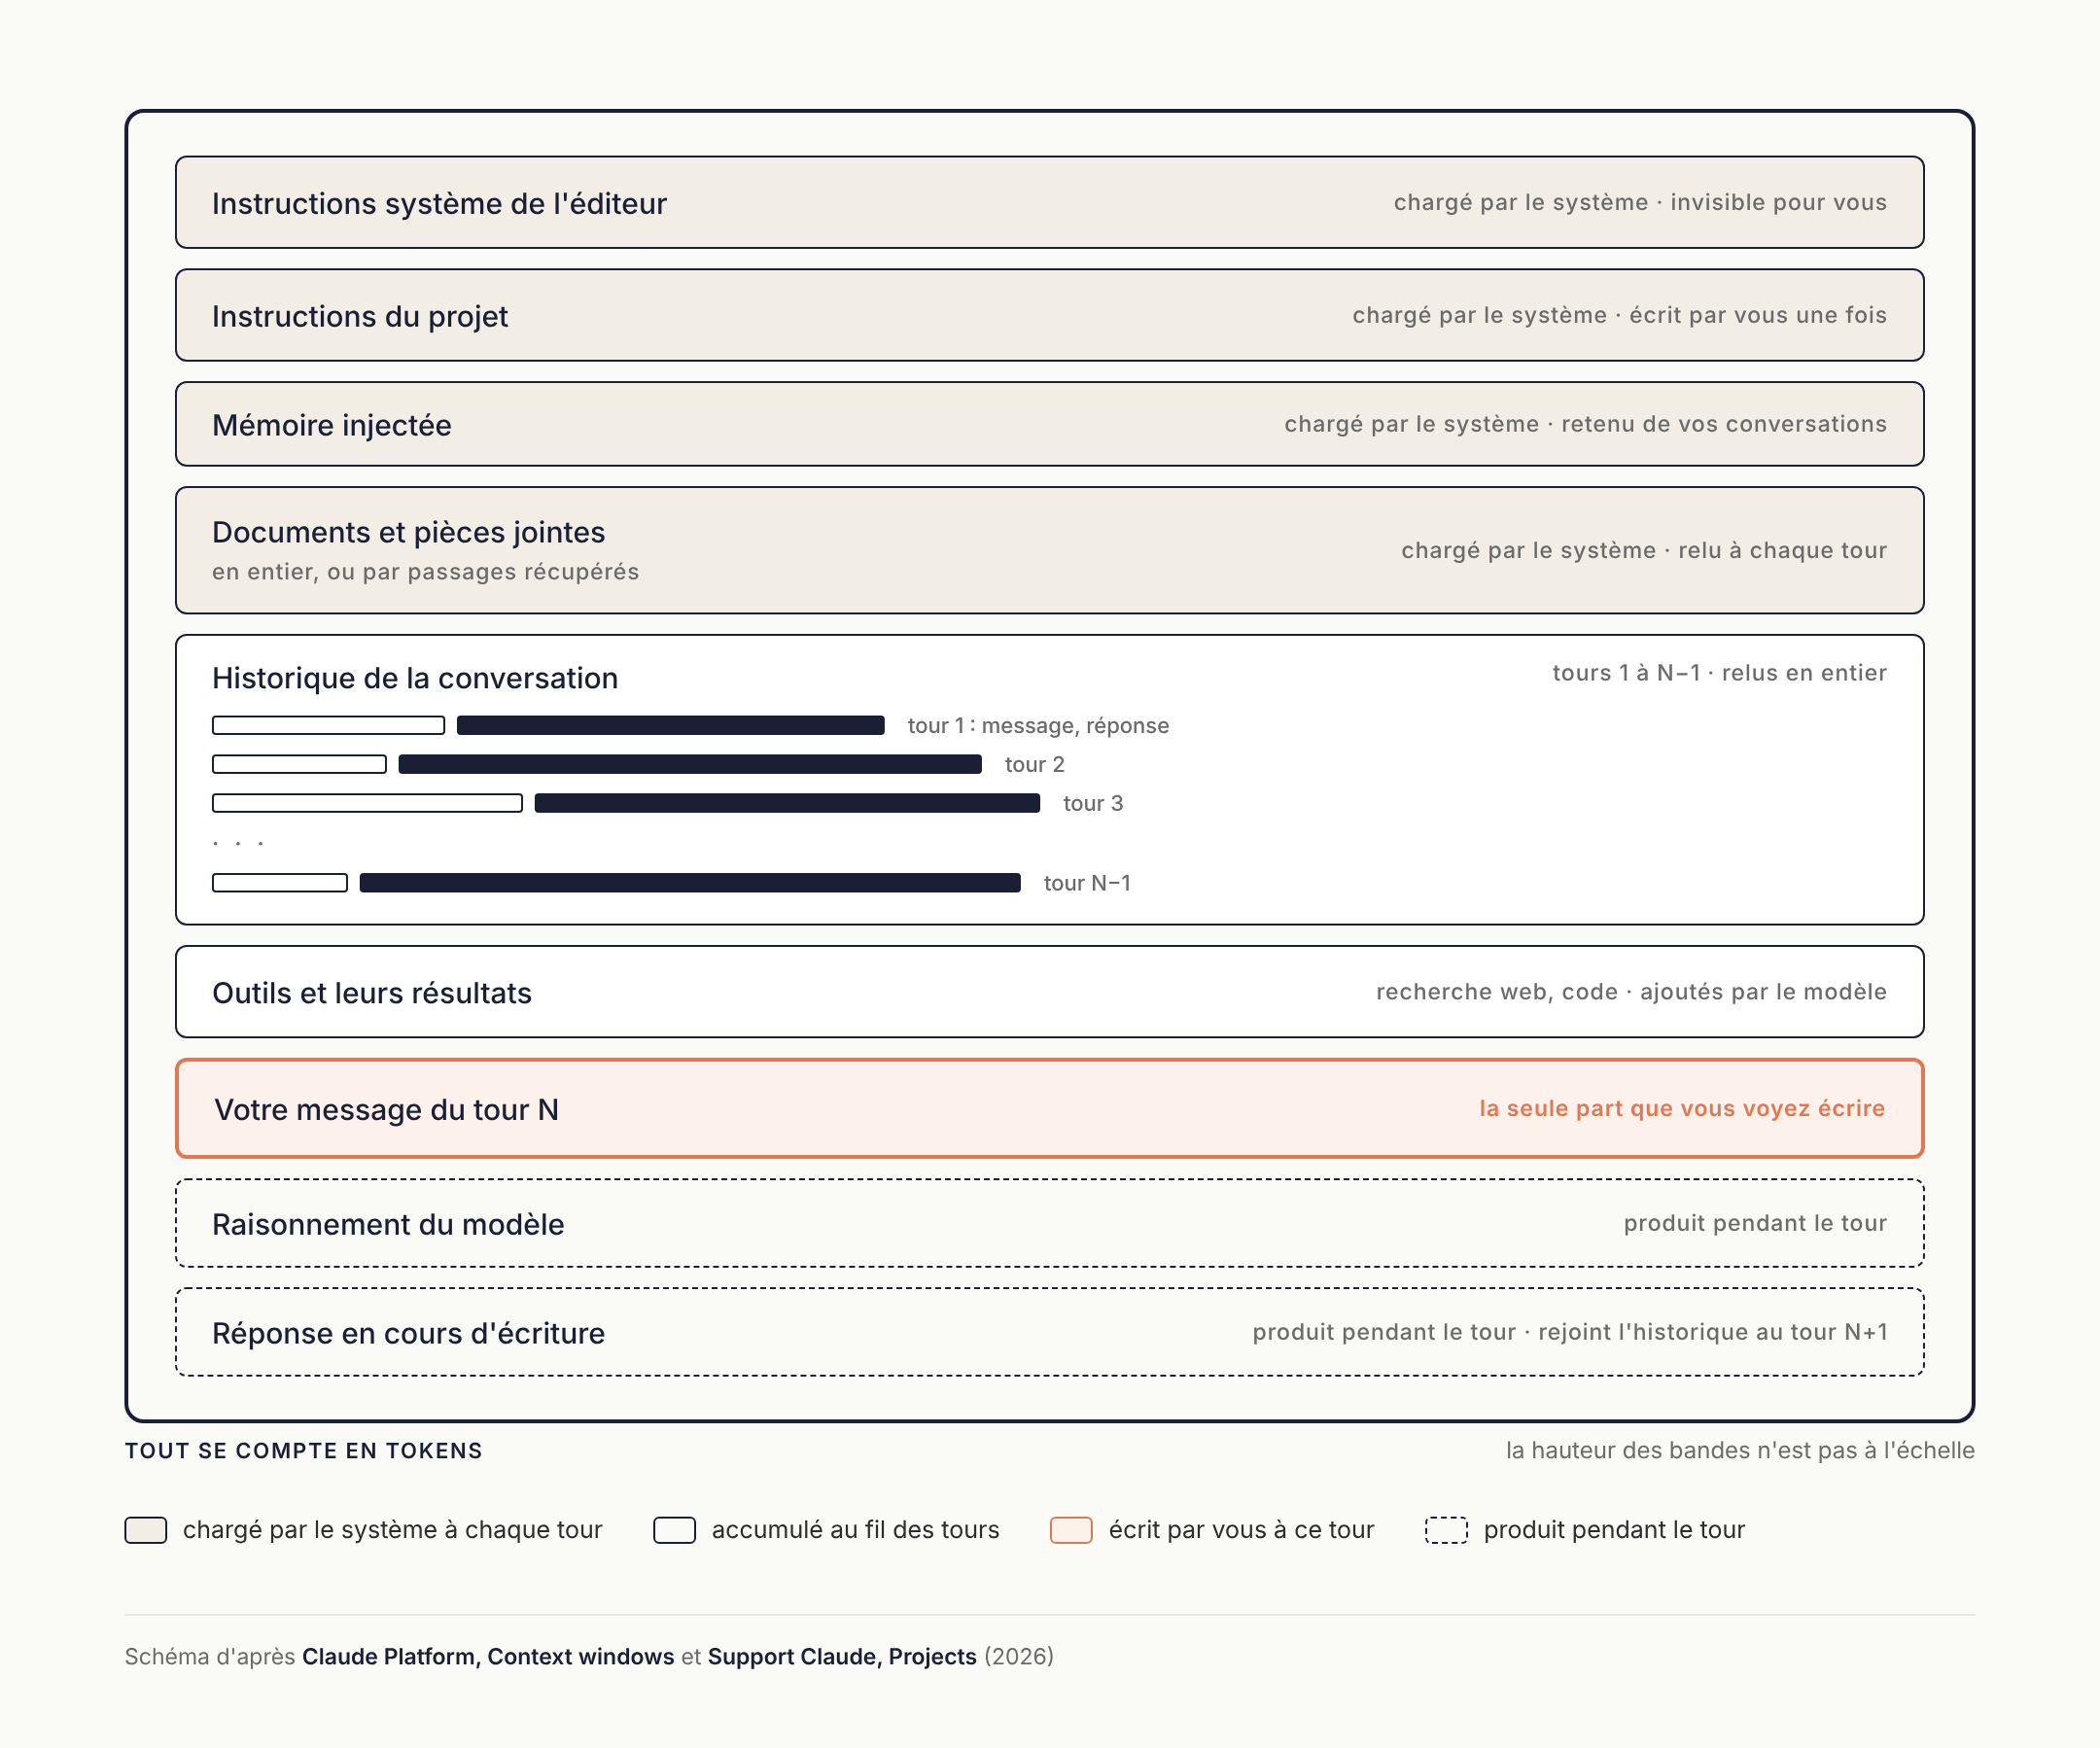
La fenêtre de contexte avoisine le million de tokens sur les modèles récents de Claude et de Gemini et généralement votre message n'en représente qu'une infime partie.
Comment la fenêtre de contexte se remplit à chaque tour ?
Une conversation qui dure et qui ne se termine pas, voire qui a dérivé du sujet initial prend un risque important en termes d’efficacité de travail.
Bien définir le contexte d'une conversation et anticiper sa fin est tout aussi important que la qualité du prompt initial.
La conversation est intégralement relue à chaque tour
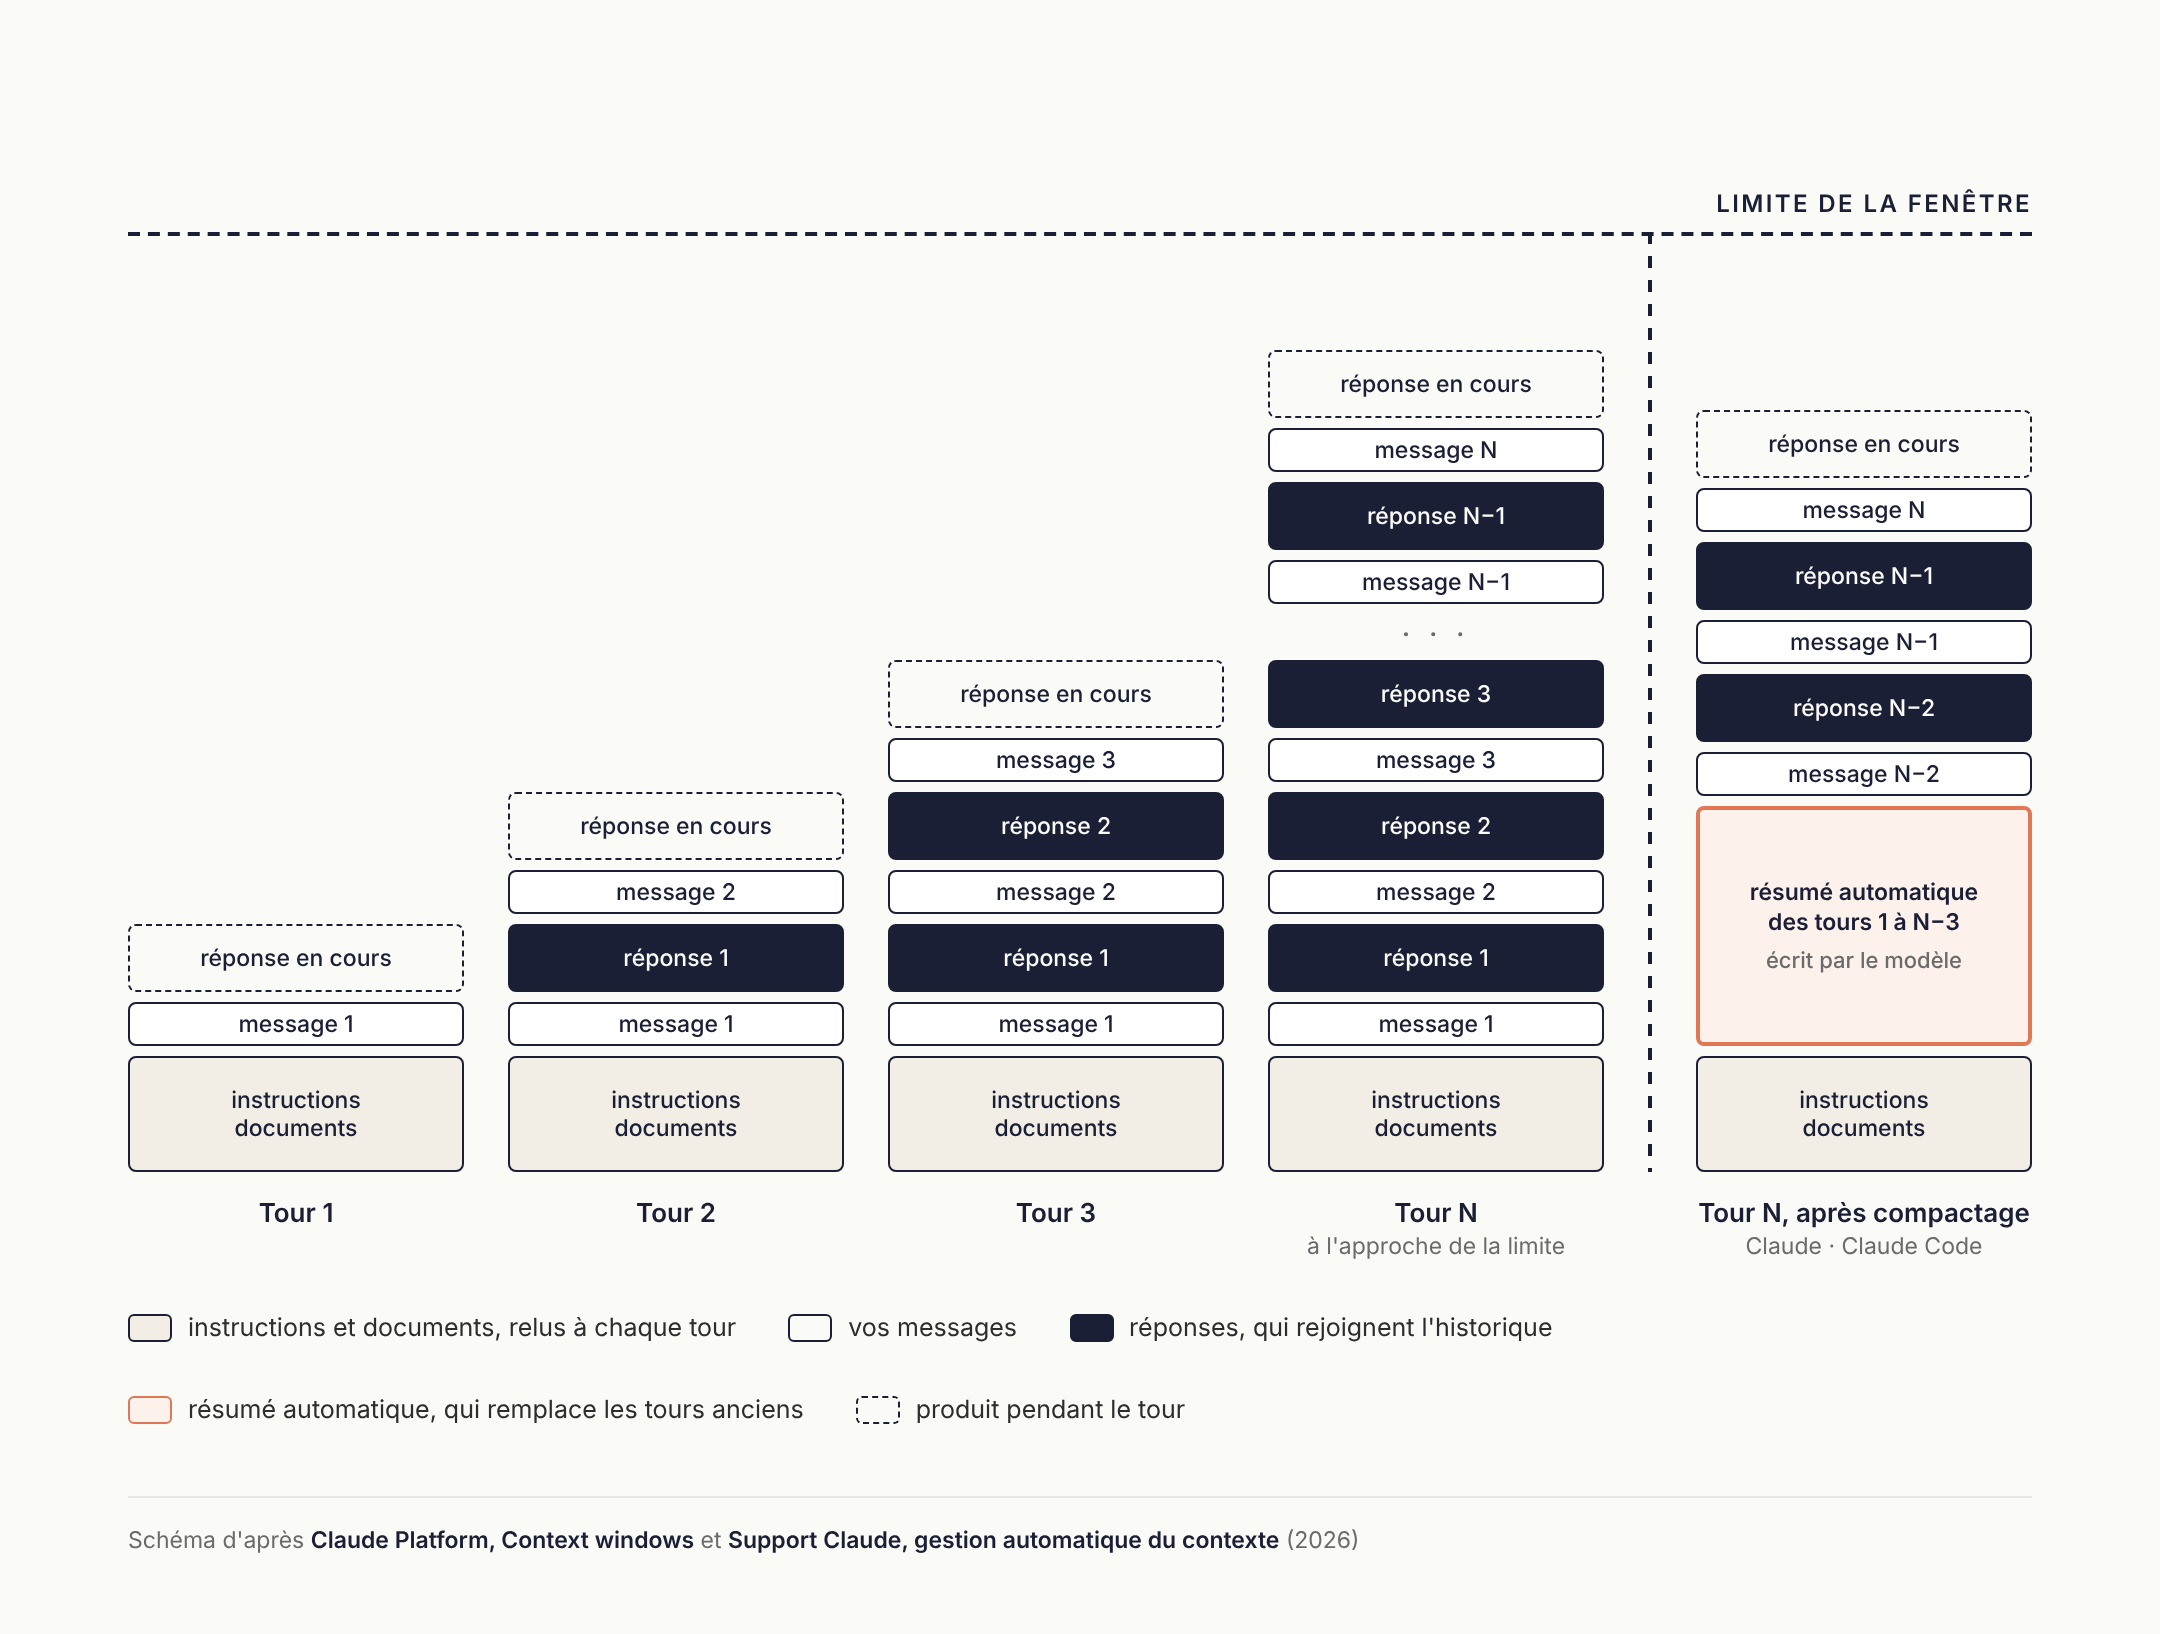
On peut ne pas s'en rendre compte, mais chaque tour de conversation impose pour le modèle une relecture complète depuis le début. Le cumul de texte à chaque tour qui se succède augmente le contenu à lire et rapproche la conversation de la limite de la fenêtre de contexte.
Ce principe est une des clés pour comprendre pourquoi le modèle peut rapidement perdre de sa performance si la conversation n'est pas correctement cadrée dès le départ. Il est documenté par Anthropic sur son site, en expliquant que chaque message et chaque réponse s'accumulent dans une fenêtre et que chaque tour précédent est conservé.
Le raisonnement compte également à chaque tour
Le raisonnement du modèle, quand il réfléchit avant de répondre et qui dépend aussi du contexte du projet rapproche la conversation de la limite de la fenêtre.
Ce n'est donc pas uniquement une question du volume de texte produit dans la conversation, une part importante non visible affecte la conversation et vous rapproche de la limite.
Les pièces jointes sont aussi relues à chaque tour
Mettre une donnée en pièce jointe ne permet pas d'éviter la fenêtre, car ces pièces sont systématiquement lues au même titre que le prompt initial. Si cette pièce jointe contient beaucoup d'informations peu utiles, un gaspillage se fera ressentir sur les performances.
Dans un contexte exigeant, l'optimisation des pièces jointes compte beaucoup.
Le format distribué au modèle joue également pour beaucoup, car un PDF consomme davantage de tokens qu'un fichier Markdown et si vos ressources n'ont pas été converties au préalable, votre qualité d'analyse n'en sera qu'inférieure.
La pièce jointe est donc bien un élément qui entre dans la fenêtre autant que la conversation elle-même. Si vous mesurez cette fenêtre, il faut en tenir compte.
Deux annexes types font exception :
- Les fichiers du projet qui vont au-delà de la limite de la fenêtre
- Les fichiers lus par du code ou des exécutions de scripts
À la limite, deux situations peuvent se produire
Quand la limite est atteinte, on ne le voit pas par une mesure visuelle, mais par un message soudain. Pour des profils gratuits sur ChatGPT par exemple, cela peut être un message qui bloque la poursuite de la conversation.
Une solution plus courante, pour les comptes payants, est la compression des conversations par résumé. Claude va, par exemple, compacter des passages de texte en résumé pour créer de la place.
Le compactage des conversations
Le compactage des conversations est un procédé fréquent, que vous pourrez voir très souvent, notamment sur Claude.
À un moment précis, la conversation se coupe et un chargement se lance, c'est le compactage et ce procédé résume des bouts de conversations qui proviennent des tours précédents. C'est à ce moment qu'il faut se questionner sur la clôture d'une conversation.
Ce qu'il faut savoir et ce que confirme la documentation d'Anthropic, c'est que le compactage n'est pas un procédé que vous maitrisez. C'est Claude qui le fait et l'impose pour répondre aux exigences et limitations techniques.
C'est la raison précise pour laquelle, il est important d'anticiper ce fonctionnement qui peut nuire au contexte d'analyse qui peut être exigeant.
Le moment critique est si ce procédé se répète plusieurs fois, générant des résumés de résumés et l'information peut sérieusement se dégrader. Une information clé peut se perdre et une directive peut aussi être oubliée. Ce sont les détails qui disparaissent en premier, et ce, quelle que soit son importance pour le projet que vous menez.
C'est un fonctionnement natif de Claude qui évite le blocage radical d'une conversation. C'est un compromis au prix d'une perte de précision.
C'est donc à l'utilisateur de considérer cette limite avant de lancer un projet ambitieux et savoir à quel moment on bascule d'une conversation à une autre et comment on le fait sans perte.
Le context rot quand la limite de la fenêtre est atteinte
La fenêtre de contexte se remplit à chaque conversation et à l'approche de la limite, avant même toute procédure de compactage, la qualité peut déjà subir une dégradation et on peut ne pas s'en rendre compte selon le contexte.
Cette perte de qualité constatée désigne le context rot, qui correspond à une baisse de capacité du modèle à retrouver une information lorsque le contexte s'allonge.
Quand le modèle lit l'ensemble de la fenêtre, mais pas de façon uniforme
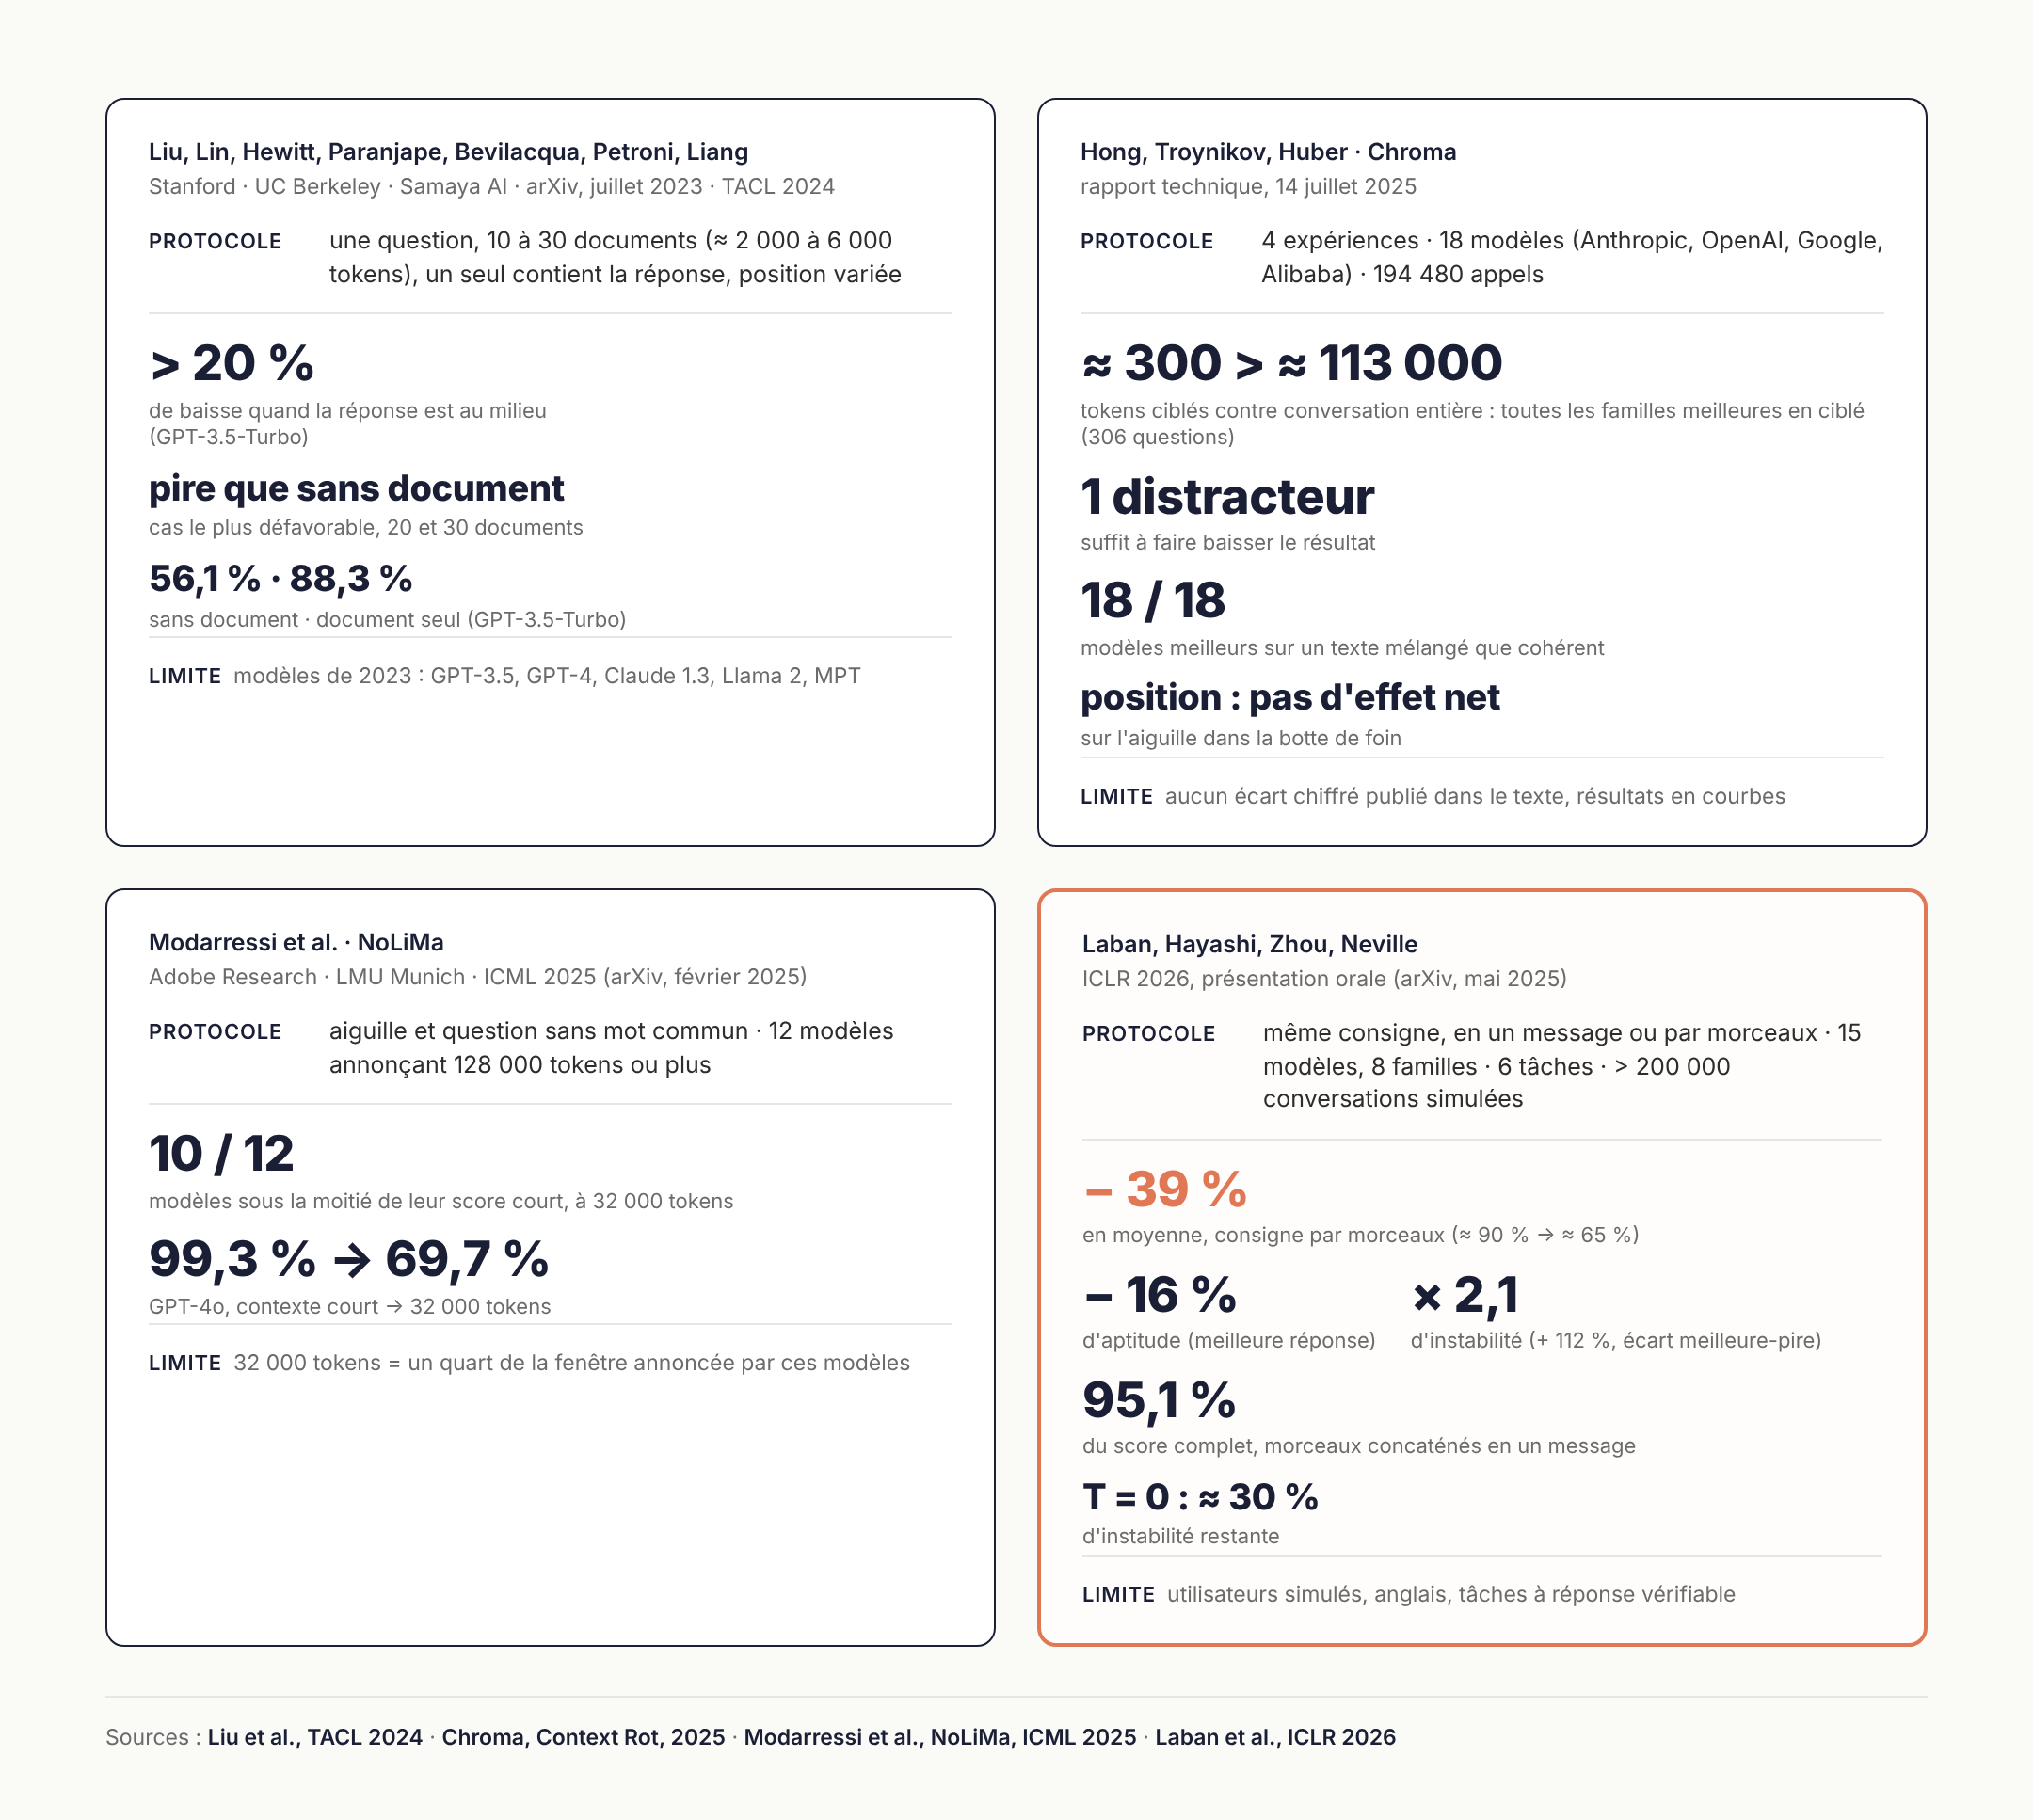
Ce problème de "context rot" a été posé par une équipe de chercheurs en 2025 dans un rapport technique puis a été repris dans la documentation d'Anthropic. Il désigne une baisse de capacité du modèle à retrouver une information dans le contexte posé à mesure que ce dernier s'allonge tour après tour.
On ne parle pas d'une information qui disparait, mais qui perd en poids sur l'ensemble. Il est provoqué par le mode de fonctionnement d'un LLM et sa manière de lire. Chaque token est lu puis mis en relation avec les autres et plus cet ensemble grandit dans le contexte, plus il est difficile pour le modèle de prêter son attention à une information spécifique. Anthropic parle notamment d'un budget d'attention qui correspond à une capacité limitée que chaque token vient consommer.
C'est la raison pour laquelle la qualité peut se dégrader avant même que la limite soit atteinte et c'est à ce niveau que la difficulté réside le plus.
Les quatre types de dégradations possibles liés au context rot
L'équipe de Chroma a effectué une mesure réelle de cette dégradation par le context rot sur dix modèles différents, parmi les grands éditeurs, avec un protocole spécifique pour chacun.
Les causes identifiées sont isolées et ne s'additionnent pas.
- La longueur : premier facteur évident de dégradation qui s'aggrave avec des échanges longs et en grand nombre qui accumule du contenu progressivement et très rapidement.
- Les mots communs : quand la question ne reprend pas les mots de l'information cherchée, le modèle la retrouve moins bien.
- Les distracteurs : Ils correspondent à un passage qui peut induire en erreur le modèle quand ce dernier détourne l'attention du modèle au mauvais endroit.
- La structure du texte : quand le contenu dans le contexte est davantage déstructuré rend la lecture plus difficile. L'information peut plus facilement se noyer dans le contenu global.
On peut le comprendre très vite, quand le contexte est occupé par un contenu mal structuré, avec beaucoup de dérive sémantique, de distracteurs, le modèle s'expose à des risques plus importants de dégradation.
Le context rot n'est donc pas uniquement une question de limite en tokens, mais de structure et de sémantique. Une conversation mal cadrée, qui dérive sur son sujet s'expose davantage à ce risque.
Les autres mécanismes qui dégradent la qualité
Les études sur le context rot ne se sont pas arrêtées là et se rejoignent souvent avec les précédentes formant une série de pièges à éviter et donc de bonnes pratiques que nous verrons après.
- L'information perdue au milieu : ce critère n'a pas été remonté par l'équipe de Chroma, mais a été mesuré en 2023. Le début et la fin des contenus sont davantage lus que les passages au milieu d'un texte. Une information située en milieu peut s'exposer plutôt au context rot.
- Les erreurs : une information qui laisse propager une erreur dans l'ensemble du contexte pouvant provoquer des problèmes d'analyse.
- L'absence de raisonnement : lorsque le modèle cesse de raisonner sur une information pensant qu'elle est validée (par effet de répétition dans le contexte).
- Les informations superflues : elles noient le sujet de l'analyse et détournent l'attention du modèle sur le sujet d'analyse.
- Les conflits d'informations : lorsque que des informations contradictoires entravent la décision.
- L'absence de validation de l'utilisateur : lorsque le modèle prend une décision sans validation préalable ce qu'il fera plutôt dans un contexte chargé.
Certaines causes sont confirmées et d'autres non
De nombreuses causes sont confirmées par des études et d'autres non. Il faut donc agir surtout par logique sachant que le fonctionnement répond à des règles proches de celles qu'on utilise pour optimiser une page.
La cause qui revient et se confirme est la non-uniformité. Le contexte doit rester lié à son sujet et éviter la dérive provoquant une dégradation nette de la qualité.
Les autres causes sont à prendre de manière plus théorique, mais il reste intéressant de les appliquer, car même sans preuve de leur impact, elles peuvent jouer sur la performance sans le savoir.
Ce que ça change sur le chargement de la fenêtre de contexte
Plusieurs éléments vont donc directement affecter la qualité de la réponse du modèle. Cela concerne aussi bien l'utilité des ressources que vous partagez au modèle, qui peuvent devenir une distraction plutôt qu'une ressource utile. Un brief mal formulé ou décorrélé de ses annexes pouvant créer des écarts au niveau sémantique.
Enfin, un document brut non nettoyé et surchargé d'informations va à l'évidence noyer le modèle dans un "trop-plein" d'informations.
La dérive du modèle sur les longues conversations
Le sujet d'une question peut dériver plus ou moins facilement selon comment il est introduit. Une demande large, mal contextualisée et sans périmètre défini peut chercher un résultat trop ambitieux. L'absence de cadrage cause généralement des dérives et le modèle va répondre à côté et provoquer une baisse importante de la plus-value apportée.
Une instruction découpée en morceaux peut accroitre cet effet
Si les instructions de votre demande arrivent en plusieurs messages séparés contre un premier message complet du premier coup, la différence pour le modèle n'est pas anodine.
Une équipe de Microsoft et de Salesforce a réalisé une étude en 2025 qui a été présentée à l'ICLR en 2026. Le protocole du test a comparé une même tâche transmise au modèle de deux façons différentes : en un seul morceau puis en plusieurs morceaux consécutifs. En comparaison, le cas envoyé en un seul morceau se montre davantage concluant.
L'ensemble des modèles sont affectés par ce test et l'explication donnée à ce test ne pointe pas la perte d'information comme cause. L'explication concrète tient surtout à la conversation elle-même et non son contenu.
En résumé, envoyer une instruction en un seul tour contre une approche multitours change beaucoup ce qui implique une gestion du nombre de tours comme levier d'optimisation de la fenêtre.
La dérive multitours n'altère pas la capacité, mais la fiabilité
L'étude distingue deux choses : la capacité du modèle, d'un côté, qui baisse peu sur ce test et de l'autre la fiabilité sur des tests répétés qui est nettement plus basse sur l'approche multitours.
Un sujet bien posé est conditionné par un premier prompt efficace et bien écrit.
Un prompt complet réduit la relecture successive qui dégrade la qualité finale. Le risque de dérive est donc augmenté par cette multiplication des échanges. Une demande doit donc se formuler de façon complète dès le premier tour avec un enjeu fort d'anticipation sur les conditions de la demande.
Être en mesure d'anticiper ces prérequis améliore l'efficacité du modèle.
Quatre causes de la dérive due à la conversation
Les auteurs de l'étude pointent différentes causes liées aux conversations qui conduisent à une dérive :
- Une réponse donnée trop tôt : un prompt incomplet auquel le modèle va répondre malgré un déficit évident et cause une perte d'efficacité qui va imposer des allers-retours supplémentaires
- Le modèle s'appuie sur sa réponse précédente : cette situation se produit quand le modèle se raccroche à une réponse déjà fournie, mais qui nécessite d'être revue. Au lieu de partir de zéro, il tente un recyclage de la réponse et dérive
- Le modèle néglige les informations situées au milieu : situation qui se produit si la conversation a déjà produit plusieurs tours et que les informations essentielles n'étaient ni au début ni au dernier tour.
- Une réponse du modèle trop dense dès le départ : le modèle se lance dans une réponse exhaustive dès le début sans attendre d'avoir toutes les données, il se répète et alourdit inutilement la conversation.
Un apprentissage qui ressort de cette étude est qu'un mauvais démarrage de conversation ne se rattrape pas facilement. À ce moment, la question d'un reboot de la conversation est une solution à envisager.
Ce que cette analyse implique concrètement
Par cette analyse et ses constats, vous reconnaitrez peut-être des situations que vous avez connues.
La qualité de réponse reste cependant subjective selon vos exigences et c'est pourquoi il faut prendre du recul sur le résultat final. Est-il satisfaisant selon vos attentes ?
Je recommande pour ma part une préparation à chaque session en fonction des enjeux attendus. Une analyse complexe doit s'organiser efficacement et anticiper les besoins que le modèle ne vous demandera pas forcément.
Ne laissez pas le modèle décider, ce qu'il ne fera certainement pas selon les situations.
Clôturer une session efficacement en un minimum de tours reste un challenge, mais peut permettre d'améliorer vos résultats.
La fenêtre de contexte sur les quatre systèmes IA du marché
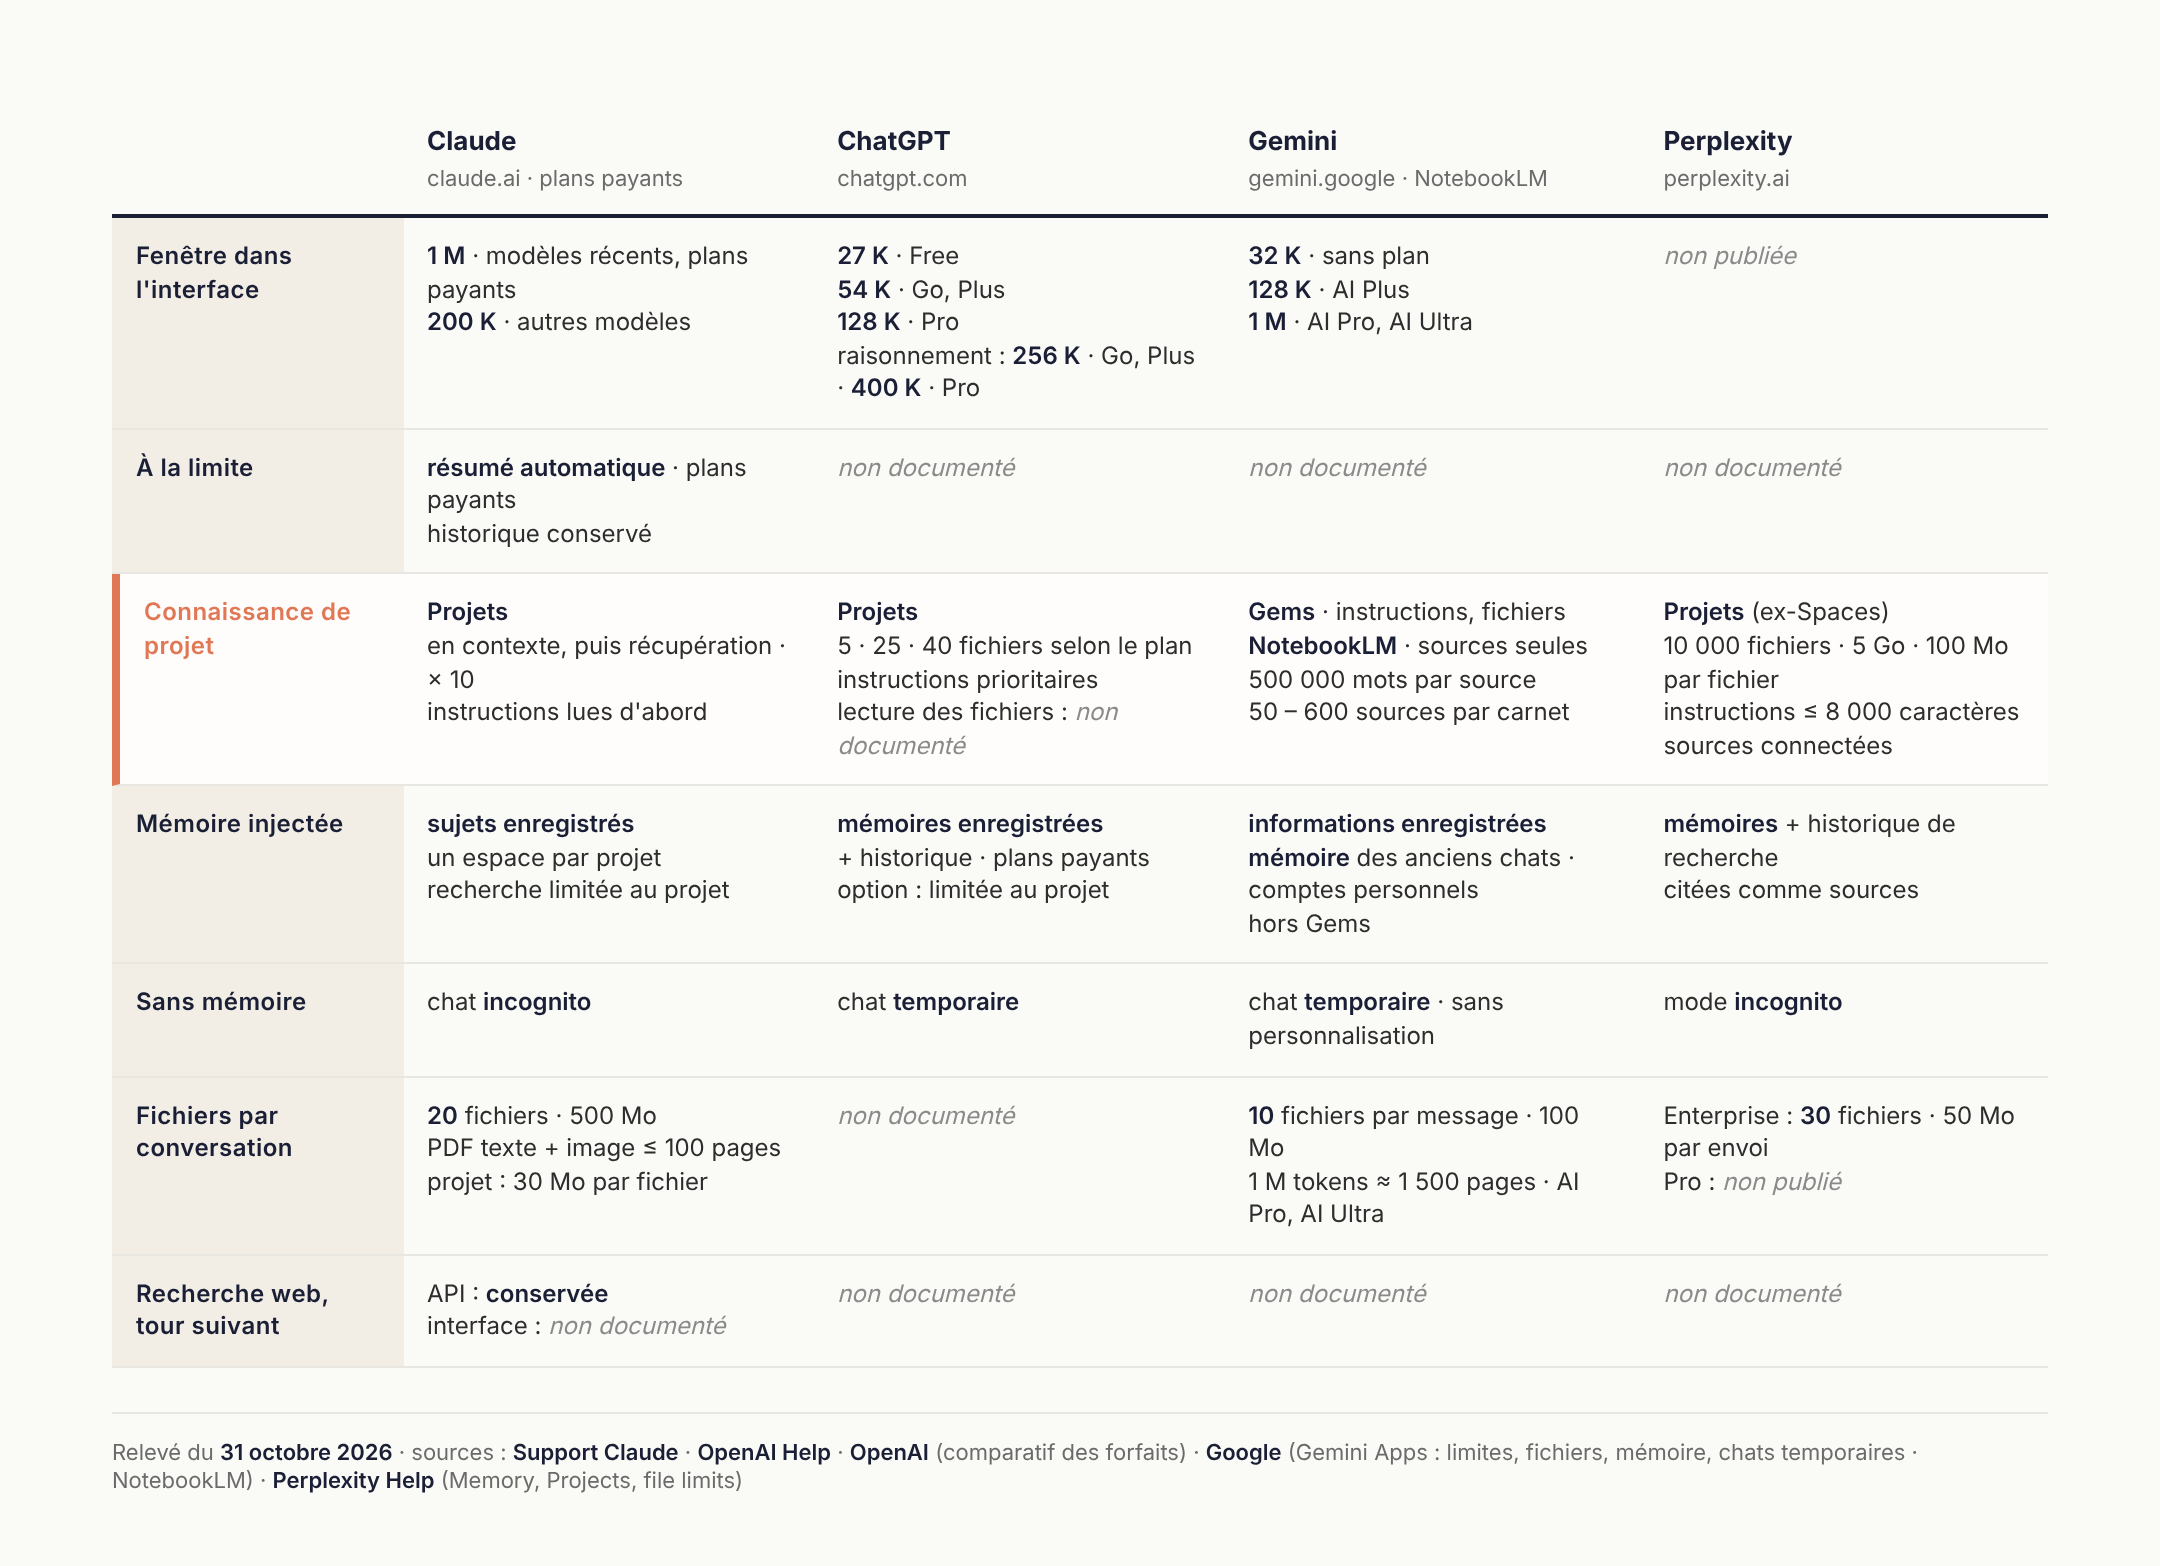
Chaque modèle dispose d'une fenêtre de contexte différente selon le plan d'abonnement que vous avez choisi. Le comportement quand la fenêtre a atteint sa limite n'est également pas le même.
Chaque système va se distinguer sur plusieurs critères :
- La taille de la fenêtre (qui peut différer d'un plan gratuit ou payant)
- Le comportement face à la limite : blocage ou résumé
- Knowledge base : entièrement chargée ou partiellement
- La mémoire du projet
- L'accès aux autres conversations du projet
- Les fichiers partagés dans les conversations
- Les connecteurs proposés par le système
Ce sont autant de critères qui peuvent affecter la fenêtre, mais pas de la même façon sur les modèles, la documentation nous en apprend un peu, mais certains points restent sans confirmation.
Claude se caractérise par le résumé des conversations
Ce qui caractérise Claude sur la gestion de la fenêtre est son système de compactage que tous les autres modèles ne proposent pas et certains ne documentent pas leur fonctionnement. Claude procède donc à une compression signalée à l'utilisateur nécessitant un chargement de quelques instants. Ce chargement n'est pas signalé par anticipation, mais il représente un signal pour l'utilisateur que sa fenêtre est atteinte.
Sur les modèles récents de Claude, elle survient à l'approche du million de tokens sur les modèles récents des plans payants ce qui laisse le moyen de terminer une conversation sans atteindre la limite si on gère bien la conversation et ce qu'elle sollicite comme ressource.
Claude propose de nombreuses fonctionnalités qui consomment des tokens, comme les connecteurs. Il faut donc prendre en compte tous ces aspects.
Claude est le modèle que j'ai choisi pour différentes raisons :
- Sa fenêtre de contexte parmi les plus grandes du marché
- Le résumé automatique des conversations
- Une knowledge base partiellement sollicitée à chaque tour
- Une mémoire projet
- Un partage de fichier qui peut aller jusqu'à 500 Mo par fichier
Une fenêtre plus restreinte chez ChatGPT
Les différents plans payants de Chat GPT le montrent clairement, la fenêtre dépend du plan et elle est plus basse que celle de Claude. Cette allocation gère une répartition entre les instructions du système et la mémoire interne.
ChatGPT ne propose pas la compression des conversations à l'atteinte de la limite, une conversation doit donc fermer à ce moment.
Les projets ChatGPT permettent d'entrer des fichiers, mais la documentation ne confirme pas si le projet est chargé dans le contexte ou par récupération.
Ce que cette donnée implique sur le choix du modèle
Je ne vais pas détailler chaque spécificité des différents modèles sachant que ces caractéristiques changent très vite. Le plus important est de comprendre comment ces spécificités servent l'intérêt de vos projets.
Chaque système IA présente des différences sur sa capacité et ses fonctionnalités. Je pense que le choix doit se baser sur la nature du travail que vous ferez. Si vous prévoyez de longues tâches difficiles, Claude est un bon choix, car il propose une fenêtre parmi les plus importantes avec un comportement intuitif face aux limitations.
Ne pas être bloqué par la limitation reste un avantage même si la qualité peut être remise en question.
Sa gestion intelligente de la knowledge base est également un critère qui m'a orienté vers Claude avec le moyen de déployer une base conséquente, sans que celle-ci soit sollicitée à chaque tour de conversation.
Quel impact sur votre routine de travail ?
Tout ce qu'on vient de dire sur la fenêtre de contexte la ramène à ce qu'Anthropic appelle le "budget d'attention". Votre méthodologie compte davantage que les capacités du modèle, elle définit votre stratégie d'optimisation des sessions de travail.
Le cadrage des conversations
La qualité et l'efficacité de vos prompts ainsi que votre approche structurelle joue un rôle important pour mener à bien un projet de la meilleure façon possible. Je vous donne ici quelques règles de base que j'applique et qui peuvent améliorer la qualité de vos travaux.
- Une conversation par tâche : c'est une règle simple, mais qui peut très vite être oubliée surtout si la tâche en implique elle-même plusieurs. Il faut anticiper l'effort et les ressources impliquées par la tâche. Vous devez pouvoir pré estimer le nombre de conversations requises pour ce projet.
- Le brief complet déjà préparé : Il ne faut pas partir avec des approximations, mais avec une demande précise qui anticipe les sous questions et qui limite les allers-retours inutiles. Il ne faut pas oublier que chaque tour obligera le modèle à relire l'ensemble de la conversation.
- Donner des consignes au modèle dès le départ : vous pouvez demander au modèle de ne pas répondre avec de grands textes ou de ne pas chercher tout de suite un document lourd sur la knowledge base. L'erreur que le modèle est susceptible de faire peut être anticipée par des règles que vous placez dans votre prompt ou dès les instructions du projet.
- Recommencer la session si le modèle dérive : si vous ressentez une difficulté ou que les résultats sont décevants, recommencer une session est généralement le meilleur choix. Il faut cependant bien étudier ce qui a provoqué la dérive du modèle et à quel moment une baisse de performance s'est fait ressentir.
Gérer les ressources externes
Les ressources externes peuvent affecter la fenêtre, il faut appliquer certaines règles.
- Identifier les ressources utiles : Il faut éviter de transmettre un dossier complet d'annexes quand une partie suffit. Un export des logs serveur ou un rapport analytique est-il utile dans son intégralité ? Il faut donc filtrer ce qui est utile de ce qui ne l'est pas avant même la session.
- Optimiser le format des ressources : un fichier Markdown consomme moins qu'un PDF. Une phase de conversion de vos fichiers lourds peut être faite avant la session de travail pour optimiser la performance d'analyse.
- Accompagner les ressources d'instructions dans le prompt : cela permet au modèle de se concentrer sur ce qui est utile et d'éviter un oubli au moment de l'analyse.
Chaque ressource partagée doit donc être optimisée, utile pour la session et accompagnée d'instructions claires et précises.
Extraire les données utiles
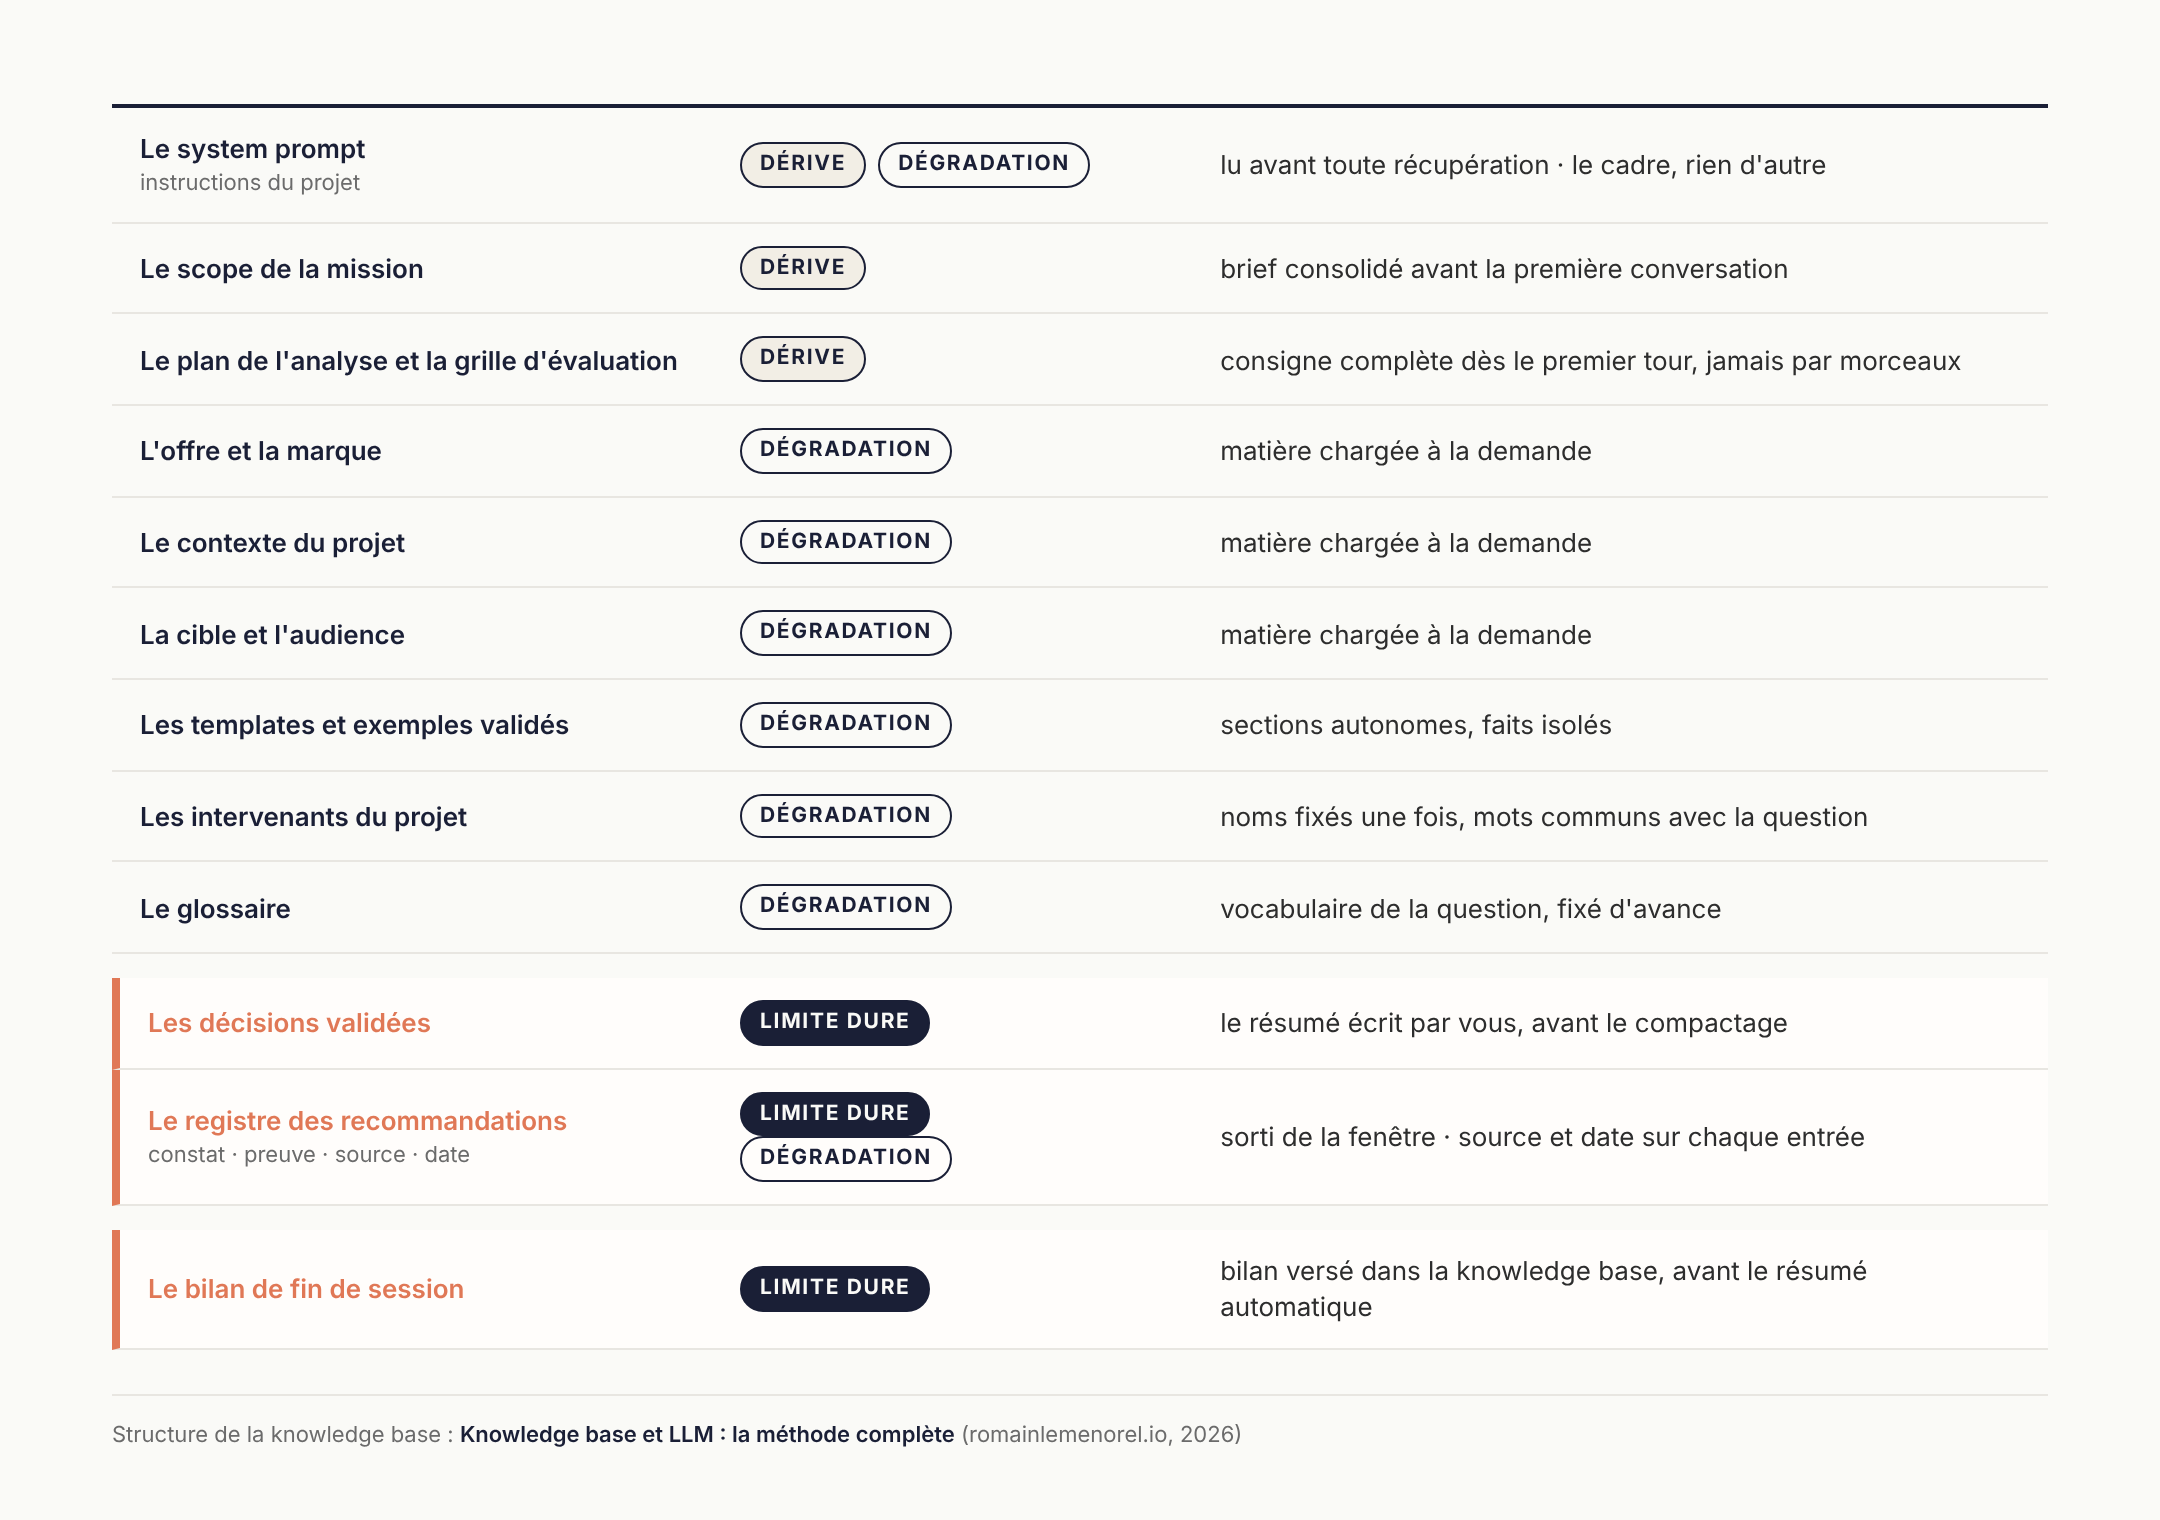
Dès qu'une information importante arrive, elle doit être consignée dans le projet et conservée en cas de compression ou de dérive qui peut survenir plus tard.
Un fichier de la knowledge base doit servir à cet usage, chaque apprentissage ou note doit être conservée dans un fichier. Ce même fichier peut ensuite être réorganisé ultérieurement.
Cette pratique permet de conserver les éléments clés et de garder un acquis si la conversation venait à se dégrader ensuite.
Ce qu'il faut retenir de la fenêtre de contexte
La fenêtre de contexte est un mécanisme structurant des systèmes IA que les éditeurs affichent dans leurs offres commerciales. Ce n'est pas pour rien que cette caractéristique pèse autant que l'intelligence du modèle selon le travail qu'on réalise. Je pense d'ailleurs qu'il s'agit souvent d'un critère sous-évalué dans le choix du modèle.
Bien comprendre ce mécanisme permet de remettre en question des sessions qui n'ont pas obtenu la qualité que vous espériez. La capacité du modèle n'en est pas nécessairement la cause.
La pratique des projets, de la knowledge base et des conversations représente un facteur déterminant dans cette optimisation. Pour les tâches récurrentes que vous souhaitez optimiser, il faut identifier chaque élément susceptible de dégrader la qualité et optimiser sur différents axes possibles : le prompt, les ressources partagées, les instructions ou encore la knowledge base.
C'est la raison pour laquelle j'intègre tous ces aspects dans mon framework, car ces optimisations portent autant, voire plus que la grille d'évaluation que j'ai définie pour mes audits.
Sources :
 Anthropic



 Ali Modarressi
 Kiran Kate
 Drew Breunig